登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,实现高效视频问答推理。该镜像集成FlashAttention-2技术,可加速Qwen2-VL模型的推理速度达2.3倍,显著提升视频内容理解效率,适用于智能客服、教育视频分析等场景。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,实现高效的长视频理解任务。该镜像专为计算密集型任务优化,支持InternVideo2-13B等大模型,适用于教育视频分析、影视内容理解等场景,显著提升处理效率与准确性。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8深度学习镜像,实现AI数字人直播推流、实时字幕生成和情感视频制作。该镜像提供开箱即用的深度学习环境,特别适用于电商直播、多语言内容创作等场景,显著提升视频内容生产效率。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,并运行InternVideo2视频理解模型进行视频分类和动作检测。该镜像专为高性能计算优化,可快速处理视频内容分析任务,适用于智能监控、内容审核等场景,显著提升视频理解效率。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,实现高效视频问答功能。该镜像经过深度优化,支持Qwen2-VL-MoE等多模态模型部署,实测视频问答响应时间低于800ms,适用于实时视频分析、智能客服等场景。
本文介绍了如何在星图GPU平台上自动化部署EasyAnimateV5-7b-zh-InP镜像,实现视频超分辨率功能。该技术能够将模糊的低分辨率视频进行画质增强,清晰还原细节,适用于家庭影像修复、内容创作素材提升等场景,让老旧或低清视频焕发新生。
一种简单得令人惊讶的方法,只需将现有的短视频素材重组,就能在不增加计算成本的前提下显著提升AI对长视频的理解能力。斯坦福大学、微软研究院和威斯康辛大学团队,提出了VideoWeave数据中心化方法。不需要发明新的复杂架构,也不需要耗资巨大的新标注,仅仅通过改变喂给模型的数据组织形式,就能让AI变得更聪明。训练视频语言模型一直是个烧钱的苦差事。相比于静态图像,视频多了一个时间维度,处理一秒钟的视频往
本文深入解析了BasicVSR++在视频超分领域的革新应用。该模型通过引入光流引导的可变形对齐技术,显著提升了帧间对齐的精准度与鲁棒性;同时采用二阶网格传播机制,构建了高效的时空信息交换网络,从而在复杂运动与遮挡场景下实现了更清晰、更稳定的超分辨率重建效果。
本文深入探讨了DCN-v2在视频超分辨率技术中的关键作用,从EDVR到BasicVSR++的技术演进。通过分析可变形卷积的调制机制和多层级堆叠策略,揭示了DCN-v2如何有效解决大运动场景对齐和遮挡区域伪影问题。实战部分提供了参数配置建议和性能对比,展示DCN-v2在PSNR指标上的显著优势,为视频超分领域的研究与应用提供了重要参考。
从双流网络的“分而治之”到3D卷积的“端到端学习”,再到如今融合注意力与Transformer的“全面感知”,视频行为识别技术在短短十年间经历了飞跃式的发展。双流网络教会了我们如何显式地利用运动信息,3D卷积教会了我们如何隐式地学习时空特征。而今天的优秀模型,往往是在深刻理解这两种思想的基础上,进行巧妙的融合与创新。展望未来,随着硬件性能的提升和新架构的出现,机器对视频的理解能力将越来越接近人类。
本文深入解析了TDAN网络如何利用可变形卷积实现端到端视频超分辨率。它摒弃了传统光流法,通过隐式学习特征对齐,简化了网络结构,并在Vimeo90K等数据集上取得了优异性能。该方法为视频超分领域提供了一种高效、鲁棒的新范式。
于现今这般随时随地就能发生变化的商业环境里面,营销早就不是单纯的去打广告或者是做那种促销活动了,而是成为了一个把技术、创意以及消费者心理融合起来的繁杂系统工程。企业要是想要在竞争十分激烈的市场当中突出重围,那就一定要懂得而且能够灵活去运用多种营销方法。下面将会深入地去剖析当下处于主流地位的几大营销策略,给你的品牌注入全新的活力。
本文深入解析EDVR视频超分技术的核心创新PCD对齐与TSA融合机制,揭示其如何突破大运动场景下的对齐难题和模糊帧的有效融合问题。通过金字塔级联可变形卷积和时空注意力机制,EDVR在REDS数据集上PSNR指标提升0.8dB以上,为视频重建质量带来质的飞跃。
稀疏注意力机制是深度学习中的关键技术,通过动态筛选重要特征连接来降低计算复杂度。其核心原理是替代传统的全连接注意力,仅保留高相关性的特征交互,在视频理解等时空数据处理任务中尤为有效。这种技术能显著减少GPU内存占用和计算开销,适用于智能监控、内容审核等实时视频分析场景。VideoNSA创新地结合运动显著性和内容相关性检测,实现了更精准的稀疏模式预测,在UCF-101等基准测试中仅需30%计算量即可
AI短剧人脸素材授权系统的核心,是把真人肖像从“素材文件”还原为“有人确认、范围明确、项目可追溯”的授权对象。多放几张可下载图片解决不了这个问题。素材可以被复制,但许可不能靠复制产生。一个严肃的数字演员平台,先要把这件事管住。
昇腾CANN平台上的ops-transformer算子库近期验证了FlashAttention在长视频理解任务中的突破性优化,让VideoMAE-large模型能够一次性处理长达60分钟的视频,而之前的限制是2分钟。视频数据的核心挑战是:每秒视频产生30帧图像,每分钟就有1800帧,Attention计算量是文本的100倍(因为每帧是一个token)。标准FlashAttention的O(N²)复
超分辨率技术是计算机视觉领域的重要研究方向,通过深度学习算法将低分辨率图像重建为高分辨率版本。其核心原理是利用卷积神经网络学习高低分辨率图像间的映射关系,在保持原始内容的基础上恢复丢失的细节。这项技术在视频修复、医学影像、卫星图像等领域具有广泛应用价值。以video2x为代表的工具集成了waifu2x、realESRGAN等先进模型,支持本地离线处理,特别适合老旧视频修复和动漫画质增强。通过合理配
本文深入剖析了视频理解技术的演进历程与核心模型,从早期的双流网络到3D CNN的崛起,再到Transformer在视频领域的应用。重点解析了I3D、TimeSformer等关键模型的创新设计,揭示了视频理解技术从2D空间到3D时空再到时空注意力的发展脉络,为相关领域的研究与实践提供了宝贵参考。
《AI短剧高效制作:知漫剧全流程解析》 知漫剧(zz.jiaxunai.cn)提供一站式AI短剧解决方案,解决角色崩脸、流程碎片化痛点。通过角色特征编码锁定形象,NLP自动分镜+TTS同步配音,28分钟即可生成一集连贯短剧。实测显示:都市情感题材6组分镜一次通过率67%,角色一致性强,口型同步自然。从脚本导入到成片导出全流程闭环,零基础用户可日均产出3-5集。平台整合语义解析、约束生成、视频拼接等
知漫剧AI短剧制作平台通过三大核心技术方案解决内容一致性问题:1. 角色库锁定(特征向量约束)确保角色五官/服饰跨镜头不变;2. 场景描述框(标准化文本编码)保持背景环境连贯;3. 音色绑定(固定speaker embedding)实现声音统一。该平台整合NLP解析、自动分镜、语音合成等技术,提供从脚本到成片的闭环解决方案,支持批量生成时保持三维一致性,显著降低创作门槛。实测显示8分镜短剧的角色/
MotionLLM通过。
视频抠图是数字内容创作中的基础技术环节,传统依赖绿幕和色度键控(Chroma Key)的方案受限于硬件、灯光与后期调优。随着AI视觉理解发展,基于深度学习的时序一致性建模成为新范式——它不再逐帧识别,而是联合分析连续帧的运动轨迹与空间结构,实现发丝级边缘稳定提取。这种技术突破显著降低协作成本与制作门槛,广泛应用于自媒体口播、企业培训、在线教育等轻量级视频生产场景。Unscreen正是该范式的典型落
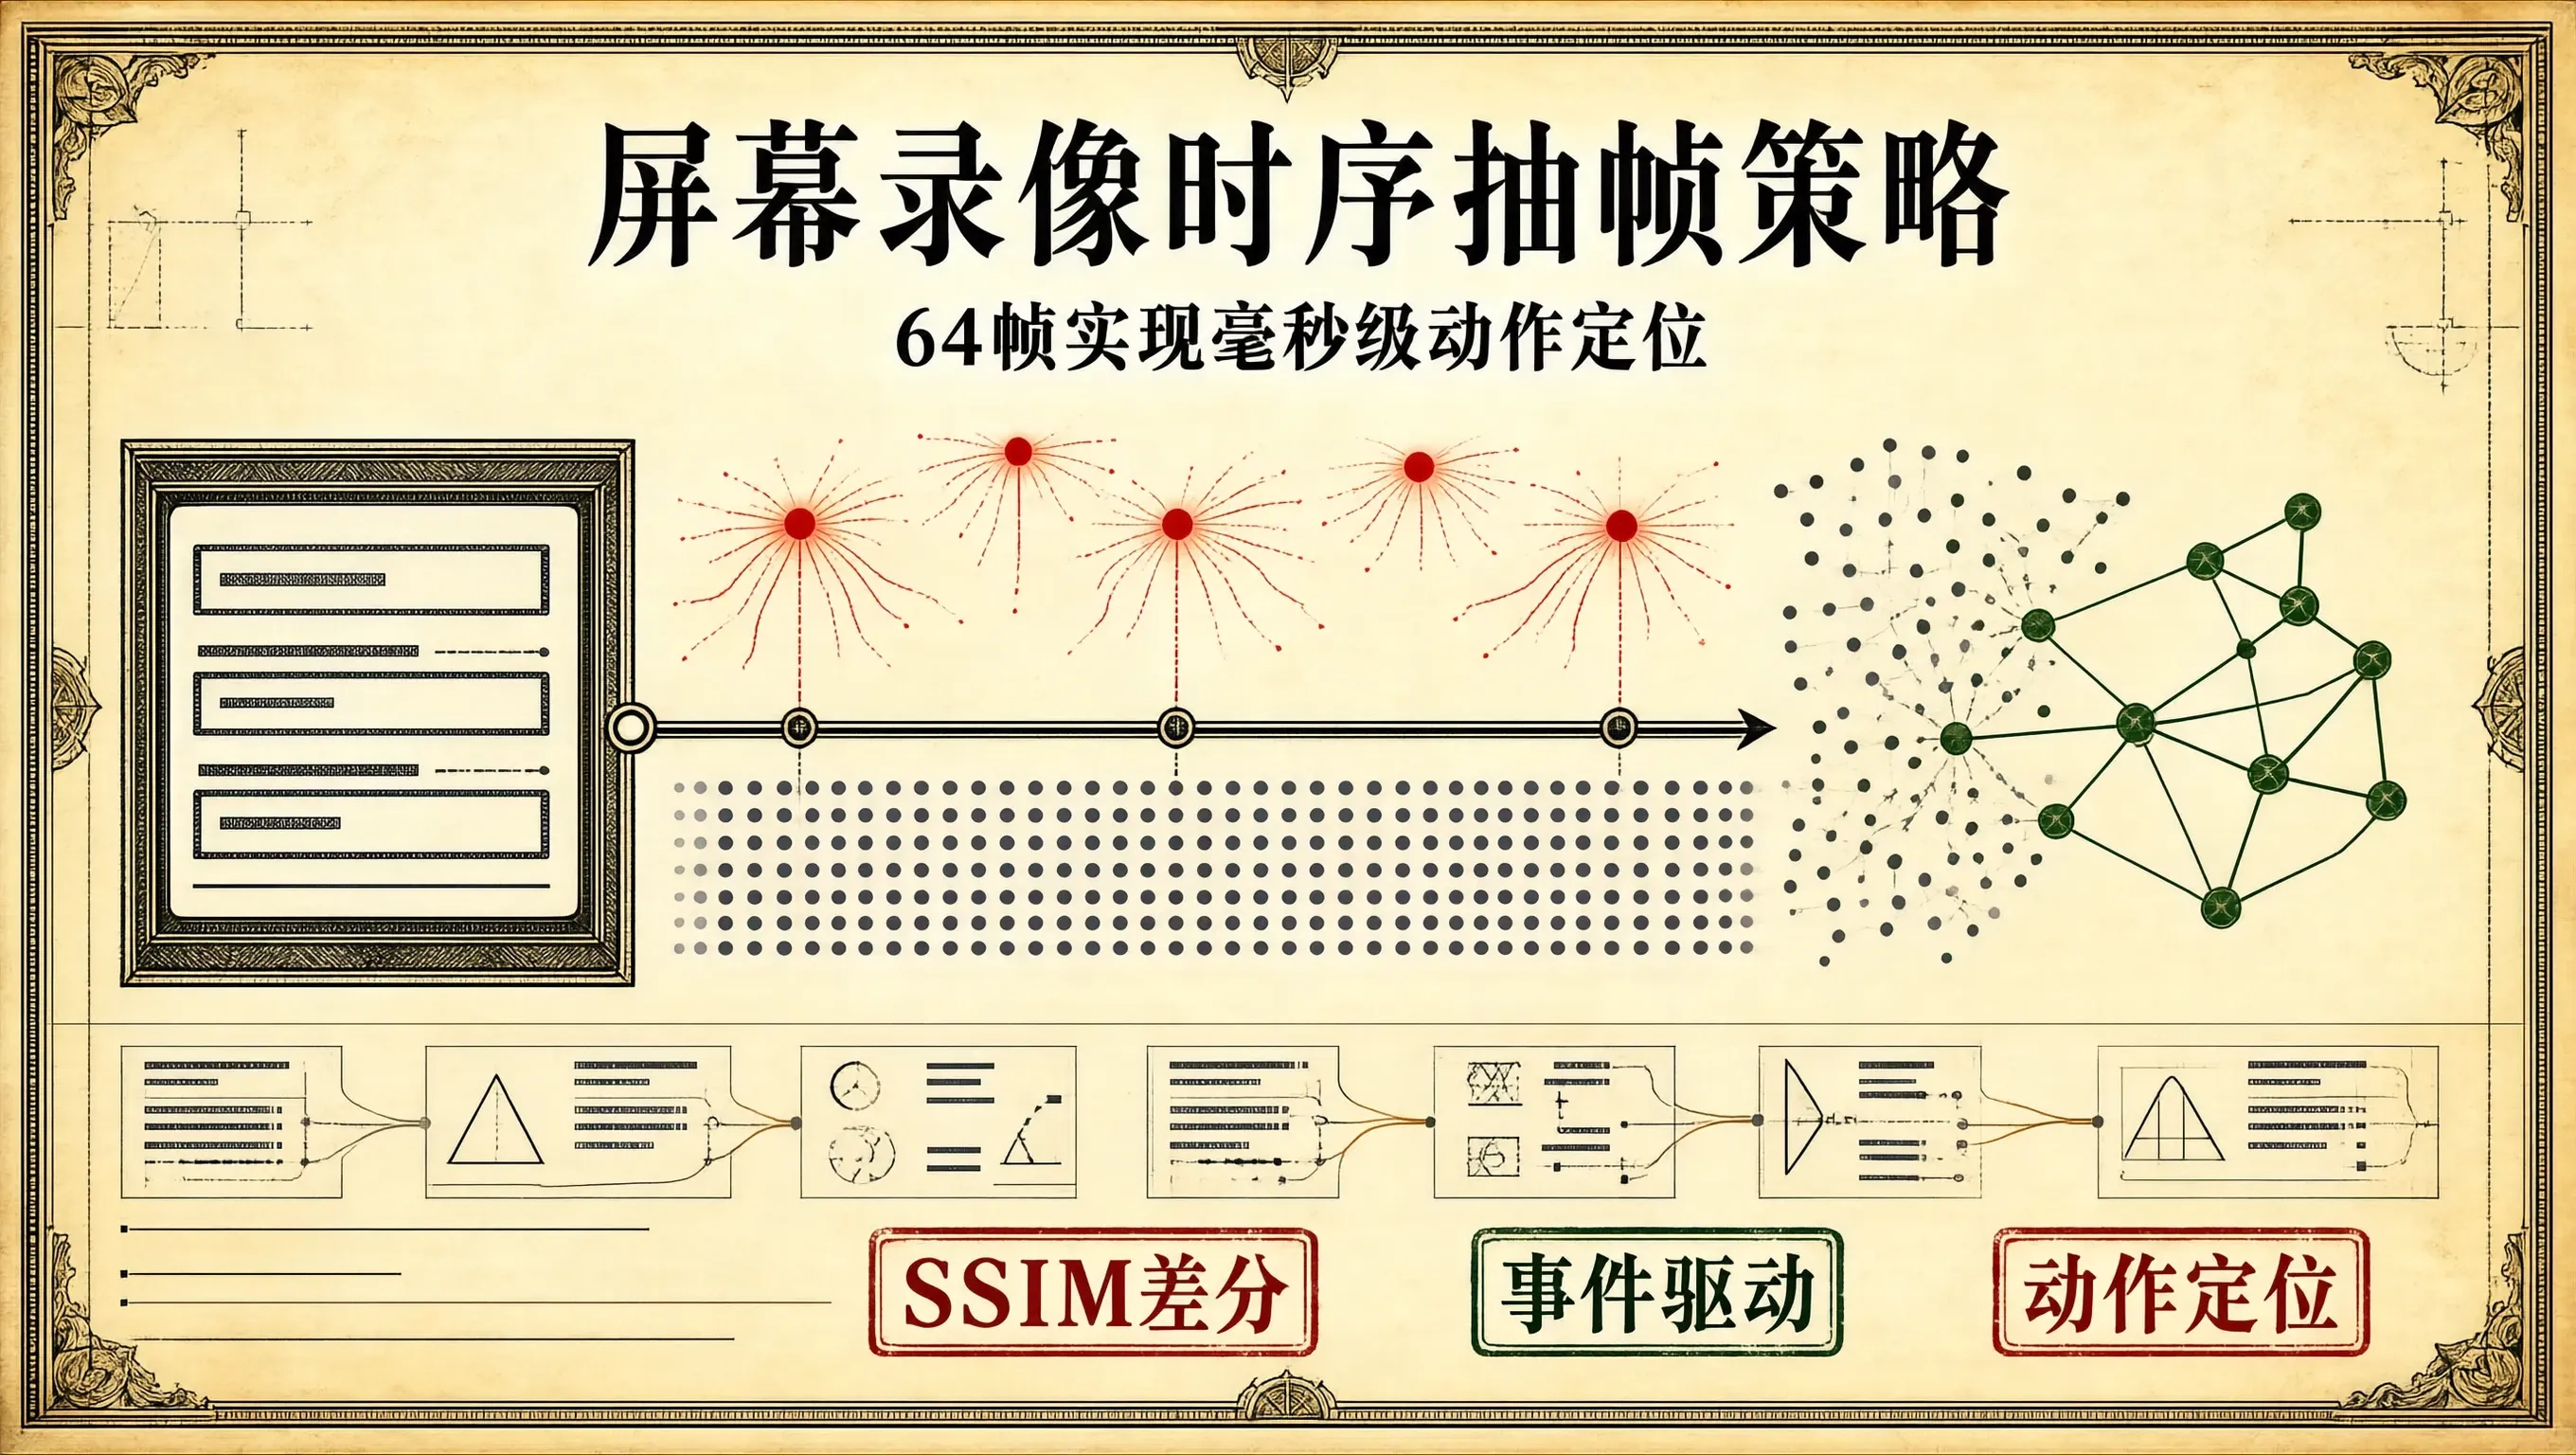
在多模态视频智能的赛道上,最昂贵的浪费是用均匀的算力去丈量非均匀的世界。理解屏幕录像的突发事件特性,用差分感知捕捉每一次状态跃迁,才能让 Video-LLM 在长时序的数字时空中明察秋毫。
视频超分辨率技术(VSR)是一种通过算法重构提升视频画质的关键技术,其核心原理是利用多帧互补信息进行时空域信息挖掘,重建高频细节。相较于单张图片的超分处理,VSR能通过光流算法等运动补偿技术更准确地恢复纹理细节。这项技术在安防监控领域具有重要价值,特别是在跨摄像头追踪场景中,能够显著提升画面清晰度和识别准确率。通过深度学习架构如EDVR模型,结合可变形卷积模块(PCD),可以实现高达78%的细节还
深度学习技术持续演进,参数高效微调(PEFT)和多模态理解成为当前研究热点。PEFT通过量化感知和动态位宽调度等技术,显著降低大模型微调成本,使70B参数模型在消费级GPU上运行成为可能。多模态技术正从静态图像扩展到动态视频理解,Video-LLaMA v2通过时空联合建模在视频问答基准上超越人类表现。3D生成技术如TripoSR实现了文本到3D网格的快速生成,广泛应用于游戏开发和工业设计。这些突
视频超分辨率(VSR)技术通过深度学习算法提升视频画质,其核心在于时空特征融合与运动补偿。现代VSR系统采用三维卷积和注意力机制,在PSNR指标上较传统方法提升6dB以上,但实时处理仍是技术难点。随着Transformer架构的应用,如SwinVSR模型在REDS4测试集达到32.7dB PSNR,同时轻量化方案如TensorRT量化可将吞吐量提升4倍。关键技术突破包括动态权重融合和硬件感知设计,