登录社区云,与社区用户共同成长
邀请您加入社区
Meta开源了革命性的Ego-Exo4D多模态视频数据集,它通过同步采集第一人称与第三人称视角,并结合视觉、音频、IMU及眼动等多维度数据,为AI理解复杂人类行为提供了前所未有的高质量训练资源。该数据集旨在解决跨视角对应、细粒度操作识别等核心挑战,将极大推动具身智能、人机交互及视频理解等领域的研究与发展。
本文深入解析了Video-LLaMA架构,探讨其如何通过双分支对齐实现端到端视频理解。该多模态模型结合视觉与音频处理,利用视频Q-Former和跨模态注意力机制,显著提升视频内容分析的准确性。文章还分享了性能优化技巧和应用前景,为开发者提供实用指导。
近日,面壁智能、清华大学、OpenBMB 联手开源了新一代端侧多模态模型 MiniCPM-V 4.6,该模型参数规模仅约 1.3B,却同时支持图像理解、视频理解、OCR 与多轮多模态对话等能力,并在多项评测中实现了对同级别模型的超越。高昂的推理成本、不可控的网络延迟,以及日益敏感的数据隐私风险,正在让「大而全」的模型路线遭遇瓶颈。尤其是在端侧设备与高并发工业环境里,1.登录 OpenBayes.c
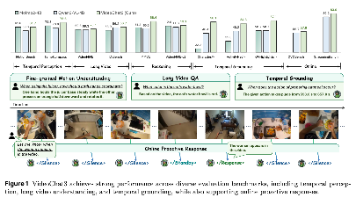
VideoChat3 通过 I3D-ViT 早期时空压缩 + 自适应分辨率 + 大规模重标注/合成视频指令数据 + 四阶段训练,在完全开源的前提下,用 4B 参数实现了在通用、长视频、流式视频理解上优于同/更大规模开源模型的性能,并显著提升长视频推理效率和主动流式交互能力。通用长视频多模态大模型,针对现有视频MLLM痛点:普遍将视频拆分为独立图片序列编码,丢失帧间时序运动信息;长视频输入易出现To
随着多模态生成技术的成熟,AI已从单点工具走向内容生产全链路。从AI短剧、漫剧到恋综,底层共享同一条自动化管线:剧本生成、分镜拆解、角色一致性、视频合成与音频同步。其核心原理在于将传统“拍摄”重构为“生成+拼接”,显著降低试错成本,使小团队也能批量产出内容。当生成能力富余后,如何高效筛选优质创意成为新瓶颈,于是“AI观众”作为模拟反馈机制应运而生,本质上是用Agent模拟用户情感与完播率,辅助创作
媒资内容管理是媒体行业数字化转型的基础设施。随着视频、图片等非结构化数据激增,传统人工编目与关键词检索已无法满足高效再利用需求。基于AI的多模态理解与语义向量检索技术,能够自动完成内容识别、标签生成与跨模态搜索,将“死素材”转化为可用的“活资产”。本文从项目实战出发,梳理了AI媒资平台在自动标引、智能审核、场景拆条等环节的落地要点,并针对检索召回率、算力成本、脏数据兼容性等典型问题给出了工程化解决
语音交互正在成为人机协同的新常态,从智能音箱到车载助手,用户越来越习惯用自然语言与系统对话。实现这一体验的核心链路,是将语音识别、语义理解与语音合成三大技术模块串成一条自动化流水线。语音识别负责将声波转化为文本,大模型推理引擎负责理解意图并调用工具,语音合成则把结构化回答重新转为拟人化的语音输出。这种三段式架构不仅大幅降低了传统语音机器人的开发门槛,还保留了上下文管理与工具调用的高级能力,适用于智
它把视频处理从固定抽帧改成带工具的主动检索,Gemini 会根据问题决定要看哪些时间段、用多高的帧率,以及要不要读取音频和转写。官方说明,主动视频理解使用标准的 Gemini API token 计费,没有额外的功能使用费,但思考与输出仍按模型的正常费率计算。文件路径换成自己的视频,问题换成业务查询。问题不只在账单,画面变化很小的白板讨论也可能刚好落在两帧之间,模型看见了会议,却没看见真正有用的那
在人工智能与自动化流程中,Agent的能力边界往往取决于它对非结构化数据的感知与理解。视频作为信息密度最高的载体,却长期是Agent的认知盲区。本文从技术原理出发,解析如何通过FFmpeg抽帧、OCR字幕提取、ASR语音转写与多模态视觉理解,构建一套完整的视频解析链路。这一方案将视频转化为带时间轴的结构化报告,使Agent能够像处理文本一样处理视频内容,从而支撑会议纪要整理、课程切片、视频审核等工
当前主流Agent本质上是文本交互与工具调用的组合,面对视频这类多模态数据时存在天然短板。视频理解涉及画面抽帧、音频转写与时间轴对齐等复杂流程,单纯依赖外部API难以支持多轮交互与精细检索。通过将视频处理封装为Agent Skill,可以系统化地完成从原始视频到结构化信息的转换,为多模态模型提供可理解的输入。本文从概念到原理,剖析基于ffmpeg与whisper等常见组件的实现方案,并展示视频摘要
多模态大模型时代,视频信息的高效解析成为AI应用落地的关键挑战。与传统文本处理不同,视频理解需要同时处理视觉与音频双通道数据。通过视频抽帧、语音转写与时间轴对齐,可将非线性视频流转换为结构化的图文剧本,从而让大模型“看懂”视频内容。这一技术路线在Agent开发中尤为重要——Agent需要扩展视频感知能力,而基于Skill机制的视频处理工具能够低成本实现多模态扩展。本文从工程实践角度,解析基于ffm
视频理解是AI Agent处理非结构化数据的关键能力之一。传统方法让模型直接读取视频流会面临上下文窗口爆炸、信息密度不均等多重挑战。解决思路是将连续视频拆解为离散的视觉、听觉与文本信号:通过ffmpeg按场景动态抽帧获取画面信息,借助whisper完成音频转写,结合OCR识别画面中烧录的文字,最后把三路结果按时间轴对齐生成结构化的Markdown文本。这种多模态信息融合方案不仅大幅降低Token消