【长视频理解-2024CVPR】MA-LMM:Memory-Augmented Large Multimodal Model for Long-Term Video Understanding
摘要
随着大型语言模型(LLMs)的成功,将视觉模型整合到LLMs中以构建视觉语言基础模型,最近引起了更多的关注。然而,现有的基于LLM的大型多模态模型(例如,Video-LLaMA、VideoChat)只能处理有限数量的帧,用于短视频理解。在本研究中,我们主要专注于设计一个高效且有效的模型,用于长期视频理解。与大多数现有工作试图同时处理更多帧不同,我们提出以在线方式处理视频,并将过去的视频信息存储在记忆库中。这使得我们的模型能够在不超出LLMs的上下文长度限制或GPU内存限制的情况下,引用历史视频内容进行长期分析。我们的记忆库可以无缝地以现成的方式集成到当前的多模态LLMs中。我们在各种视频理解任务上进行了广泛的实验,例如长期视频理解、视频问答和视频字幕生成,我们的模型在多个数据集上都能达到最先进的性能。

引言
大型语言模型(LLMs)在自然语言处理领域获得了显著的流行度。通过在大规模文本数据上进行预训练,LLMs(例如GPT[1–4]、LLaMA[5, 6])展示了在统一框架内执行生成性和判别性任务的卓越能力。最近,利用LLMs进行多模态任务的兴趣日益增长。通过将LLMs与视觉编码器集成,它们可以将图像和视频作为输入,并在各种视觉理解任务中展现出惊人的能力,例如字幕生成、问答[7–13]、分类、检测和分割[14–20]。为了处理视频输入,一些先前的大型多模态模型[7, 9]直接将每一帧的查询嵌入沿时间轴连接后输入LLMs。然而,LLMs固有的上下文长度限制和GPU内存消耗限制了可以处理的视频帧数量。例如,LLaMA的上下文长度限制为2048,而像LLaVA[8]和BLIP-2[7, 9]这样的大型多模态模型分别每张图像接受256和32个标记。因此,当视频时长较长(例如电影和电视剧)时,这种设计并不实用和可行。为了解决这些问题,一个简单的解决方案是像VideoChatGPT[21]那样沿时间轴应用平均池化,但这会导致性能下降,因为它缺乏明确的时间建模。另一种方法是添加一个视频建模组件来捕捉时间动态,如Video-LLaMA[12]所示,它采用了一个额外的视频查询变换器(Q-Former)来获得视频级表示。然而,这种设计增加了模型复杂性,增加了训练参数,并且不适合在线视频分析。
鉴于这些情况,我们引入了一种记忆增强型大型多模态模型(MA-LMM),旨在实现高效且有效的长期视频建模。MA-LMM采用了与现有大型多模态模型[7, 9, 12]类似的结构,**包括一个视觉编码器以提取视觉特征、一个查询变换器以对齐视觉和文本嵌入空间,以及一个大型语言模型。**如图1(a)所示,与直接将视觉编码器的输出馈送到查询变换器相反,我们选择了一种在线处理方法,该方法依次处理视频帧并将视频特征存储在提议的长期记忆库中。这种依次处理视频帧并利用记忆库的策略显著减少了长视频序列的GPU内存占用。它还有效地解决了LLMs有限上下文长度所施加的限制,如图1(b)所示。我们的设计为大型多模态模型提供了长期视频理解的解决方案,与先前的方法[7, 9, 12, 13, 21]相比具有显著优势,这些方法消耗了大量的GPU内存并需要大量的输入文本标记。
我们方法的核心贡献是引入了一个长期记忆库,该记忆库捕获并聚合了历史视频信息。具体而言,记忆库以自回归的方式聚合过去的视频特征,这些特征可以在后续视频序列处理期间被引用。此外,我们的记忆库被设计为与Q-Former兼容,在长期时间建模的注意力操作中,它充当键和值。因此,它可以无缝地以现成的方式集成到现有的大型多模态模型中,以启用长期视频建模能力。为了进一步提高效率,我们提出了一种记忆库压缩方法,该方法保持记忆库的长度相对于输入视频长度恒定。通过选择并平均最相似的相邻帧特征,它可以在显著减少长视频中的时间冗余的同时,保留所有的时间信息。
我们总结我们的主要贡献如下:
- 我们引入了一种新颖的长期记忆库设计,以增强现有的大型多模态模型,使它们具备长期视频建模能力。
- 我们的模型通过在线处理视频序列,显著减少了GPU内存使用,并解决了LLMs的上下文长度限制。
- 我们的方法在各种下游视频任务上实现了新的最先进的性能,包括长期视频理解、视频问答和视频字幕生成。
相关工作
图像语言模型
受强大语言模型[1–6]成功的启发,近期的图像-语言模型倾向于将预训练的语言模型与图像编码器相结合,以支持多模态推理能力[7–10, 22]。Flamingo[22]提出连接仅视觉和仅语言的预训练模型,并在少样本学习任务中实现了最先进的性能。BLIP-2[7]引入了一个轻量级的查询变换器,以弥合冻结的预训练图像编码器和冻结的LLMs之间的模态差距。尽管其可训练参数显著较少,但它在各种多模态任务上表现良好。LLaVA[8]采用一个简单的线性层将图像特征投影到文本嵌入空间,并高效地微调LLMs[23]以获得更好的性能。在BLIP-2的基础上,MiniGPT-4[10]收集了一个大规模高质量的图像-文本对数据集,实现了更好的语言生成能力。VisionLLM[15]利用LLMs的推理和解析能力,在多个细粒度目标级和粗粒度推理任务中表现出色。
视频语言模型
先前的图像-语言模型,如Flamingo[22]和BLIP-2[7, 9],也可以支持视频输入。它们简单地将时空特征展平为1D序列,然后将这些序列输入语言模型以处理视频输入。然而,这些方法不能有效地捕捉视频的时间动态。基于这一动机,Video-LLaMA[12]通过添加一个额外的视频查询变换器来增强BLIP-2的结构,以明确地建模时间关系。同样,在LLaVA[8]的基础上,Video-ChatGPT[21]简单地在空间和时间维度上对帧级特征进行平均池化,以生成视频级表示。VideoChat[13]利用感知模型生成动作和目标注释,然后将这些注释传递给LLMs进行进一步推理。尽管取得了进展,但这些模型主要针对短视频设计。受Token Merging[24]的启发,该方法通过平均高度相似的标记来减少计算成本,我们提出了将这一思想扩展到视频数据,特别是沿时间轴的扩展。这一扩展旨在缓解处理长视频输入时面临的大量标记数量和计算成本的挑战。一些同期工作[25–27]也探索了类似策略,即合并相似标记以处理视频输入。更多详细讨论请参阅补充材料。
长期视频模型
长期视频理解方法侧重于捕捉长视频中的长距离模式,这些视频通常超过30秒。为了缓解处理长视频的计算需求,一种普遍的方法是使用预提取的特征,避免了对骨干架构进行联合训练的需要[28–32]。或者,一些研究工作旨在设计稀疏视频采样方法[33, 34],通过仅保留显著的视频内容来减少输入帧的数量。其他工作,如Vis4mer[35]和S5[36],利用S4[37]的精简变换器解码器结构,以线性计算复杂度实现长距离时间建模。受记忆库设计[38–41]的启发,我们提出将长期记忆库与大型多模态模型相结合,以实现高效且有效的长期时间建模能力。
方法
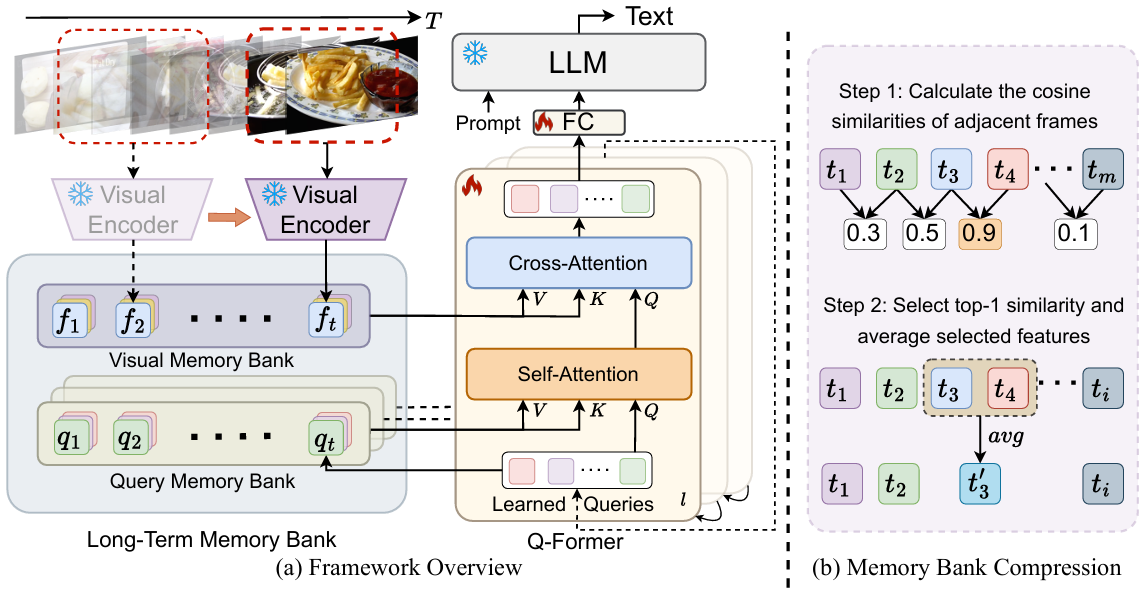
图2。(a)框架概览。MA-LMM以在线方式自回归地处理视频帧。设计了两个长期记忆库,用于在每个时间步存储原始视觉特征和学习到的查询,这些特征和查询可用于未来的参考。Q-Former由多个级联块组成,用l表示。LLM为各种视频理解下游任务输出文本。雪花图标表示参数固定的组件,而火焰图标表示模型中经过微调的部分。(b)记忆库压缩技术的示意图,该技术用于保持记忆库的长度恒定。
我们介绍了MA-LMM,这是一种用于长期视频理解的记忆增强型大型多模态模型。与大多数视频理解方法[31, 42–49]同时处理更多帧不同,我们提出以在线方式自回归地处理视频帧,这一方法受到了MeMViT[41]中呈现的在线处理方式和长期记忆设计的启发。图2(a)展示了我们MA-LMM框架的概览。
遵循大型多模态模型[7, 9, 12]的类似实践,整个模型架构可以分为三个部分:(1)使用冻结的视觉编码器进行视觉特征提取(第3.1节),(2)使用可训练的查询变换器(Q-Former)进行长期时间建模,以对齐视觉和文本嵌入空间(第3.2节),以及(3)使用冻结的大型语言模型进行文本解码(第3.3节)。
1. 视觉特征提取
这一设计灵感来源于人类处理长期视觉信息的认知过程。人类并非同时处理大量的信号,而是以序列的方式处理它们,将当前的视觉输入与过去的记忆相关联以实现理解,并有选择地保留显著信息以供后续参考[41]。同样,我们的MA-LMM依次处理视频帧,将新的帧输入与长期记忆库中存储的历史数据动态关联,确保只有具有区分性的信息被保留以供后续使用。这种选择性保留促进了视频理解的更可持续和高效的方法,进一步使模型能够自动支持在线视频推理任务。

2. Long-term Temporal Modeling
为了将视觉嵌入对齐到文本嵌入空间,我们采用了BLIP-2[7, 9]中的查询变换器(Q-Former)的相同架构。Q-Former接收学习到的查询以捕捉视频时间信息。在我们的实验中,Q-Former为每张图像输出32个标记,这比LLaVA[8]产生的256个标记更高效。每个Q-Former块包含两个注意力子模块:(1)交叉注意力层,与从冻结的视觉编码器中提取的原始视觉嵌入进行交互,以及(2)自注意力层,对输入查询内的交互进行建模。与BLIP-2中原有的Q-Former仅关注当前帧的嵌入不同,我们设计了一个由视觉记忆库和查询记忆库组成的长期记忆库,该记忆库累积过去视频信息,并增强交叉和自注意力层的输入,以实现有效的长期视频理解。
2.1)视觉记忆库
视觉记忆库存储从冻结的视觉编码器中提取的每帧的原始视觉特征。具体来说,对于当前时间步t,视觉记忆库包含过去视觉特征的连接列表 Ft = Concat[f1, f2, …, ft],给定输入查询 zt,视觉记忆库作为键和值:


通过这种方式,它可以通过缓存的视觉记忆库明确地关注过去的视觉信息,具有长期上下文。由于Q-Former中的所有交叉注意力层都关注相同的视觉特征,因此只有一个视觉记忆库在所有Q-Former块之间共享。
2.2)查询记忆库
与存储原始和静态视觉特征的固定视觉记忆库不同,查询记忆库累积每个时间步的输入查询,表示为 Zt = Concat[z1, z2, …, zt]。通过存储这些查询,我们通过Q-Former维护模型对每个帧的理解和处理的动态记忆,直到当前时间步。查询记忆库也作为键和值:

然后我们应用与公式3相同的注意力操作。在每个时间步,z 包含每个视频直到当前时间步t的特定重要信息。与静态视觉记忆库不同,输入查询 z 在模型训练期间通过级联的Q-Former块演变,捕捉不同视频概念和模式在不断增加的抽象层次上。因此,每个自注意力层都有一个独特的查询记忆库,在训练期间更新其中包含的输入查询。
2.3)记忆库压缩
鉴于我们的模型直接在记忆库中存储过去的视频信息,随着过去视频帧数量的增加,GPU内存和计算成本呈线性增长。对于长视频来说,这尤其具有挑战性,因此进一步将记忆库压缩到更小的大小变得至关重要。一种传统的管理时间序列的方法是采用先进先出队列。在这里,当记忆库达到预定义的限制时,会移除最早时间步的特征,MeMViT[41]中就采用了这种策略。然而,随着新帧的添加和旧特征的弹出以维持记忆库容量,这会导致早期历史信息的丢失。或者,MeMViT采用可学习的池化算子来压缩记忆库中存储的特征的时空大小,但是这会引入额外的可训练参数。
受到在[24, 50–52]等工作中展示的标记合并和剪枝技术有效性的启发,我们引入了一种新颖的记忆库压缩(MBC)技术,以利用视频中固有的时间冗余。我们提出的方法通过利用相邻特征之间的相似性,随时间聚合和压缩视频信息,从而保留早期历史信息。这种方法有效地压缩了记忆库中的重复信息,同时保留了区分性特征。值得注意的是,几个同期工作[25–27]也采用了类似的标记合并策略来减少视频冗余。如图2b所示。
3. 文本解码
由于我们以自回归方式处理视频帧,因此在最终时间步,Q-Former的输出包含了所有历史信息,这些信息随后被输入到LLM中。因此,我们可以显著减少输入文本标记的数量,从 N×T 减少到 N,从而解决了当前LLMs的上下文长度限制问题,并大幅减轻了GPU内存需求。在训练期间,给定一个包含视频和文本对的标注数据集,我们的模型采用标准的交叉熵损失进行监督学习。
实验
1. 任务和数据集
为了验证所提出的MA-LMM的有效性,我们主要关注长期视频理解任务。我们还将评估扩展到标准视频理解任务(例如,视频问答、视频字幕生成),以进一步与现有的多模态方法进行比较。
长期视频理解
我们在三个广泛使用的长期视频数据集上进行实验,包括LVU[32]、Breakfast[56]和COIN[57]。我们以top-1分类准确率作为评估指标。LVU数据集包含从约3000部电影中提取的约30000个视频,每个视频时长为1到3分钟。鉴于当前的大型多模态模型通常执行文本生成且缺乏回归能力,我们将实验限制在七个分类任务上:关系、说话风格、场景、导演、类型、编剧和发行年份。Breakfast[56]数据集包含与早餐准备相关的视频,共有1712个视频,平均时长约2.7分钟。COIN[57]是一个用于全面教学视频分析的大规模数据集,包含来自YouTube的11827个教学视频,涵盖与日常生活相关的12个领域的180个不同任务。视频的平均时长为2.36分钟。
视频问答
我们在三个开放性视频问答数据集上进行评估,包括MSRVTT-QA[62]、MSVD-QA[62]和ActivityNet QA[63]。这些数据集由时长为10-15秒的短视频组成。
视频字幕生成
我们在三个流行的数据集上报告METEOR[64]和CIDEr[65]指标的视频字幕生成结果:MSRVTT[66]、MSVD[67]和Youcook2[68]。
在线动作预测
我们通过在EpicKitchens-100[69]数据集上进行实验,进一步评估我们模型的在线预测能力,该数据集包含700个烹饪活动的长视频,总时长为100小时。它包括97个动词、300个名词和3807种动作类型。遵循[70]中的相同实验设置,我们在验证数据集上报告top-5准确率和召回率结果。
2. 实验
对于视觉编码器,我们采用了来自EVA-CLIP[72]的预训练图像编码器ViT-G/14[71],也可以将其替换为其他基于CLIP的视频编码器。我们使用了来自InstructBLIP[9]的预训练Q-Former权重,并采用了Vicuna-7B[73]作为LLM。所有实验均在4个A100 GPU上进行。关于训练和评估的更多详细信息在补充材料中有描述。
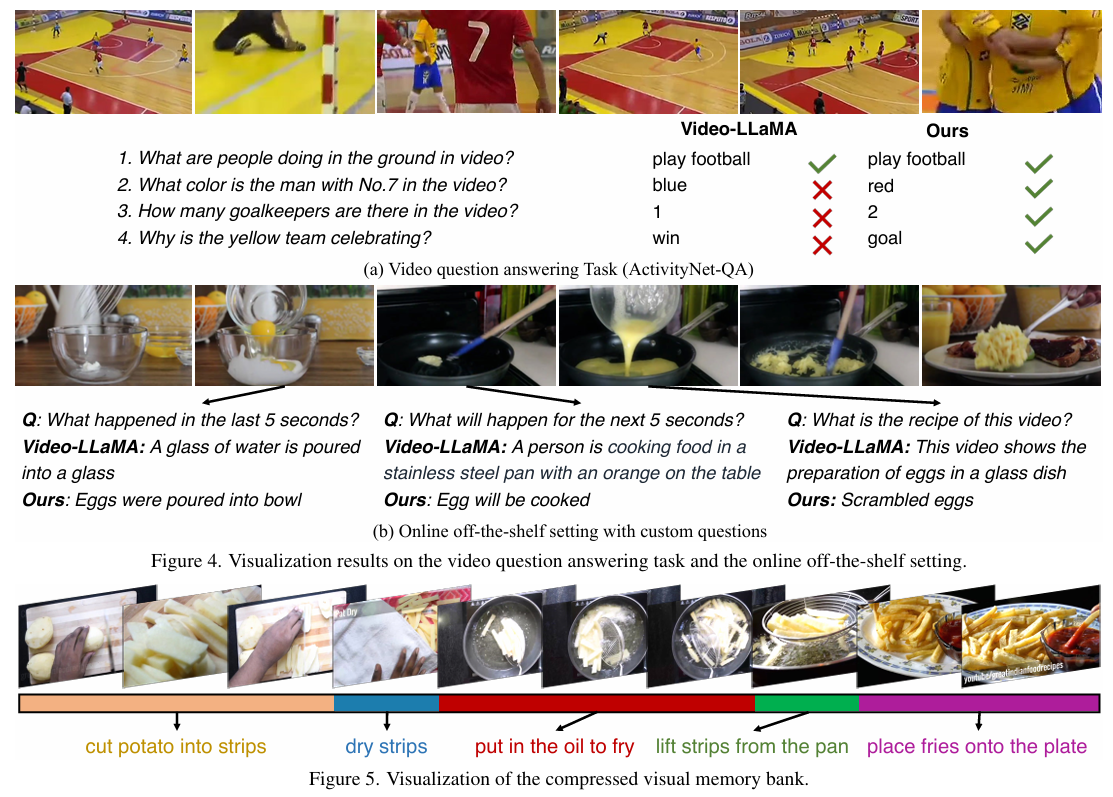
为了与现有的多模态视频理解方法进行比较,我们在表3中提到的开放性视频问答数据集上进行了实验,以展示我们模型的泛化能力。鉴于这些大多是短视频,预计我们的记忆库效果会较差。然而,有趣的是,我们发现MA-LMM在MSRVTT和MSVD数据集上达到了新的最佳性能,而在ActivityNet数据集上的表现略低于VideoCoCa。后者并不令人意外,因为VideoCoCa[81]利用大规模的视频-文本数据集进行预训练(例如,HowTo100M[84]和VideoCC3M[85]),而我们的MA-LMM仅使用在图像-文本数据集上预训练的模型权重。
值得注意的是,我们的MA-LMM在所有三个数据集上显著优于最近基于LLM的模型Video-LLaMA[12]。Video-LLaMA将来自冻结的图像Q-Former的所有查询嵌入进行连接,并从头开始训练一个额外的视频Q-Former来建模时间依赖性,这消耗了太多的GPU内存,使得它对于长视频输入不切实际。相比之下,我们的MA-LMM仅微调来自预训练图像Q-Former的权重,没有引入额外的视频Q-Former,却能够通过长期记忆库有效地捕捉时间关系。这一结果有力地证明了我们的设计在一般视频问答任务上的优越性,并揭示了即使只有少数帧和查询被记忆库捕获,也能产生显著的有益效果。

结论
在本文中,我们介绍了一种长期记忆库,旨在增强当前的大型多模态模型,使它们具备有效且高效地对长期视频序列进行建模的能力。我们的方法处理大型语言模型与多模态数据。我们以在线方式依次处理视频帧,并将历史数据存储在记忆库中,从而解决了LLMs的上下文长度限制以及长视频输入带来的GPU内存约束问题。我们的长期记忆库是一个即插即用的模块,可以无缝地集成到现有的大型多模态模型中。在各种任务上的实验已经证明了我们方法的显著优势。我们相信,我们的MA-LMM为长期视频理解领域的未来研究提供了宝贵的见解。

邀请您加入社区
更多推荐

 43
 0
- 0


 已为社区贡献1条内容

所有评论(0)