大模型核心技术——基于RAG(Retrieval-Augmented Generation)的视频检索方案
随着短视频、直播、在线课程的爆炸式增长,我们每天都在海量的视频内容里打转。可有时候,你是不是也遇到过这种情况:明明知道某个视频里有你想要的信息,却怎么也找不到具体在哪一分钟?别急,今天我要和你聊聊一个超实用的技术——基于RAG(Retrieval-Augmented Generation)的视频检索方案。简单来说,它能让你输入一个问题或话题,然后直接告诉你视频里哪一段能解答你。听起来是不是很酷?下面,我会一步步带你了解它是怎么实现的,还有代码和应用场景,保证你看完就能明白!
一、RAG搜索视频是个啥?简单聊聊它的原理
你有没有想过,如果有个“超级大脑”,既能快速搜索信息,又能根据你的问题给出精准答案,会是什么样?RAG技术就是这么一个存在。它把传统的搜索(检索)和AI生成答案的能力结合起来,再加上一个外部知识库,让结果更靠谱。在视频检索里,这个“知识库”其实就是视频里的字幕或者语音转成的文本。

它的核心流程大概是这样的:
- 把视频“翻译”成文字:通过语音识别技术(比如Google Speech API或OpenAI的Whisper),把视频里说的每一句话变成文字,还要记下每段话的时间点。
- 给文字加上“标签”:用一个叫Sentence Transformers的工具,把这些文字变成一串数字(向量),有点像给每句话贴上一个语义标签。
- 建个“搜索地图”:把这些数字标签存进一个叫Faiss的数据库里,这样就能快速找到和你的问题最匹配的那段文字。
- 直奔目标:根据找到的文字,跳到视频对应的时间点,给你看那一小段。
是不是听起来挺直白?接下来,我们细细拆解每一步,看看具体怎么操作。
二、从零到一:实现视频检索的6个步骤

1. 视频字幕提取:把声音变成文字
你在看一部没有字幕的电影,得靠耳朵硬听。现在,我们用自动语音识别(ASR)技术,把视频里的声音变成文字。如果视频自带字幕,那就更省事,直接拿来用。这一步就像给视频配上一个“听写员”,为后面做准备。
2. 文本预处理与切分:把长篇大论拆成小块
拿到了字幕后,不能直接用,因为它可能是一大段文字。我们需要把它切成小份,比如每几句话一段,或者根据意思分。每段还要带上时间戳,就像书签一样,告诉你这段话在视频的哪一分钟。比如,可以把一个15分钟的视频分成几十个小块,每块都有自己的“定位”。
3. 文本嵌入模型编码:让电脑读懂文字
接下来,我们得让电脑明白这些文字的意思。用Sentence Transformers这样的模型,每个小块文字会被变成一串数字(向量)。这些数字不是乱来的,它们能反映文字的含义。比如“今天天气很好”和“今儿阳光明媚”意思差不多,它们的向量也会很接近。这一步就像给每段话画了个“含义画像”。
4. 构建向量索引:搭个高效搜索架子
有了这些向量,我们用Faiss(一个专门存数字的数据库)把它们整理好。Faiss就像一个超级图书管理员,能在几秒钟内找到和你问题最匹配的“画像”。如果视频很多,还可以用更厉害的工具,像Milvus或Weaviate,来处理海量数据。
5. 用户查询与检索:问啥找啥
现在轮到你提问了!比如你输入“RAG怎么用在视频里?”,我们把这个问题也变成一个向量,然后去Faiss里找最相似的几个“画像”。找到后,它会告诉你对应的文字和时间戳。这就像在茫茫视频海里扔了个鱼钩,直接钓出你想要的那部分。
6. 视频片段定位与展示:直奔精彩瞬间
最后一步,根据时间戳,我们要么剪出那段视频给你,要么直接让播放器跳到那个时间点。就像看电视剧时,你可以直接快进到高潮部分,完全不用自己手动拖进度条。
三、程序员最有亲切感的:代码demo
如果你对编程有点兴趣,我给你看个Python代码,展示怎么把这套流程跑起来。别担心,就算你不懂代码,也能看懂它在干啥。
# -*- coding: utf-8 -*-import faissimport numpy as npfrom sentence_transformers import SentenceTransformer
# 假设这是视频的字幕数据subtitles = [    {"text": "在本节中,我们将讲解如何使用RAG进行视频检索。", "timestamp": "00:00:05-00:00:15"},    {"text": "首先,需要提取视频中的字幕,然后对字幕进行预处理。", "timestamp": "00:00:16-00:00:25"},    {"text": "接下来,我们使用预训练模型生成字幕片段的向量表示。", "timestamp": "00:00:26-00:00:35"},    {"text": "最后,通过向量相似度检索找到最匹配的片段。", "timestamp": "00:00:36-00:00:45"},]
# 加载一个能读懂文字的模型model = SentenceTransformer('all-MiniLM-L6-v2')
# 把字幕变成向量texts = [item['text'] for item in subtitles]embeddings = model.encode(texts, convert_to_numpy=True)
# 整理这些向量,方便搜索faiss.normalize_L2(embeddings)  # 让向量更适合比较dimension = embeddings.shape[1]index = faiss.IndexFlatIP(dimension)index.add(embeddings)print(f"索引里已经有 {index.ntotal} 个向量啦!")
# 定义一个搜索功能def search_video_segment(query, top_k=1):    query_embedding = model.encode([query], convert_to_numpy=True)    faiss.normalize_L2(query_embedding)    distances, indices = index.search(query_embedding, top_k)    results = []    for score, idx in zip(distances[0], indices[0]):        result = {            "text": subtitles[idx]["text"],            "timestamp": subtitles[idx]["timestamp"],            "score": float(score)        }        results.append(result)    return results
# 试着搜一下query = "如何实现视频的RAG检索?"results = search_video_segment(query)print("查询结果:")for res in results:    print(f"字幕内容: {res['text']}")    print(f"对应时间戳: {res['timestamp']}")    print(f"相似度分数: {res['score']:.4f}")    print("-" * 30)
运行这段代码,你会看到类似这样的输出:
索引里已经有 4 个向量啦!查询结果:字幕内容: 在本节中,我们将讲解如何使用RAG进行视频检索。对应时间戳: 00:00:05-00:00:15相似度分数: 0.8923------------------------------
这段代码干了啥?它先把字幕变成向量,建了个索引,然后根据你的问题,找到最相关的字幕片段和时间。是不是挺直观?
四、这技术能干啥?来看看实际场景
这种视频检索技术能用在哪些地方呢?我给你举几个例子:
- 课堂救星:学生复习时,直接搜“细胞分裂怎么回事”,就能跳到老师讲的那一段,不用重看整节课。
- 职场神器:公司新员工培训,搜“怎么用这个软件”,马上找到对应的讲解视频。
- 追剧必备:想重温《权游》里龙母放火那段?输入“龙烧船”,直接跳到名场面。
- 新闻利器:记者想找发布会里某句话,搜一下,几秒钟就定位到。
当然,要让它跑得顺,有几点得注意:
- 字幕要准:如果语音识别出错,后面的结果也会乱。
- 模型得更新:新词新说法层出不穷,模型得跟上。
- 长视频分块:超过1小时的视频,最好分成15分钟一段,检索更快。
- 系统要稳:上线时得加点错误处理,别让它轻易崩了。
五、总结
通过本文的探索,你已经见证了基于RAG技术的视频检索如何将复杂的问题化为优雅的解决方案。从字幕提取到向量索引的每一步,都凝结了技术的智慧与实践的结晶。借助RAG技术,我们不仅能实现视频中关键片段的精准定位,还能在教育培训、影视搜索、新闻定位等领域开启了无限可能。看完本文后是不是也觉得RAG只是AI的基础设施?希望本文能为您在视频检索系统的构建与应用中提供有力的指导与启发。
普通人如何抓住AI大模型的风口?
=领取方式在文末==
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
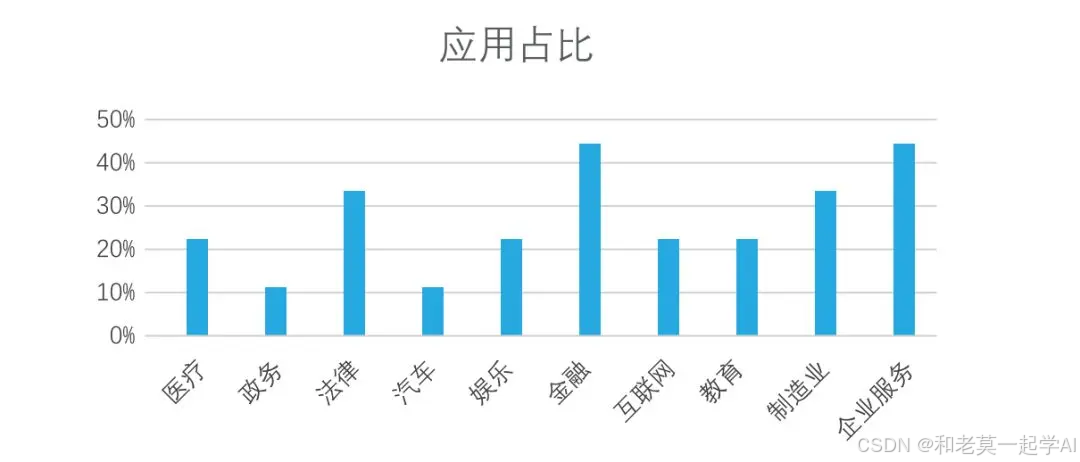
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
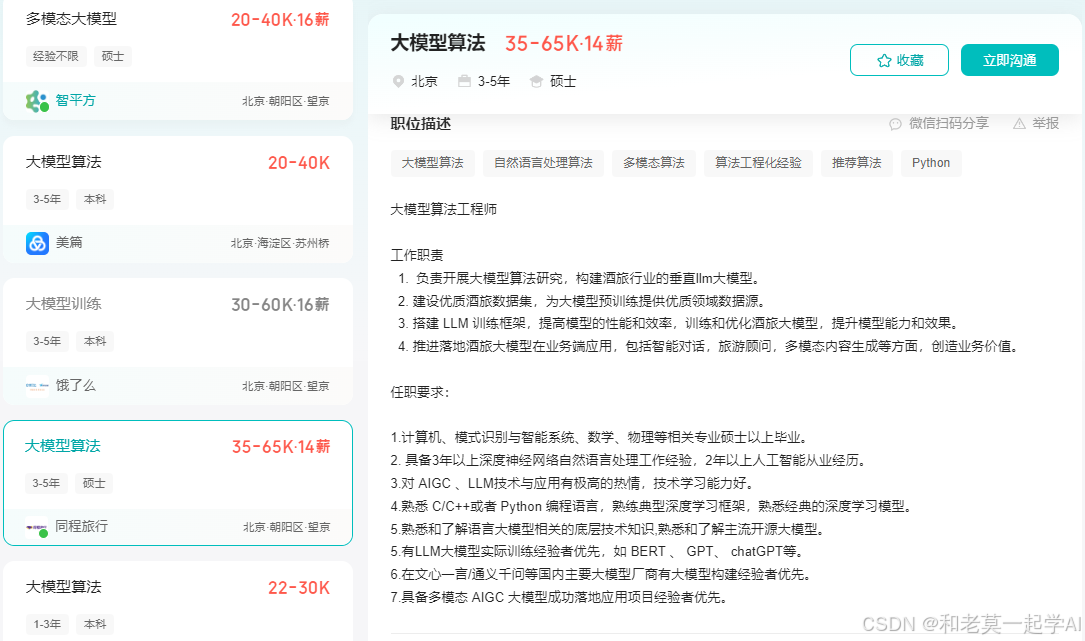
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!
大模型全套学习资料领取
这里我整理了一份AI大模型入门到进阶全套学习包,包含学习路线+实战案例+视频+书籍PDF+面试题+DeepSeek部署包和技巧,需要的小伙伴文在下方免费领取哦,真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
部分资料展示
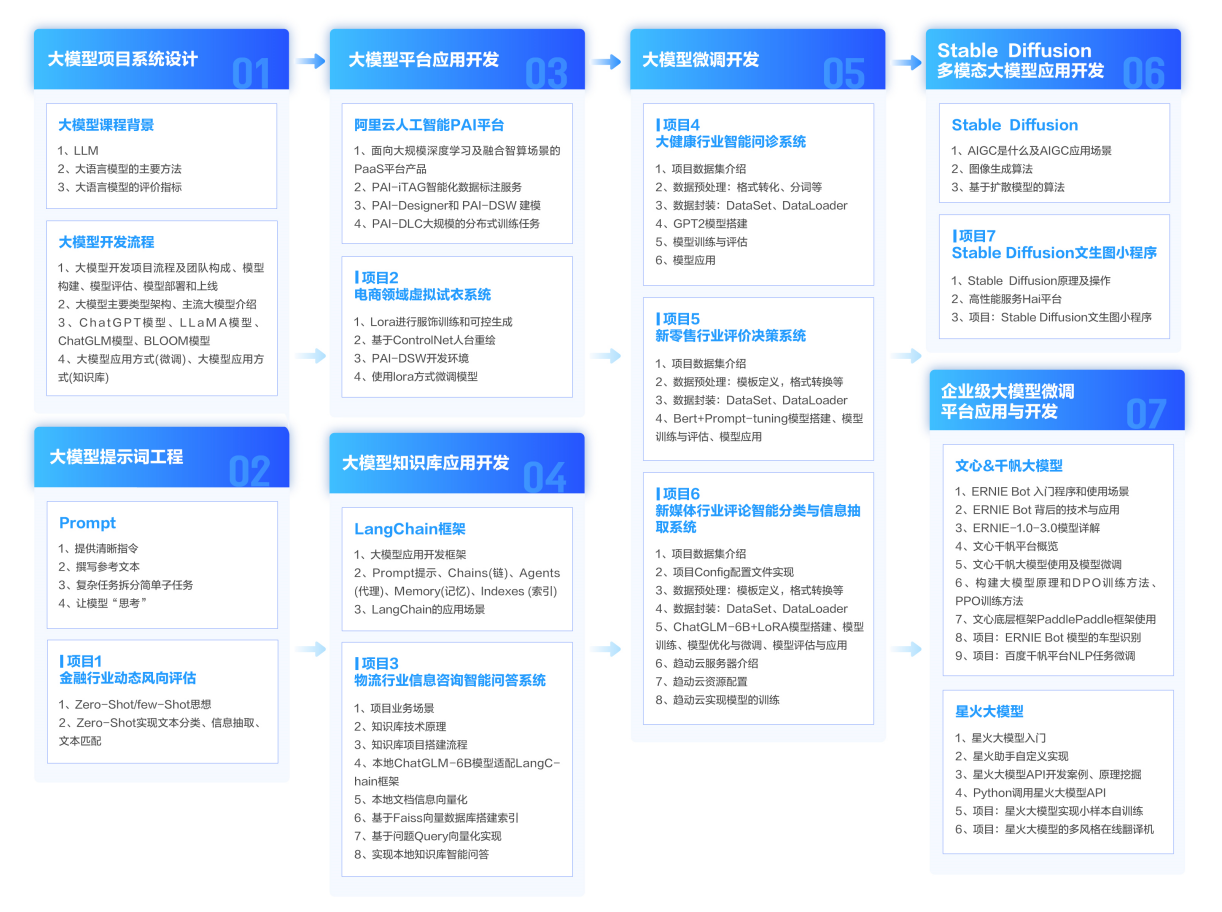
一、 AI大模型学习路线图
整个学习分为7个阶段

二、AI大模型实战案例
涵盖AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,皆可用。


三、视频和书籍PDF合集
从入门到进阶这里都有,跟着老师学习事半功倍。


四、LLM面试题


五、AI产品经理面试题

六、deepseek部署包+技巧大全

😝朋友们如果有需要的话,可以V扫描下方二维码联系领取~

邀请您加入社区
更多推荐

 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)