用IndexTTS2做短视频配音,效率高还自然
用IndexTTS2做短视频配音,效率高还自然
1. 引言:AI语音合成如何改变短视频创作
在短视频内容爆发式增长的今天,创作者面临一个共同挑战:如何高效、低成本地为大量视频内容生成高质量配音。传统的人工录音不仅耗时耗力,而且难以保证语调一致性和情感表达的稳定性。而市面上许多通用TTS(Text-to-Speech)服务又普遍存在“机械感强”“语调生硬”等问题,无法满足观众对自然语音体验的要求。
IndexTTS2 的出现,正在重新定义本地化语音合成的可能性。作为一款支持情感控制、音色参考和高自然度输出的开源TTS系统,它特别适用于需要个性化、可调控语音风格的场景——尤其是短视频配音。
本文将围绕 indextts2-IndexTTS2 最新 V23版本(构建by科哥),详细介绍其在短视频配音中的实际应用流程、核心优势以及工程落地建议,帮助内容创作者和技术团队快速上手并实现高效产出。
2. IndexTTS2 核心特性解析
2.1 情感可控:让语音更有“情绪”
与大多数只能生成中性语调的TTS不同,IndexTTS2 支持多维度的情感调节。通过参数设置,用户可以指定以下情感类型:
neutral(中性)happy(高兴)sad(悲伤)angry(愤怒)calm(平静)fearful(恐惧)
每种情感还可配合强度值(0.0 ~ 1.0)进行微调,例如“高兴+0.8强度”会生成更富有感染力的语调,非常适合用于搞笑类或激励型短视频。
技术类比:就像演员拿到剧本后选择表演风格一样,IndexTTS2 允许你为每段文本“选角”,决定它是“冷静播报”还是“激情呐喊”。
2.2 音色克隆与参考音频机制
IndexTTS2 支持上传参考音频(reference audio),自动提取音色特征并应用于新文本合成。这意味着你可以: - 使用自己的声音录制一段样本; - 让模型模仿该音色生成全新内容; - 实现“数字分身”级别的个性化语音输出。
这对于打造统一品牌声线的IP账号(如知识博主、带货主播)具有极高价值。
2.3 本地部署 + 高隐私保护
所有处理均在本地完成,无需将敏感文本或音频上传至云端。这不仅保障了数据安全,也避免了因网络延迟导致的响应缓慢问题,尤其适合企业级批量处理需求。
3. 快速启动与使用流程
3.1 环境准备与镜像启动
本镜像已预装完整环境,包含 IndexTTS2 V23 版本及其依赖组件。首次运行前请确保宿主机满足以下条件:
- 内存 ≥ 8GB
- 显存 ≥ 4GB(GPU 推荐 NVIDIA 系列)
- 存储空间 ≥ 20GB(含模型缓存)
启动命令如下:
cd /root/index-tts && bash start_app.sh
执行后,系统将自动下载模型文件(首次运行需较长时间),并在端口 7860 启动 WebUI 服务。
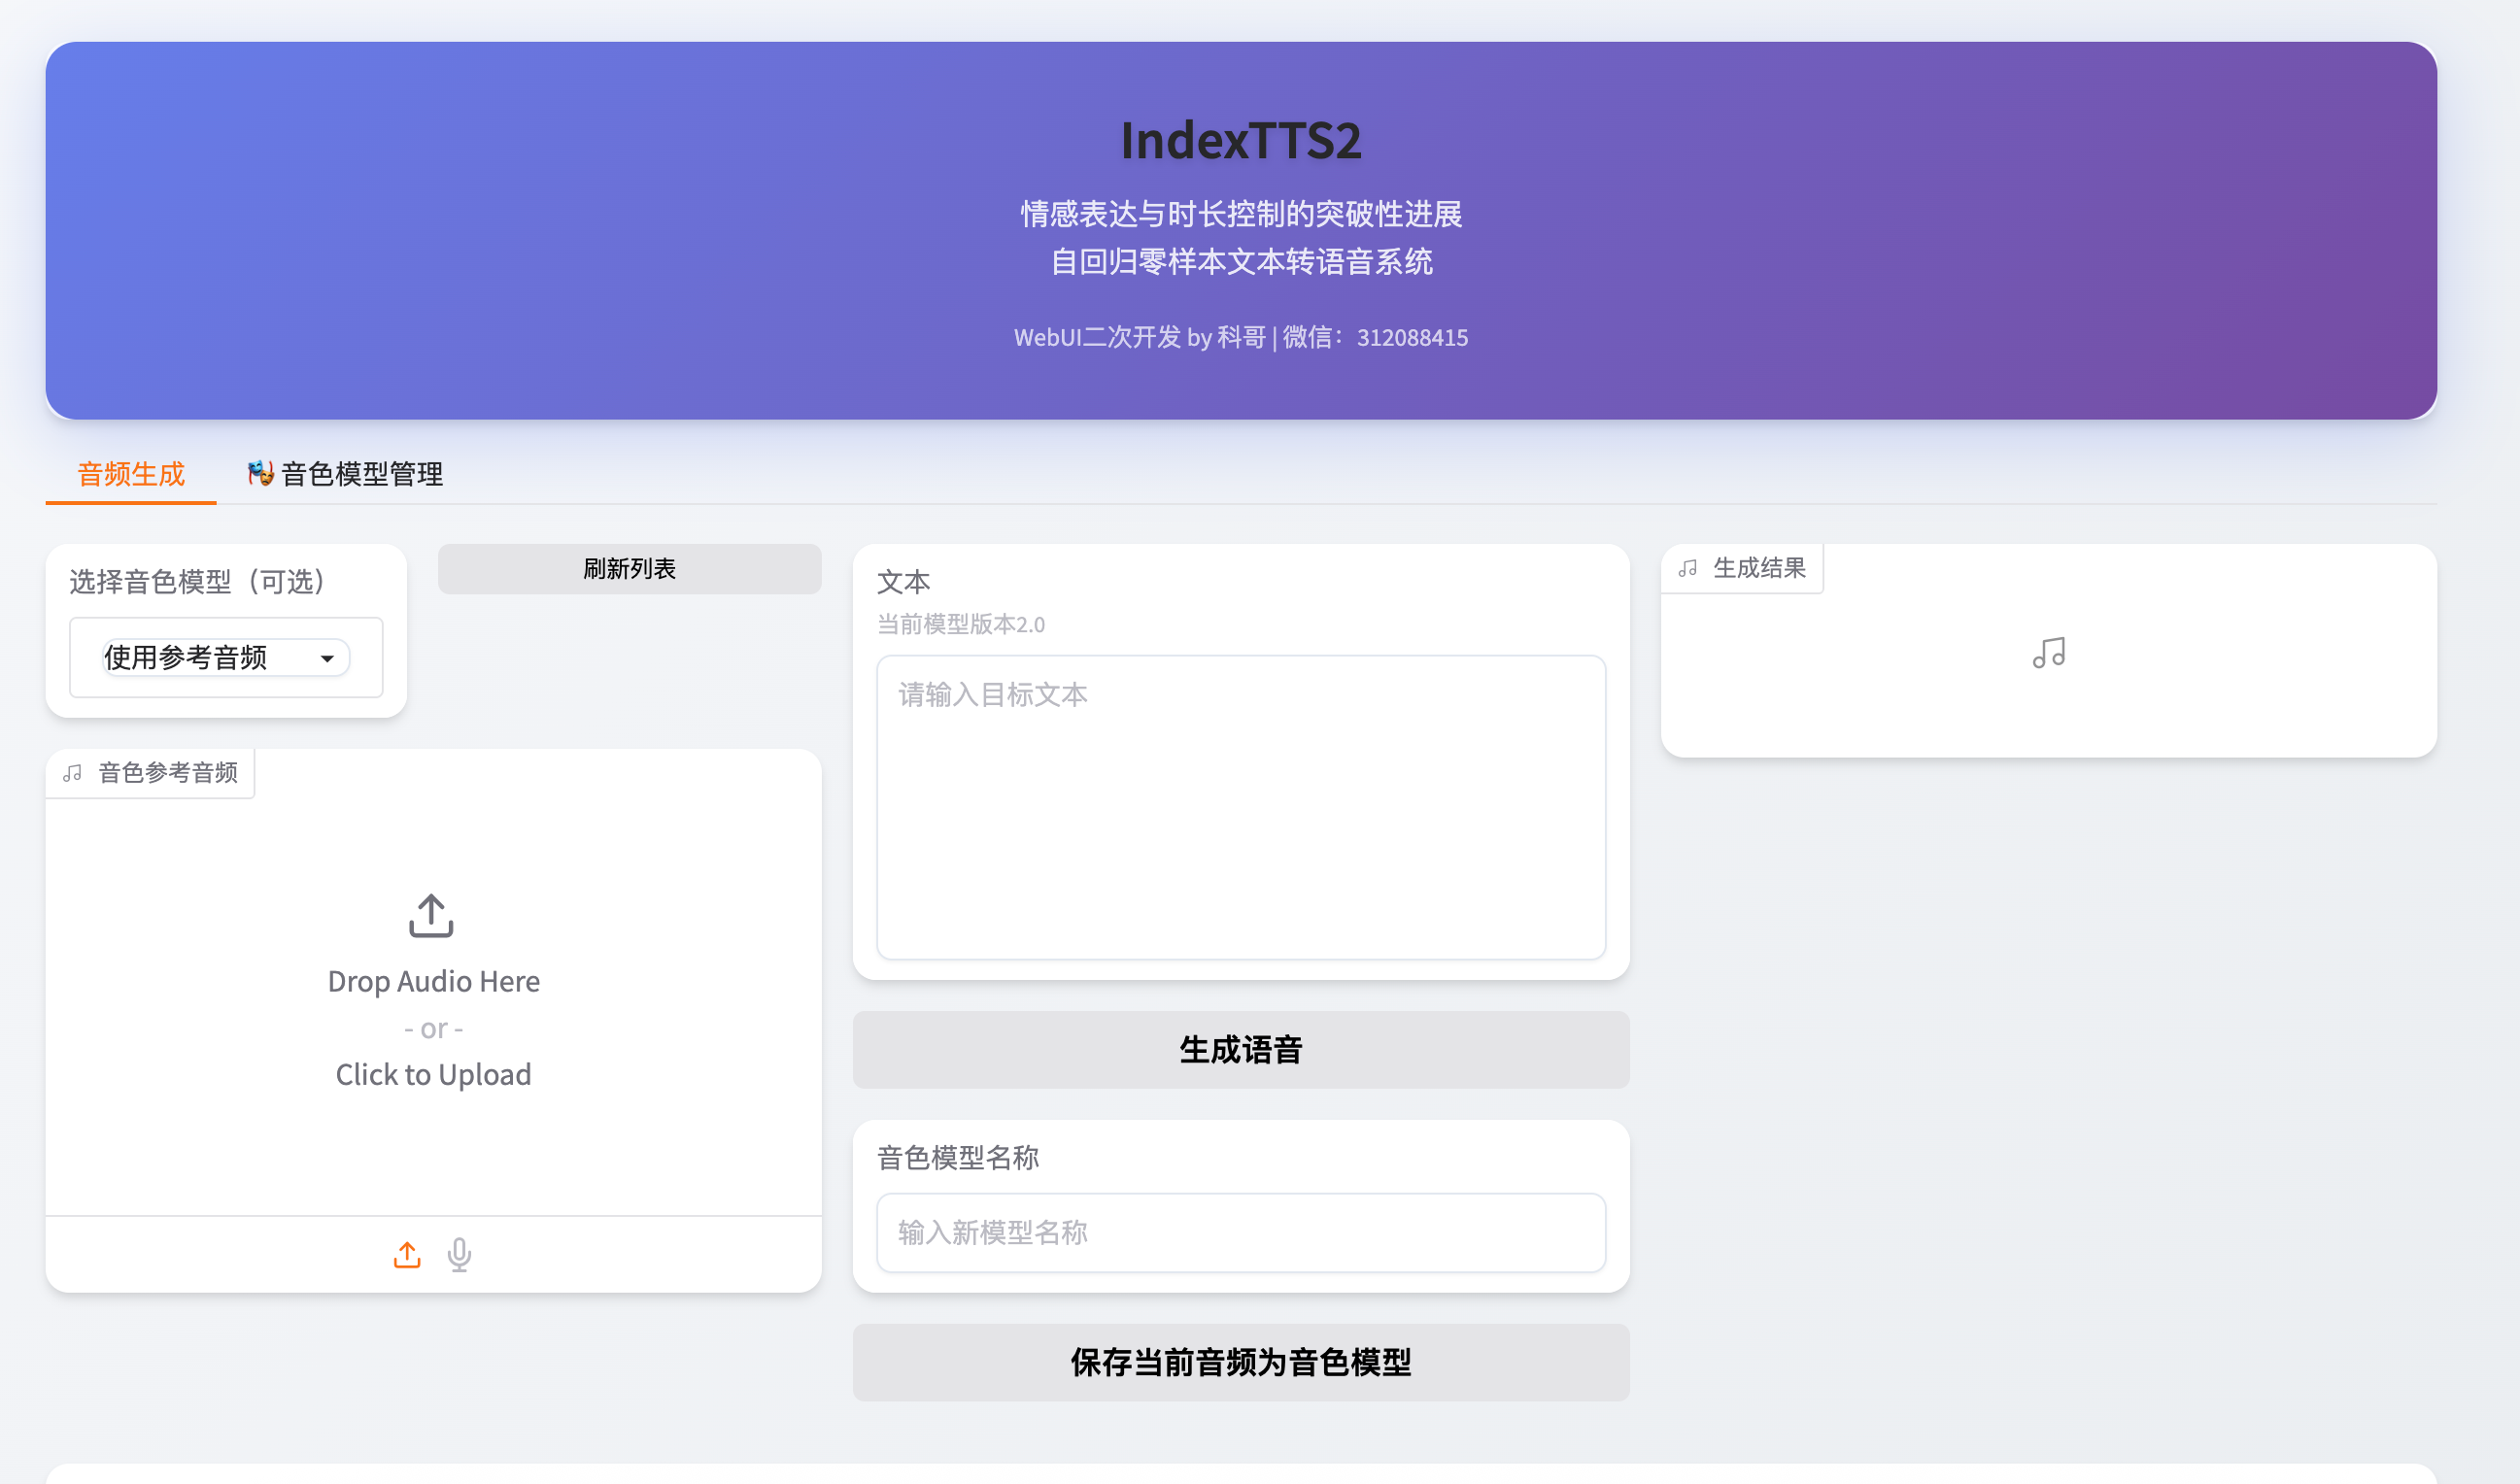
3.2 WebUI 主要功能区域说明
| 区域 | 功能描述 |
|---|---|
| 文本输入框 | 支持中文、英文及混合输入,最大长度约 500 字符 |
| 情感选择器 | 下拉菜单选择情感类型,并可通过滑块调节强度 |
| 参考音频上传 | 支持 WAV/MP3 格式,建议采样率 16kHz~44.1kHz |
| 语速调节 | ±50% 范围内调整,默认为 1.0 |
| 生成按钮 | 点击后触发合成,完成后提供播放预览 |
3.3 停止服务
正常关闭方式:在终端按 Ctrl+C。
若进程未退出,可手动终止:
ps aux | grep webui.py
kill <PID>
或重新运行 start_app.sh,脚本会自动检测并关闭已有进程。
4. 实践案例:为科普短视频生成配音
4.1 场景设定
假设我们要为一条关于“气候变化”的3分钟科普视频生成旁白,目标是语气专业但不失亲和力,略带紧迫感以增强说服力。
输入文本节选:
“过去十年,全球平均气温上升了0.8摄氏度。冰川加速融化,海平面持续上升,极端天气事件频发……我们正站在气候危机的临界点。”
参数配置建议:
- 情感类型:
calm(主体部分) + 局部切换为fearful(强调危机时) - 强度:0.6 ~ 0.7
- 语速:1.1(稍快,体现信息密度)
- 是否使用参考音频:否(使用默认男声)
4.2 分段生成策略
由于单次合成有长度限制,建议采用“分段合成 + 后期拼接”方式:
- 将脚本拆分为 4~5 段,每段控制在 60 秒以内;
- 在 WebUI 中逐段生成,保存为独立音频文件;
- 使用 FFmpeg 或 Audacity 进行合并与降噪处理。
# 示例:使用FFmpeg合并多个WAV文件
ffmpeg -f concat -safe 0 -i file_list.txt -c copy output_final.wav
其中 file_list.txt 内容格式为:
file 'segment_1.wav'
file 'segment_2.wav'
file 'segment_3.wav'
4.3 输出质量评估
生成后的音频具备以下特点: - 发音准确,无明显断句错误; - 重音和停顿符合中文语义节奏; - 情感过渡自然,关键句有适当强调; - 整体听感接近真人播音员水平。
相比传统TTS工具常见的“一字一顿”现象,IndexTTS2 在韵律建模方面表现优异。
5. 工程优化建议:提升批量处理效率
虽然 WebUI 适合小规模试用,但在实际生产中,往往需要自动化处理大量文案。以下是几种可行的优化路径。
5.1 API 化改造(推荐)
尽管官方未提供标准 REST API,但可通过修改 webui.py 添加轻量级接口支持。
示例代码片段(Flask 风格):
from flask import Flask, request, jsonify
import subprocess
import uuid
import os

app = Flask(__name__)

@app.route("/tts", methods=["POST"])
def generate_tts():
    data = request.json
    text = data.get("text")
    emotion = data.get("emotion", "neutral")
    intensity = data.get("intensity", 0.5)
    output_dir = "/root/index-tts/output"
    filename = f"{uuid.uuid4().hex}.wav"
    filepath = os.path.join(output_dir, filename)

    # 调用CLI模式或内部函数生成音频
    # 此处简化为调用shell脚本
    cmd = [
        "python", "inference.py",
        "--text", text,
        "--emotion", emotion,
        "--intensity", str(intensity),
        "--output", filepath
    ]

    try:
        subprocess.run(cmd, check=True)
        return jsonify({"status": "success", "audio_url": f"/output/{filename}"}), 200
    except Exception as e:
        return jsonify({"status": "error", "message": str(e)}), 500
部署后即可通过 HTTP 请求实现远程调用,便于集成到 CMS 或视频生成流水线中。
5.2 批量任务队列设计
对于每日数百条以上的配音需求,建议引入消息队列(如 RabbitMQ 或 Redis Queue)进行异步处理:
# 伪代码:任务入队
def enqueue_tts_task(script_id, text, config):
    task = {
        "id": script_id,
        "text": text,
        "params": config,
        "created_at": time.time()
    }
    redis_client.lpush("tts_queue", json.dumps(task))
消费者从队列中取出任务,调用 TTS 引擎生成音频,并更新数据库状态。
5.3 性能监控与资源调度
- 监控 GPU 利用率(
nvidia-smi),避免过载; - 设置并发上限(建议 ≤4 个同时合成任务);
- 使用
supervisord或systemd管理服务生命周期; - 日志记录每次生成的耗时、参数和结果状态,便于排查问题。
6. 常见问题与解决方案
6.1 首次运行卡住?
原因:模型文件较大(约 3~5GB),首次需从 HuggingFace Hub 下载。
解决方法: - 检查网络连接是否稳定; - 可尝试更换国内镜像源(如有); - 查看日志 /root/index-tts/logs/download.log 获取进度信息。
6.2 生成语音有杂音或断裂?
可能原因: - 输入文本含有特殊符号或乱码; - 显存不足导致推理中断; - 音频编码过程中出错。
建议: - 清理输入文本中的 emoji 和不可见字符; - 升级至更高显存设备; - 更换输出格式为 16bit PCM WAV。
6.3 如何自定义音色?
步骤: 1. 准备一段清晰的朗读音频(≥30秒,无背景噪音); 2. 在 WebUI 中上传至“Reference Audio”区域; 3. 开启“Use Reference”开关; 4. 调整“Style Strength”控制相似度(0.5~1.0 为佳);
注意:训练专属音色模型不在当前镜像功能范围内,仅支持推理阶段的音色参考。
7. 总结
IndexTTS2 V23 版本凭借其出色的情感控制能力、本地化部署安全性和高自然度语音输出,已成为短视频创作者、内容运营团队乃至企业级AI应用的理想选择。无论是制作知识类解说、电商带货口播,还是构建虚拟主播语音系统,它都能显著提升内容生产效率,降低人力成本。
更重要的是,结合合理的工程架构(如API封装、任务队列、数据库记录等),IndexTTS2 完全可以从小众工具演变为支撑大规模内容生产的基础设施。
未来,随着更多开发者参与生态建设,我们期待看到更多基于此框架的自动化视频生成方案涌现——真正实现“一键成片”的智能创作新时代。
8. 参考资料与技术支持
- GitHub 项目地址:https://github.com/index-tts/index-tts
- Issues 提交:https://github.com/index-tts/index-tts/issues
- 技术咨询微信:312088415(科哥)
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

邀请您加入社区
更多推荐
 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)