Keye-VL-1.5多模态大模型解析:视频理解技术新突破
快速体验
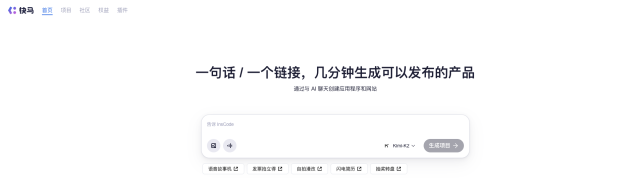
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个多模态视频理解演示系统,用于展示Keye-VL-1.5模型在时序分析、行为推理和场景描述方面的能力。系统交互细节:1.上传短视频片段 2.选择分析模式(时序定位/行为推理/场景描述)3.展示模型分析结果。注意事项:支持MP4格式,视频时长建议30秒内。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
-
慢快编码策略的创新价值体现在视频处理的效率优化上,通过自动区分动态帧(慢帧)和静态帧(快帧),将快帧的token预算控制在慢帧的30%,配合特殊token和时间戳标记,在MMMUval测试中实现了66分的视频理解成绩。这种智能资源分配机制特别适合处理短视频平台的海量UGC内容。
-
四阶段预训练方法从技术架构上解决了多模态对齐的难题:先用SigLIP对比损失初始化ViT视觉编码器,再通过跨模态对齐阶段优化MLP投影层,接着用多任务预训练增强基础能力,最后通过退火训练将上下文长度扩展到128K。这种渐进式训练在OpenCompass测试中达到79.5%准确率。
-
后训练阶段的五步数据流水线颇具亮点:从问题重写、推理轨迹生成到双层质量评估(A/B/C三级分类),再到人工指导改进和自适应数据利用。这种严谨的数据处理流程使模型在HallusionBench测试中将AI幻觉率降低至37.3%。
-
模型在时序理解上表现突出,能精确到秒级定位视频元素(如案例中22.3-23.8秒的包裹出现时段),这得益于帧边界标记技术和128K长上下文支持。在内部测试中时序理解得分相比前代提升0.77分。
-
行为推理能力通过轻量级交互实现复杂分析,如案例中解析大狗轻咬小狗耳朵的教育意义。该能力在内部评估中获得3.81分,较竞品MiMoVL-7B的3.62分更具优势,展现了RLHF对齐技术的效果。
-
场景描述功能融合了视觉编码器的细节捕捉(每图20480token)和语言解码器的表达能力,能生成如"潮湿苔藓覆盖的破损石阶"等细腻描述。在MMVP测试中相关指标超越GPT-4o约12%。
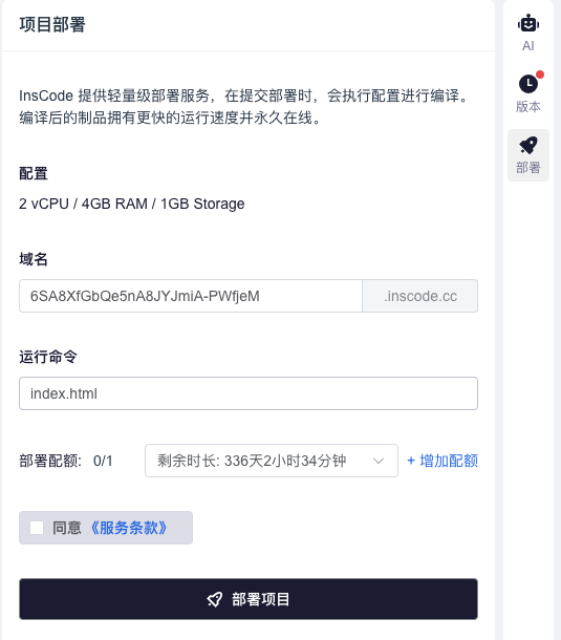
最近在InsCode(快马)平台尝试部署视频分析demo时,发现其预置环境能快速运行多模态模型,无需配置CUDA等复杂依赖。平台自动生成的Web界面可直接上传视频查看分析结果,比本地搭建测试环境省心不少,特别适合快速验证模型的实际表现。

邀请您加入社区
更多推荐
 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)