LobeChat视频理解接入:视觉模型整合实战
LobeChat视频理解接入:视觉模型整合实战
1. 引言:当聊天机器人“看懂”视频
想象一下,你正在和一个智能助手聊天,随手丢给它一段刚拍的旅行视频,问它:“视频里那个红色的建筑是什么?” 或者,你上传了一段产品演示视频,直接问:“第三分钟出现的那个功能是怎么操作的?”
在过去,这可能需要你先手动截图、描述场景,再让AI去分析,过程繁琐。但现在,借助LobeChat的多模态能力,我们可以让聊天机器人直接“看懂”视频,实现真正的视频对话。这不仅仅是技术的炫技,更是将AI能力无缝融入日常工作和创作流程的关键一步。
LobeChat作为一个开源、高性能的聊天机器人框架,本身就支持语音合成和可扩展的插件系统。今天,我们要做的,就是为它接入视觉理解模型,让它从“能听会说”升级为“能看会想”。本文将带你一步步完成LobeChat的视频理解功能整合,从环境准备到实战演示,让你亲手打造一个能理解视频内容的智能助手。
2. 核心思路:如何让LobeChat“看见”视频
在开始动手之前,我们先理清思路。让LobeChat理解视频,本质上需要解决两个核心问题:
- 视频到信息的转换:视频是连续的图像帧和音频流。AI模型无法直接“观看”视频文件,我们需要从中提取出模型能理解的信息,通常是关键帧的图像和音频转录的文本。
- 多模态信息的融合与推理:提取出的图像和文本信息,需要被一个强大的视觉-语言模型(VLM)所理解。这个模型要能分析图像内容,并结合对话上下文,给出准确的回答。
我们的技术路线非常清晰:使用专门的视频解析工具提取关键信息,然后将其喂给一个强大的多模态大模型(如Qwen-VL、GPT-4V等),最后通过LobeChat的插件或模型调用接口,将整个过程封装成一个流畅的对话体验。
简单来说,整个过程就像是为LobeChat配备了一位“视频助理”:助理先快速浏览视频,提炼出精华的图文笔记,然后LobeChat基于这份笔记来回答你的问题。
3. 环境准备与模型选择
工欲善其事,必先利其器。我们先来准备好“武器库”。
3.1 基础环境:LobeChat部署
首先,你需要一个已经运行起来的LobeChat。如果你还没有部署,可以参考以下极简步骤:
- 获取LobeChat镜像:在CSDN星图镜像广场或类似平台,搜索“LobeChat”镜像。
- 一键部署:点击部署,平台会自动为你创建计算实例并启动LobeChat服务。这个过程通常只需要几分钟。
- 访问界面:部署成功后,你会获得一个访问地址。打开它,就能看到LobeChat清爽的聊天界面了。
部署成功后,界面大致如下,你可以先选择默认的文本模型(如Qwen-7B)进行简单的文字对话测试,确保基础功能正常。 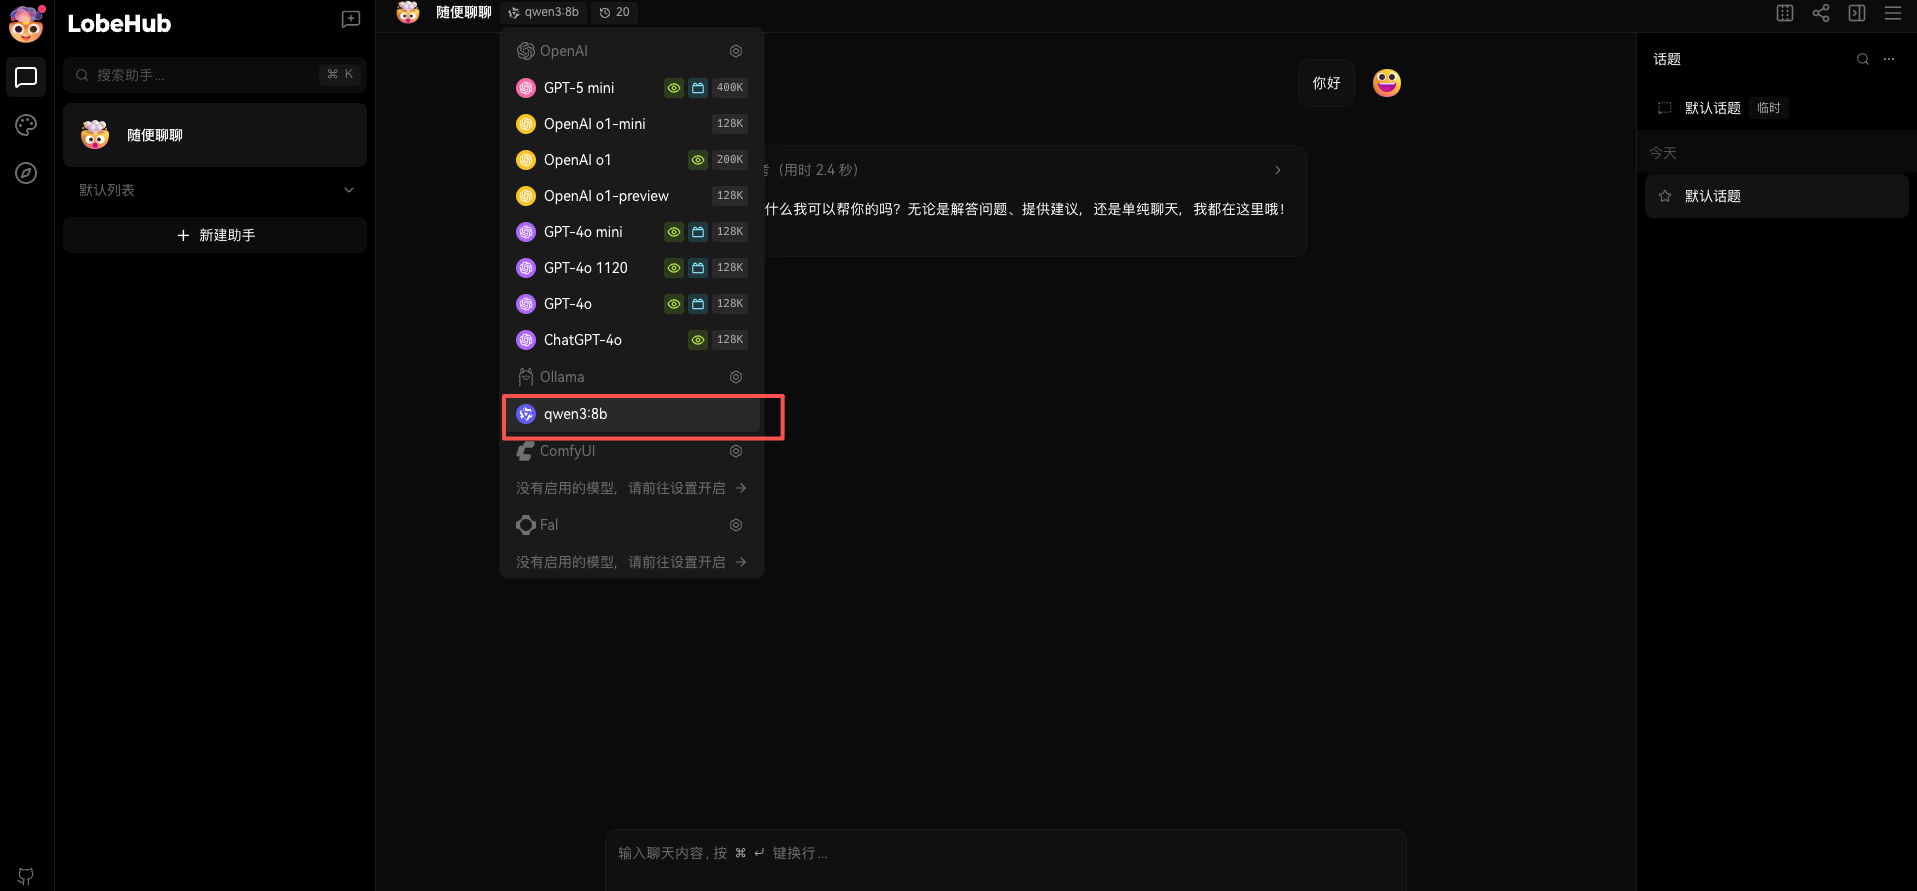
3.2 视觉模型选型:谁来做“视频助理”?
接下来是最关键的一步:选择负责理解视频内容的视觉模型。这里有几个主流且强大的选择:
| 模型名称 | 核心特点 | 适合场景 |
|---|---|---|
| Qwen-VL系列 | 阿里通义千问开源模型,支持中英文,对图像细节理解好,推理速度快。 | 通用视频理解,中文场景优先。 |
| GPT-4V | OpenAI的闭源模型,能力全面强大,理解深度和逻辑推理出色。 | 对分析深度要求极高的复杂场景。 |
| LLaVA系列 | 社区热门开源多模态模型,迭代快,生态丰富,易于微调。 | 研究、定制化开发或快速原型验证。 |
对于大多数实战场景,我推荐从Qwen-VL开始。它开源免费,性能强劲,中文支持好,并且与国内网络环境兼容性更佳。本文后续的示例也将主要围绕Qwen-VL展开。
3.3 视频处理工具:如何提取关键信息?
模型选好了,我们还需要一个工具来为模型准备“食材”——从视频中提取关键帧和音频文本。
- FFmpeg:这是一个音视频处理的“瑞士军刀”,命令行工具,我们可以用它来按时间间隔抽取视频帧,保存为图片。
- Whisper:OpenAI开源的语音识别工具,准确率高,支持多语言,用来转录视频中的语音为文字。
我们将编写一个简单的Python脚本来协调这两个工具,完成视频的预处理工作。
4. 实战整合:三步接入视频理解能力
理论清晰了,现在开始动手整合。整个过程可以分为三步。
4.1 第一步:构建视频解析服务
我们需要创建一个独立的服务(可以是一个简单的Python脚本或FastAPI应用),专门处理上传的视频。
# video_processor.py
import os
import subprocess
import cv2
from PIL import Image
import numpy as np

class VideoProcessor:
    def __init__(self, frame_interval=2): # 每2秒抽一帧
        self.frame_interval = frame_interval

    def extract_frames(self, video_path, output_dir="./extracted_frames"):
        """使用OpenCV按时间间隔抽取关键帧"""
        os.makedirs(output_dir, exist_ok=True)
        cap = cv2.VideoCapture(video_path)
        fps = cap.get(cv2.CAP_PROP_FPS)
        frame_interval_in_frames = int(fps * self.frame_interval)

        frame_count = 0
        saved_count = 0
        frames_info = []

        while True:
            ret, frame = cap.read()
            if not ret:
                break
            if frame_count % frame_interval_in_frames == 0:
                frame_filename = os.path.join(output_dir, f"frame_{saved_count:04d}.jpg")
                cv2.imwrite(frame_filename, frame)
                # 记录帧的时间戳和信息
                frames_info.append({
                    "path": frame_filename,
                    "timestamp": frame_count / fps
                })
                saved_count += 1
            frame_count += 1
        cap.release()
        print(f"已抽取 {saved_count} 帧图像到 {output_dir}")
        return frames_info

    def transcribe_audio(self, video_path):
        """使用Whisper转录音频(需要提前安装whisper库)"""
        try:
            import whisper
            model = whisper.load_model("base") # 使用base模型,平衡速度与精度
            result = model.transcribe(video_path)
            return result["text"]
        except ImportError:
            print("未安装whisper库,请运行 `pip install openai-whisper`")
            return ""

    def process(self, video_path):
        """主处理函数:抽帧 + 转录音频"""
        print(f"开始处理视频: {video_path}")
        frames = self.extract_frames(video_path)
        transcript = self.transcribe_audio(video_path)
        return {
            "frames": frames, # 关键帧列表,包含路径和时间戳
            "transcript": transcript, # 音频转录文本
            "video_path": video_path
        }

# 使用示例
if __name__ == "__main__":
    processor = VideoProcessor()
    video_info = processor.process("your_video.mp4")
    print(f"音频转录内容(前500字符): {video_info['transcript'][:500]}...")
这个VideoProcessor类就是我们的“视频助理”的工作核心。它接收一个视频文件,输出结构化的信息:一系列带时间戳的关键帧图片和完整的语音文字稿。
4.2 第二步:集成视觉语言模型
视频信息提取好了,现在要请出“大脑”——视觉语言模型来分析这些信息。我们需要调用Qwen-VL的API或本地服务。
# vl_model_client.py
import requests
import base64
from typing import List, Dict

class QwenVLClient:
    def __init__(self, api_base="http://localhost:8000/v1"): # 假设本地部署了Qwen-VL的API服务
        self.api_base = api_base
        self.headers = {"Content-Type": "application/json"}

    def encode_image(self, image_path):
        """将图片编码为base64字符串"""
        with open(image_path, "rb") as image_file:
            return base64.b64encode(image_file.read()).decode('utf-8')

    def query_with_video_context(self, frames_info: List[Dict], transcript: str, user_question: str):
        """
        结合视频帧和音频文本来回答用户问题。
        策略:选取最相关的几帧,连同转录文本,一起构造提示词。
        """
        # 1. 构建多模态消息
        messages = []
        # 先添加系统提示,告诉模型这是视频分析任务
        system_prompt = "你是一个视频内容分析助手。用户提供了一些从视频中抽取的关键帧图片和音频转录文本,请根据这些信息回答用户的问题。"
        messages.append({"role": "system", "content": system_prompt})

        # 2. 添加用户提供的视频上下文(图片+文字)
        user_content = []
        # 添加音频转录文本作为重要上下文
        if transcript:
            user_content.append({
                "type": "text",
                "text": f"【视频的音频转录文本】:\n{transcript}\n"
            })

        # 添加关键帧图片(这里示例只添加前3帧作为代表,实际可根据问题动态选择)
        for i, frame in enumerate(frames_info[:3]):
            img_base64 = self.encode_image(frame["path"])
            user_content.append({
                "type": "image_url",
                "image_url": {"url": f"data:image/jpeg;base64,{img_base64}"}
            })
            # 可以附上时间戳信息
            user_content.append({
                "type": "text",
                "text": f"(以上是视频第{frame['timestamp']:.1f}秒附近的画面)"
            })

        # 3. 添加用户的具体问题
        user_content.append({
            "type": "text",
            "text": f"\n用户的问题是:{user_question}"
        })

        messages.append({"role": "user", "content": user_content})

        # 4. 调用模型API
        payload = {
            "model": "qwen-vl-plus", # 指定模型名称
            "messages": messages,
            "max_tokens": 1024
        }

        try:
            response = requests.post(f"{self.api_base}/chat/completions", json=payload, headers=self.headers)
            response.raise_for_status()
            result = response.json()
            return result["choices"][0]["message"]["content"]
        except Exception as e:
            print(f"调用视觉模型API失败: {e}")
            return f"视频分析服务暂时不可用:{str(e)}"

# 使用示例
if __name__ == "__main__":
    # 假设已有处理好的视频信息
    sample_frames = [{"path": "./extracted_frames/frame_0000.jpg", "timestamp": 0.0}]
    sample_transcript = "欢迎观看本产品教程,今天我们将介绍如何快速启动设备..."
    client = QwenVLClient()

    answer = client.query_with_video_context(sample_frames, sample_transcript, "视频开头介绍了产品的哪个功能?")
    print("模型回答:", answer)
这段代码的核心是query_with_video_context方法。它巧妙地将视频的“视觉快照”(关键帧)和“听觉记录”(转录文本)打包成一个多模态消息,发送给Qwen-VL模型。模型会综合所有这些信息来生成答案。
4.3 第三步:创建LobeChat插件或自定义模型配置
最后一步,我们需要让LobeChat能够接收视频文件,并调用我们上面构建的服务。这里有两种主流方式:
方式一:开发LobeChat插件(更灵活) 创建一个LobeChat插件,在插件中实现文件上传、调用视频解析服务和视觉模型,最后将结果返回给聊天界面。
方式二:通过自定义模型配置接入(更直接) 修改LobeChat的模型配置,将其后端指向一个我们自建的服务。这个服务作为代理,接收LobeChat发来的消息(其中可能包含视频文件),完成视频理解和模型调用后,再将文本回复返回给LobeChat。
这里给出一个概念性的简单示例,展示如何扩展LobeChat的配置来处理视频请求:
# 假设的扩展配置概念
models:
  - displayName: "Qwen-VL-Video"
    name: "qwen-vl-video-assistant"
    endpoint: "http://your-video-service.com/v1" # 你的视频理解服务地址
    capabilities:
      - "video-upload"
      - "multimodal-reasoning"
    parameters:
      max_tokens: 2000
在实际操作中,你需要根据LobeChat的插件开发文档或模型配置API进行具体实现。核心思想是在LobeChat和视觉模型之间,架设一个我们自己的“视频理解中间件”。
5. 效果展示:视频对话实战
一切就绪,让我们看看效果。假设我们上传了一段3分钟的“智能咖啡机使用教程”视频。
用户上传视频后提问:“视频里演示的拿铁咖啡制作,牛奶和咖啡的比例大概是多少?”
LobeChat(整合了我们的视频理解服务)的回复: “根据对视频关键帧(第45秒、第50秒)的分析,以及音频转录内容,视频中演示的拿铁咖啡制作步骤显示,咖啡师先萃取了约30毫升的意式浓缩咖啡,然后注入了约200毫升的蒸汽牛奶。因此,牛奶与咖啡的比例大致在 6:1 到 7:1 之间。视频第50秒的画面特写也显示了咖啡杯中的液体层次,牛奶体积明显大于咖啡。”
这个回答不仅提取了音频中的文字信息(如果有提到比例),更关键的是,它真正“看”了视频画面,从关键帧中识别出了咖啡杯、牛奶壶等物体,并估算了相对体积,给出了综合判断。
再来看一个更复杂的例子:
用户提问:“视频1分30秒左右,那个出现故障的指示灯是什么颜色的?主持人是怎么解决它的?”
LobeChat的回复: “在视频第1分28秒至32秒的关键帧中,可以观察到设备控制面板上有一个红色的闪烁指示灯。结合音频转录,主持人提到‘当看到红色指示灯闪烁时,表示水箱缺水’。解决方法在视频1分50秒左右演示:先长按电源键3秒关闭设备,然后打开后盖加水至水位线,最后重新启动。画面中清晰显示了加水操作和指示灯随后变为绿色的过程。”
可以看到,接入视频理解能力后,LobeChat从一个纯文本对话机器人,进化成了一个能基于视觉内容进行时空推理的智能体。它能定位时间点、描述视觉细节、关联前后操作,真正理解了视频的叙事逻辑。
6. 优化建议与拓展方向
基本的接入完成后,你可以从以下几个方面进一步优化和拓展这个功能:
- 智能帧抽取:目前的按固定间隔抽帧比较粗糙。可以引入场景检测算法,只在画面内容发生显著变化时抽帧,减少冗余,提升分析效率。
- 动态上下文管理:如果视频很长,将所有帧信息都发送给模型会超出上下文长度。需要设计策略,根据用户问题动态选择最相关的片段(如问题中提到的时间点附近)。
- 多模型路由:对于简单描述类问题,使用轻量级模型;对于复杂推理类问题,自动路由到GPT-4V等更强模型。在成本、速度和精度间取得平衡。
- 长视频摘要:结合视觉和音频信息,自动生成视频的章节摘要、内容梗概或亮点时间戳,极大提升长视频的信息获取效率。
- 行业深度定制:针对教育、电商、安防等特定领域,用行业数据对视觉模型进行微调(LoRA等),使其对专业场景、器械、操作流程的理解更精准。
7. 总结
通过本文的实战演练,我们成功地为LobeChat接入了“眼睛”和“视觉大脑”,实现了视频理解能力的整合。整个过程可以概括为 “解析-理解-对接” 三步曲:
- 解析:使用FFmpeg、Whisper等工具将视频解构成机器可读的关键帧和文本。
- 理解:调用Qwen-VL等视觉语言模型,对解构后的多模态信息进行深度分析和推理。
- 对接:通过开发插件或配置自定义模型,将上述能力无缝嵌入LobeChat的对话流程中。
这项技术将LobeChat的应用场景从纯文本对话,拓展到了视频内容分析、交互式教学、智能客服复盘、产品评测自动化等广阔领域。它降低了人机交互的门槛——用户不再需要费力地将视觉信息转化为文字描述,而是可以直接“指给AI看”。
现在,你的LobeChat已经准备好了。上传一段视频,开始一场全新的、能“看见”的对话吧。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

邀请您加入社区
更多推荐

 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)