Android开发实战:基于WebSocket的语音通话实现与避坑指南
快速体验
在开始今天关于 Android开发实战:基于WebSocket的语音通话实现与避坑指南 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
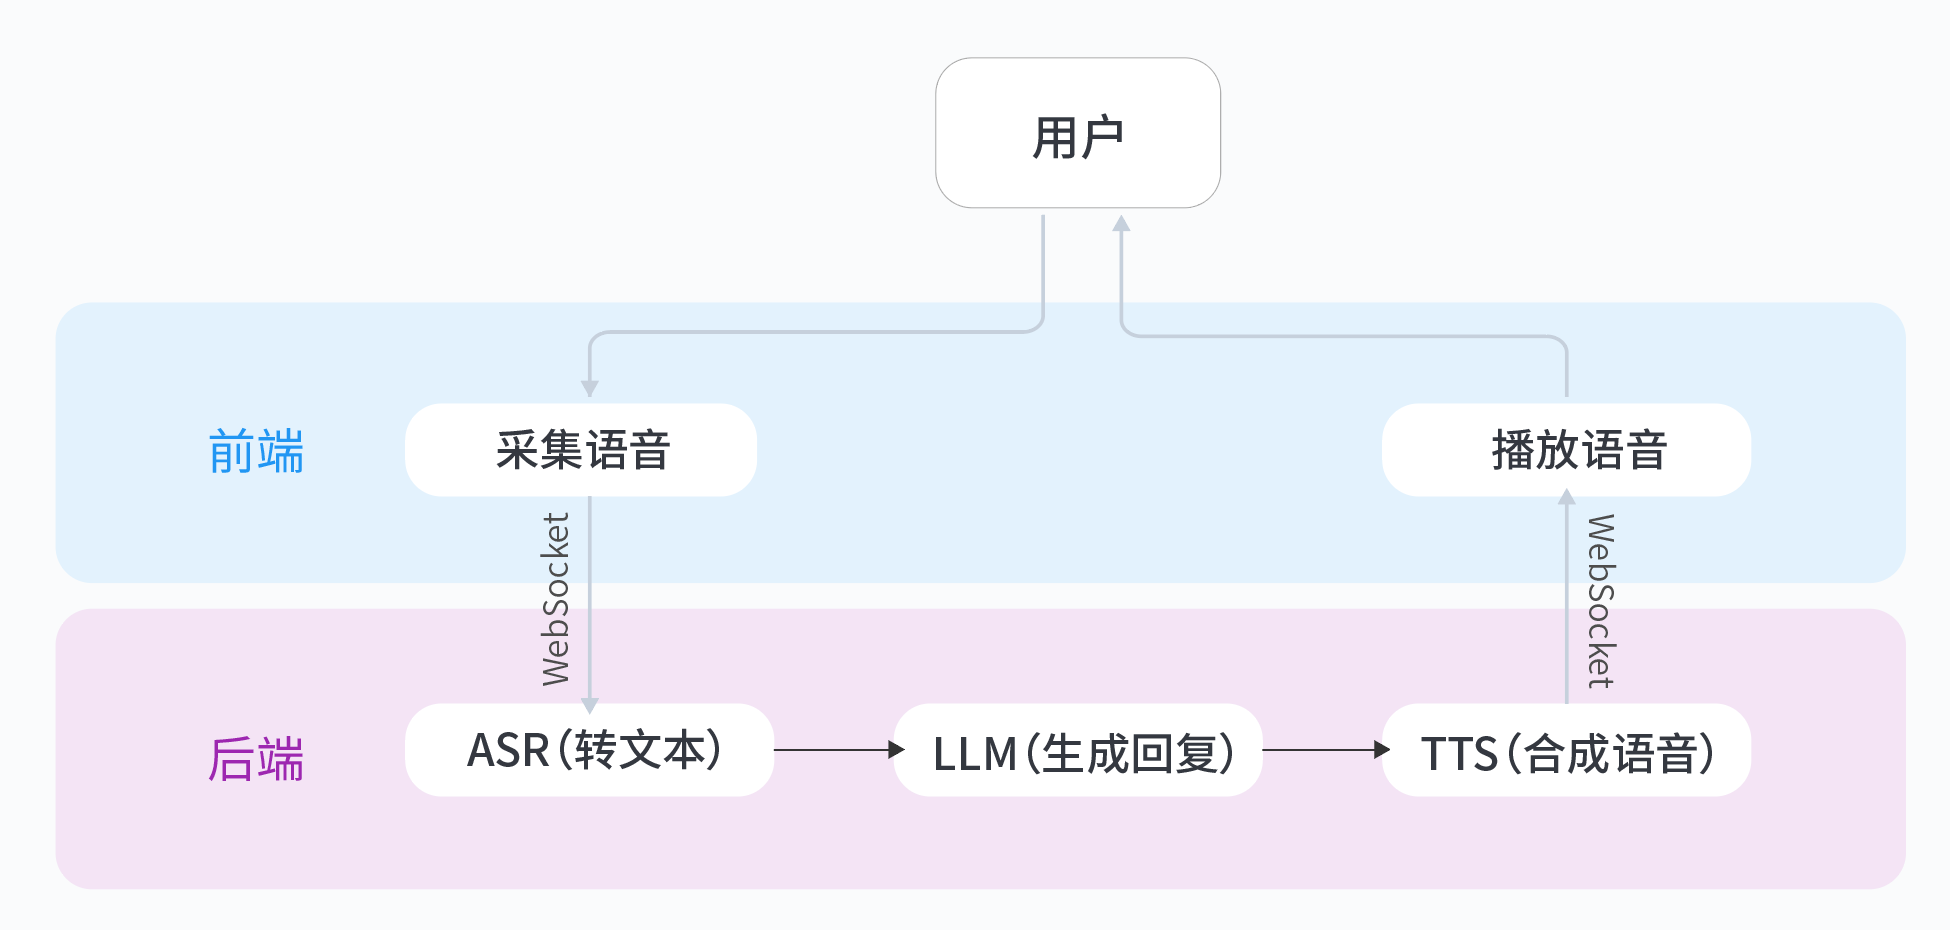
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
Android开发实战:基于WebSocket的语音通话实现与避坑指南
背景与痛点
在移动应用开发中,实时语音通话功能一直是个技术难点。传统的解决方案往往面临几个核心问题:
- 高延迟问题:HTTP轮询或长连接方案通常有200ms以上的延迟,对话体验差
- 设备兼容性:不同Android机型对音频采集的采样率、缓冲区大小支持不一
- 网络适应性:移动网络环境不稳定,容易导致语音卡顿或中断
- 功耗控制:持续运行的音频采集和网络传输会快速消耗电量
技术选型:WebSocket的优势
为什么选择WebSocket而不是其他方案?
-
对比Socket.IO:
- WebSocket是底层协议,没有额外的协议开销
- 连接建立后维持长连接,心跳包开销更小
- 适合对延迟敏感的场景
-
对比RTMP:
- WebSocket更轻量,不需要复杂的流媒体服务器
- 支持双向通信,适合交互式场景
- 可以灵活控制数据分片策略
核心实现方案
1. Android音频采集与播放
音频采集使用AudioRecord,播放使用AudioTrack:
// 音频采集配置
val sampleRate = 44100
val channelConfig = AudioFormat.CHANNEL_IN_MONO
val audioFormat = AudioFormat.ENCODING_PCM_16BIT
val bufferSize = AudioRecord.getMinBufferSize(sampleRate, channelConfig, audioFormat)

val audioRecord = AudioRecord(
    MediaRecorder.AudioSource.MIC,
    sampleRate,
    channelConfig,
    audioFormat,
    bufferSize
)

// 音频播放配置
val audioTrack = AudioTrack(
    AudioManager.STREAM_VOICE_CALL,
    sampleRate,
    AudioFormat.CHANNEL_OUT_MONO,
    audioFormat,
    bufferSize,
    AudioTrack.MODE_STREAM
)
2. PCM编码与WebSocket传输
建议使用OPUS编码压缩音频数据:
// 初始化OPUS编码器
val opusEncoder = OpusEncoder().apply {
    init(sampleRate, 1, OpusApplication.OPUS_APPLICATION_VOIP)
}

// 编码并发送数据
val pcmBuffer = ByteArray(bufferSize)
val encodedBuffer = ByteArray(bufferSize / 2) // OPUS压缩后大小

audioRecord.startRecording()
while (isRecording) {
    val read = audioRecord.read(pcmBuffer, 0, bufferSize)
    val encodedSize = opusEncoder.encode(pcmBuffer, 0, read, encodedBuffer, 0, encodedBuffer.size)
    webSocket.send(encodedBuffer.copyOf(encodedSize))
}
3. WebSocket连接管理
使用OkHttp实现WebSocket客户端:
val client = OkHttpClient.Builder()
    .pingInterval(10, TimeUnit.SECONDS) // 心跳保活
    .build()

val request = Request.Builder()
    .url("wss://yourserver.com/voice")
    .build()

val webSocket = client.newWebSocket(request, object : WebSocketListener() {
    override fun onMessage(webSocket: WebSocket, bytes: ByteArray) {
        // 收到音频数据后解码播放
        val pcmData = opusDecoder.decode(bytes, 0, bytes.size)
        audioTrack.write(pcmData, 0, pcmData.size)
    }

    override fun onFailure(webSocket: WebSocket, t: Throwable, response: Response?) {
        // 实现重连逻辑
    }
})
性能优化技巧
1. 网络抖动缓冲
实现一个简单的抖动缓冲:
val audioBuffer = LinkedList<ByteArray>()
var isPlaying = false

fun onAudioReceived(data: ByteArray) {
    synchronized(audioBuffer) {
        audioBuffer.add(data)
        if (!isPlaying && audioBuffer.size > 3) { // 缓冲3个包后开始播放
            playFromBuffer()
        }
    }
}

fun playFromBuffer() {
    isPlaying = true
    while (audioBuffer.isNotEmpty()) {
        val data = audioBuffer.removeFirst()
        audioTrack.write(data, 0, data.size)
    }
    isPlaying = false
}
2. 音频处理优化
- 使用WebRTC的噪声抑制模块
- 实现简单的AGC(自动增益控制)
- 在弱网环境下动态调整编码比特率
避坑指南
1. Android权限问题
必须声明并动态请求这些权限:
<uses-permission android:name="android.permission.RECORD_AUDIO" />
<uses-permission android:name="android.permission.INTERNET" />
<uses-permission android:name="android.permission.FOREGROUND_SERVICE" />
2. 后台保活方案
- 使用前台服务保持活跃
- 实现WorkManager定期唤醒
- 合理设置网络超时和重试策略
3. 版本适配要点
- Android 8.0以上需要注意后台限制
- 不同厂商的ROM可能有特殊的电源管理策略
- 部分设备需要单独处理音频焦点
延伸思考
实现基础通话功能后,可以考虑以下扩展方向:
- 如何实现多方通话?需要引入混音服务器还是使用Mesh网络?
- 视频通话如何与语音同步?时间戳同步策略如何设计?
- 在弱网环境下,如何实现智能降质(如切换到更低的采样率)?
如果你想快速体验AI语音交互,可以参考从0打造个人豆包实时通话AI实验,它提供了完整的语音识别、对话生成和语音合成链路,对于理解实时语音处理很有帮助。我在实际操作中发现它的API调用非常简洁,适合快速验证想法。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 10
 0
- 0


 已为社区贡献5条内容

所有评论(0)