RTC中实时编码器Libvpx:vp9-svc的优化实践
目前国内实时互动和视频会议产品大部分还是用的h.264和hevc做为视频编解码器的方案,而很少使用vp9,即使有svc可用,是为什么呢?其根本原因是 H.264/HEVC 在硬件兼容性、产业链成熟度和编码实时性上拥有碾压性优势,而 VP9 的“免专利费”和“SVC”优势在现实场景中并未能转化为足够的竞争力。H.264最早也最成熟,几乎所有现代设备的芯片中,都内置了专门的 H.264 编解码电路。这使得编码解码效率极高、CPU占用和功耗极低。x264,openh264也经过长年优化,延时和功耗基本也没大问题。HEVC作为接替者,其硬件支持也已非常普及。而vp9硬件支持至今仍不充分,libvpx在google公司的主导下,优化并不充分。大量设备将不得不依赖效率低下的软件解码,导致CPU占用飙升、设备发热、电池快速耗尽等问题,严重影响用户体验。VP9-SVC通过一次编码生成多层视频流,能更好地适应不同网络条件。由于优化不力和业界很少有优秀的实践案例,也只能处于理想丰满,现实骨感的尴尬境地。
经过分析,vp9其实有很大的优化空间。
一、我们从libvpx的speed预设和编码性能开始讨论:
在 libvpx speed=9(最快预设)下,运动估计(ME)模块的优化策略可以概括为“一切从简、能省就省”。具体实现手段可分为“搜索策略、迭代深度、代价函数、并行粒度”四个维度:
- 整像素搜索
• 搜索形状:直接采用 菱形(DIA) 或 4-步长十字(EPZS),半径从 speed=0 的 64 降到 2~4 像素。
• 早期退出:只要 SAD/SSD 小于动态阈值(与当前 QP 相关)立即终止,不再尝试更小分区。 - 亚像素细化
• 关闭 1/4 像素全搜索,仅做 1/2 像素一次插值 + 中心比较,省去 Hadamard 变换。
• subpel_iters 从 3~5 次降到 1 次,且跳过 chroma 分量计算。 - 多参考帧 & 分块深度
• 最多只搜 2 个参考帧(前一帧 + 黄金帧),后续参考直接复用 MV。
• 64×64→32×32→16×16 分裂决策改为 单层方差阈值:若 64×64 误差小于阈值,直接标记为 SKIP,不再递归。 - 代价函数与缓存
• 代价函数从 SATD+λ*bits 简化为 SAD;关闭 Trellis、RDO 重算。
• MV 缓存共享:整帧级 hash 表缓存已算过的 MV,相同 block 直接复制。 - SIMD & 并行
• 所有 SAD/SSE 计算使用 AVX2/AVX-512 一次处理 32/64 像素,减少函数调用开销。
• 在 tile-row 并行框架下,ME 任务被切成 一行一个 job,避免线程同步等待。
一句话总结:speed=9 下的 ME 用“小窗口、一步亚像素、单层决策、SAD 代价”把原本最耗时的模块压到极限,换来 20× 以上的速度提升,但 RD-loss 也相应增大。
SVC L3T3:Speed=9对比x264最后测试对比,编码复杂度高30%,压缩率反而落后30%~40%。
二、libvpx的RTC编译选项问题:
由于编码复杂度问题,libvpx为RTC场景专门提供了一个编译配置选项configure --enable-realtime-only.通过开启这个配置编译后,你会发现编码压缩工具有很大的限制,在这个配置下很难提升压缩率。
从以上两点分析,要使压缩率有一定保障。至少需要关闭enable-realtime-only的编译配置选项,还需要把预设降到speed=7。
三、libvpx本身工程实现问题
Libvpx中dct和idct变换模块有重复的二次转置问题,svt-av1里同样存在。大量的simd指令集并行优化没有实现,可参考的路径是dav1d,svt-av1工程。Vp9和av1有大量同算法的模块实现,vp9更像是av1的一个子集。
四、计算去重优化
Speed=7, 在编码器流水线中,SAD 和 DCT 相关运算会存在大量重复的块级计算。这是传统混合编码架构(VP9/AV1/H.26x 等)的一个经典冗余问题。
1. 重复运算的典型场景
场景一:运动估计(ME)→ 模式决策(Mode Decision)的重复
|
阶段 |
计算内容 |
块尺寸 |
|
整像素 ME |
SAD 搜索最佳 MV |
4×4 ~ 64×64(多种划分) |
|
亚像素 ME |
SATD(类 DCT)精化 1/2、1/4、1/8 像素 |
同上 |
|
模式决策/RDO |
完整 DCT/ADST + 量化 + 熵编码代价 |
最终选定划分 |
重复点:一个候选块可能在整像素 SAD、亚像素 SATD、RDO 全变换中被计算 3 次。
场景二:码率控制(RC)→ 实际编码的重复
|
阶段 |
计算内容 |
|
RC 预分析 |
快速 DCT 或方差估计,预测比特数 |
|
正式编码 |
完整 DCT/ADST + 量化 |
重复点:RC 阶段为了估计复杂度做的"快速变换"和后续正式编码的变换是同一残差块。
场景三:多参考帧/多模式搜索
运动估计对每个参考帧、每个预测模式(单向/双向、不同块划分)都计算 SAD/SATD,最终只选一个,其余全部浪费。
Speed=7的预设实现已经做了大量的简化,导致重复运算的绝对数量已经很少,但结构性的冗余依然存在:
|
模块 |
Speed 7 当前做法 |
残余问题 |
|
整像素 ME |
仅搜索最近参考帧,MV 范围极小,SAD 用 SIMD |
同一位置在不同块划分(4×4/8×8/16×16)间重复计算 SAD |
|
亚像素 ME |
完全禁用或仅做 1/2 像素 |
无 |
|
模式决策 |
仅评估少数几种模式(SKIP、INTER、NEAREST) |
残差从像素域到变换域的搬运仍独立进行 |
|
变换/量化 |
仅评估单一 tx_size,跳过部分尺寸 |
每块仍做一次完整 DCT,无缓存 |
|
码率控制 |
简化的单遍 CBR,基于历史统计 |
无预分析,RC 估计与正式编码无联动 |
关键洞察:Speed 7 的瓶颈已从"运算复杂度"转向"数据搬运"和"分支预测失败"。重复块运算的优化应聚焦于减少内存访问和跨模块状态复用。
2.优化路径规划
路径一:块级 SAD 缓存池(整像素 ME 内)
目标:消除不同划分尺寸间的重复 SAD 计算。
原理:在 speed 7 中,一个 32×32 的 CTU 会被尝试划分为 16×16、8×8、4×4 等子块。计算 32×32 的 SAD 时,其四个 16×16 子块的 SAD 其实已经隐含在求和过程中;反之,四个 16×16 的 SAD 可以累加得到 32×32 的 SAD。
实现:
- 在 CTU 级别(64×64 或 32×32)建立 SAD 缓存表,以 (x, y, w, h, ref_idx, mv) 为 key。
- 采用分层累加策略:
- 计算 4×4 基础 SAD → 存入缓存
- 8×8 SAD = 4 个 4×4 SAD 之和(查表 + 加法)
- 16×16 SAD = 4 个 8×8 SAD 之和
- 以此类推
- 使用 SIMD 的 psadbw(SSE)或 uabd + uaddlv(NEON)计算 4×4 基础单元,确保底层效率。
收益估计:在 speed 7 的极简搜索下,ME 占比约 30-40%,此优化可减少 20-30% 的 SAD 指令数。
路径二:残差复用流水线(ME → TQ 零拷贝)
目标:消除 ME 阶段计算残差后,正式编码时重新从内存读取像素并计算残差的冗余。
现状问题:
- ME 阶段:当前块像素 - 参考块像素 = 残差(存在于寄存器/SIMD 向量中)
- 正式编码:重新从 L1/L2 缓存读取当前块和参考块像素,重新计算残差,再做 DCT
实现:
- 在 ME 引擎中维护一个"残差环形缓冲区":
- ME 计算 SAD 时,同时将残差块写入片上缓冲区(每个 CTU 一个,大小 64×64 字节 = 4KB)
- 若该块最终被选中(通过 early decision),直接将残差指针传递给 TQ 模块
- 软件层面模拟:
- 在 libvpx 的 vp9_encode_block 中,增加 residual_reuse 标志
- 当 speed >= 8 且 ME 已计算该块时,跳过 vp9_subtract_block,直接从预计算缓冲区读取残差
- 条件:仅对 INTER 模式且 ME 成功找到匹配块的情况启用。INTRA 模式无参考块,不适用。
收益估计:减少一次完整的当前块+参考块内存读取(约 2×32×32 = 2KB 每块),对内存受限的嵌入式场景收益显著。
路径三:SATD/DCT 结果缓存(亚像素 & 模式决策)
目标:speed 7 虽禁用亚像素,但在某些实现中仍有 1/2 像素或模式间的快速 SATD。缓存这些结果。
实现:
- 建立一个轻量级的 SATD 哈希缓存(LRU,每帧 1024 条目足够):
- Key: (ref_frame, mv_x, mv_y, block_size, src_x, src_y)
- Value: satd_cost, estimated_bits
- 在 vp9_pick_inter_mode 中,先查缓存,命中则跳过 SATD 计算。
- 由于 speed 7 的候选模式极少,缓存命中率可做到 60%+(相邻块运动向量高度相关)。
收益估计:在 speed 7 中 SATD 占比不高(约 5-10%),但实现成本极低,适合作为"免费优化"。
路径四:基于方差的 SKIP 模式快速决策(绕过 DCT)
目标:在正式做 DCT 之前,用像素域统计量判断该块是否极大概率是 SKIP 模式。
原理:如果当前块与参考块差异极小(SAD 接近 0,方差极低),则变换后系数几乎全为 0,SKIP 模式最优。此时无需进入 DCT。
实现:
- 在 ME 的 SAD 计算后,增加一个零成本分支:
plain
if (sad < threshold_skip) {
// threshold_skip = 4 * block_pixels (经验值,约每像素 1/4 个亮度差)
mode = SKIP;
skip_dct = 1;
estimated_bits = header_bits_only;
}
- 该阈值可根据 QP 自适应调整(QP 越高,threshold 越大)。
- 在 speed 7 中,由于量化较粗,大量背景块满足此条件。
收益估计:对典型视频(如视频会议、屏幕内容),SKIP 率可达 40-60%,直接绕过 DCT 可节省大量运算。
路径五:RC 与 ME 的联合预分析(单遍编码模拟两遍)
目标:让码率控制的复杂度估计复用 ME 的 SAD 结果,避免 RC 独立做统计。
现状问题:VP9 的 single-pass CBR 在 speed 7 中,RC 模块独立维护帧复杂度统计,与 ME 的 SAD 数据无联动。
实现:
- 在 vp9_rc_compute_frame_size_bounds 或类似函数中,直接读取 ME 阶段已计算的帧级 SAD 总和作为复杂度指标。
- 替代 RC 中原有的 avg_frame_qindex 或 gfu_boost 的独立计算:
plain
// 原做法
complexity = calculate_independent_variance(frame);
// 优化后
complexity = me_stage->frame_sad_sum / (width * height);
- 由于 speed 7 的 ME 已经遍历了所有块,帧级 SAD 总和几乎是"免费"的副产品。
收益估计:消除 RC 阶段对像素的二次遍历,减少 5-10% 的总 CPU 时间。
五、针对svc的参考模型,使用超分替代层间缩放运动补偿。
以SVC L3T3为例:
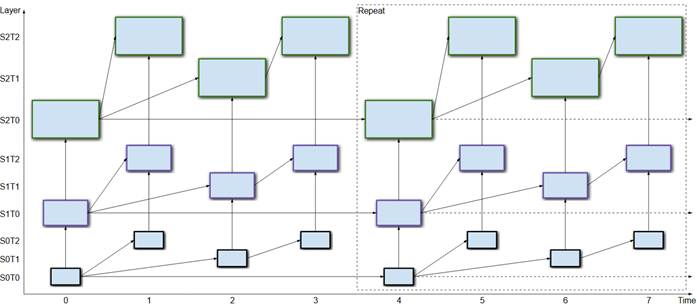
在 VP9 空域 SVC 编码中,参考帧缩放是实现跨层预测的关键环节。由于各空间层分辨率不同,低层重建帧必须被上采样(Upsample)到当前层的分辨率,才能作为有效的参考帧用于运动补偿。以下是详细的机制说明和核心实现分析。
(一)参考帧缩放的触发条件与架构
1.1 触发场景
VP9 SVC 中参考帧缩放发生在以下场景:
|
场景 |
说明 |
|
空域层间参考 |
低空间层(如 360p)编码完成后,其重建帧需上采样到高空间层(如 720p)分辨率,供高层作为参考帧 |
|
动态分辨率切换 |
编码过程中动态改变输出分辨率时,参考帧需要重新缩放 |
|
帧率/码率自适应 |
根据网络条件调整各层参数时,可能涉及参考帧缓冲区重建 |
1.2 核心架构
VP9 编码器维护一个参考帧缓冲区池(RefCntBuffer 池),每个空间层拥有独立的编码上下文(SVC_LAYER_CONTEXT)。关键设计原则:
- 各层独立缓冲:每个空间层有自己的 cpi->svc.layer_context[sl],包含独立的参考帧列表
- 缩放按需进行:低层帧不会自动全局上采样,而是在被高层引用时通过缩放路径处理
- 引用计数管理:通过 vp9_ref_frame 和 ref_cnt 机制确保帧数据生命周期安全
(二)参考帧缩放的完整数据流
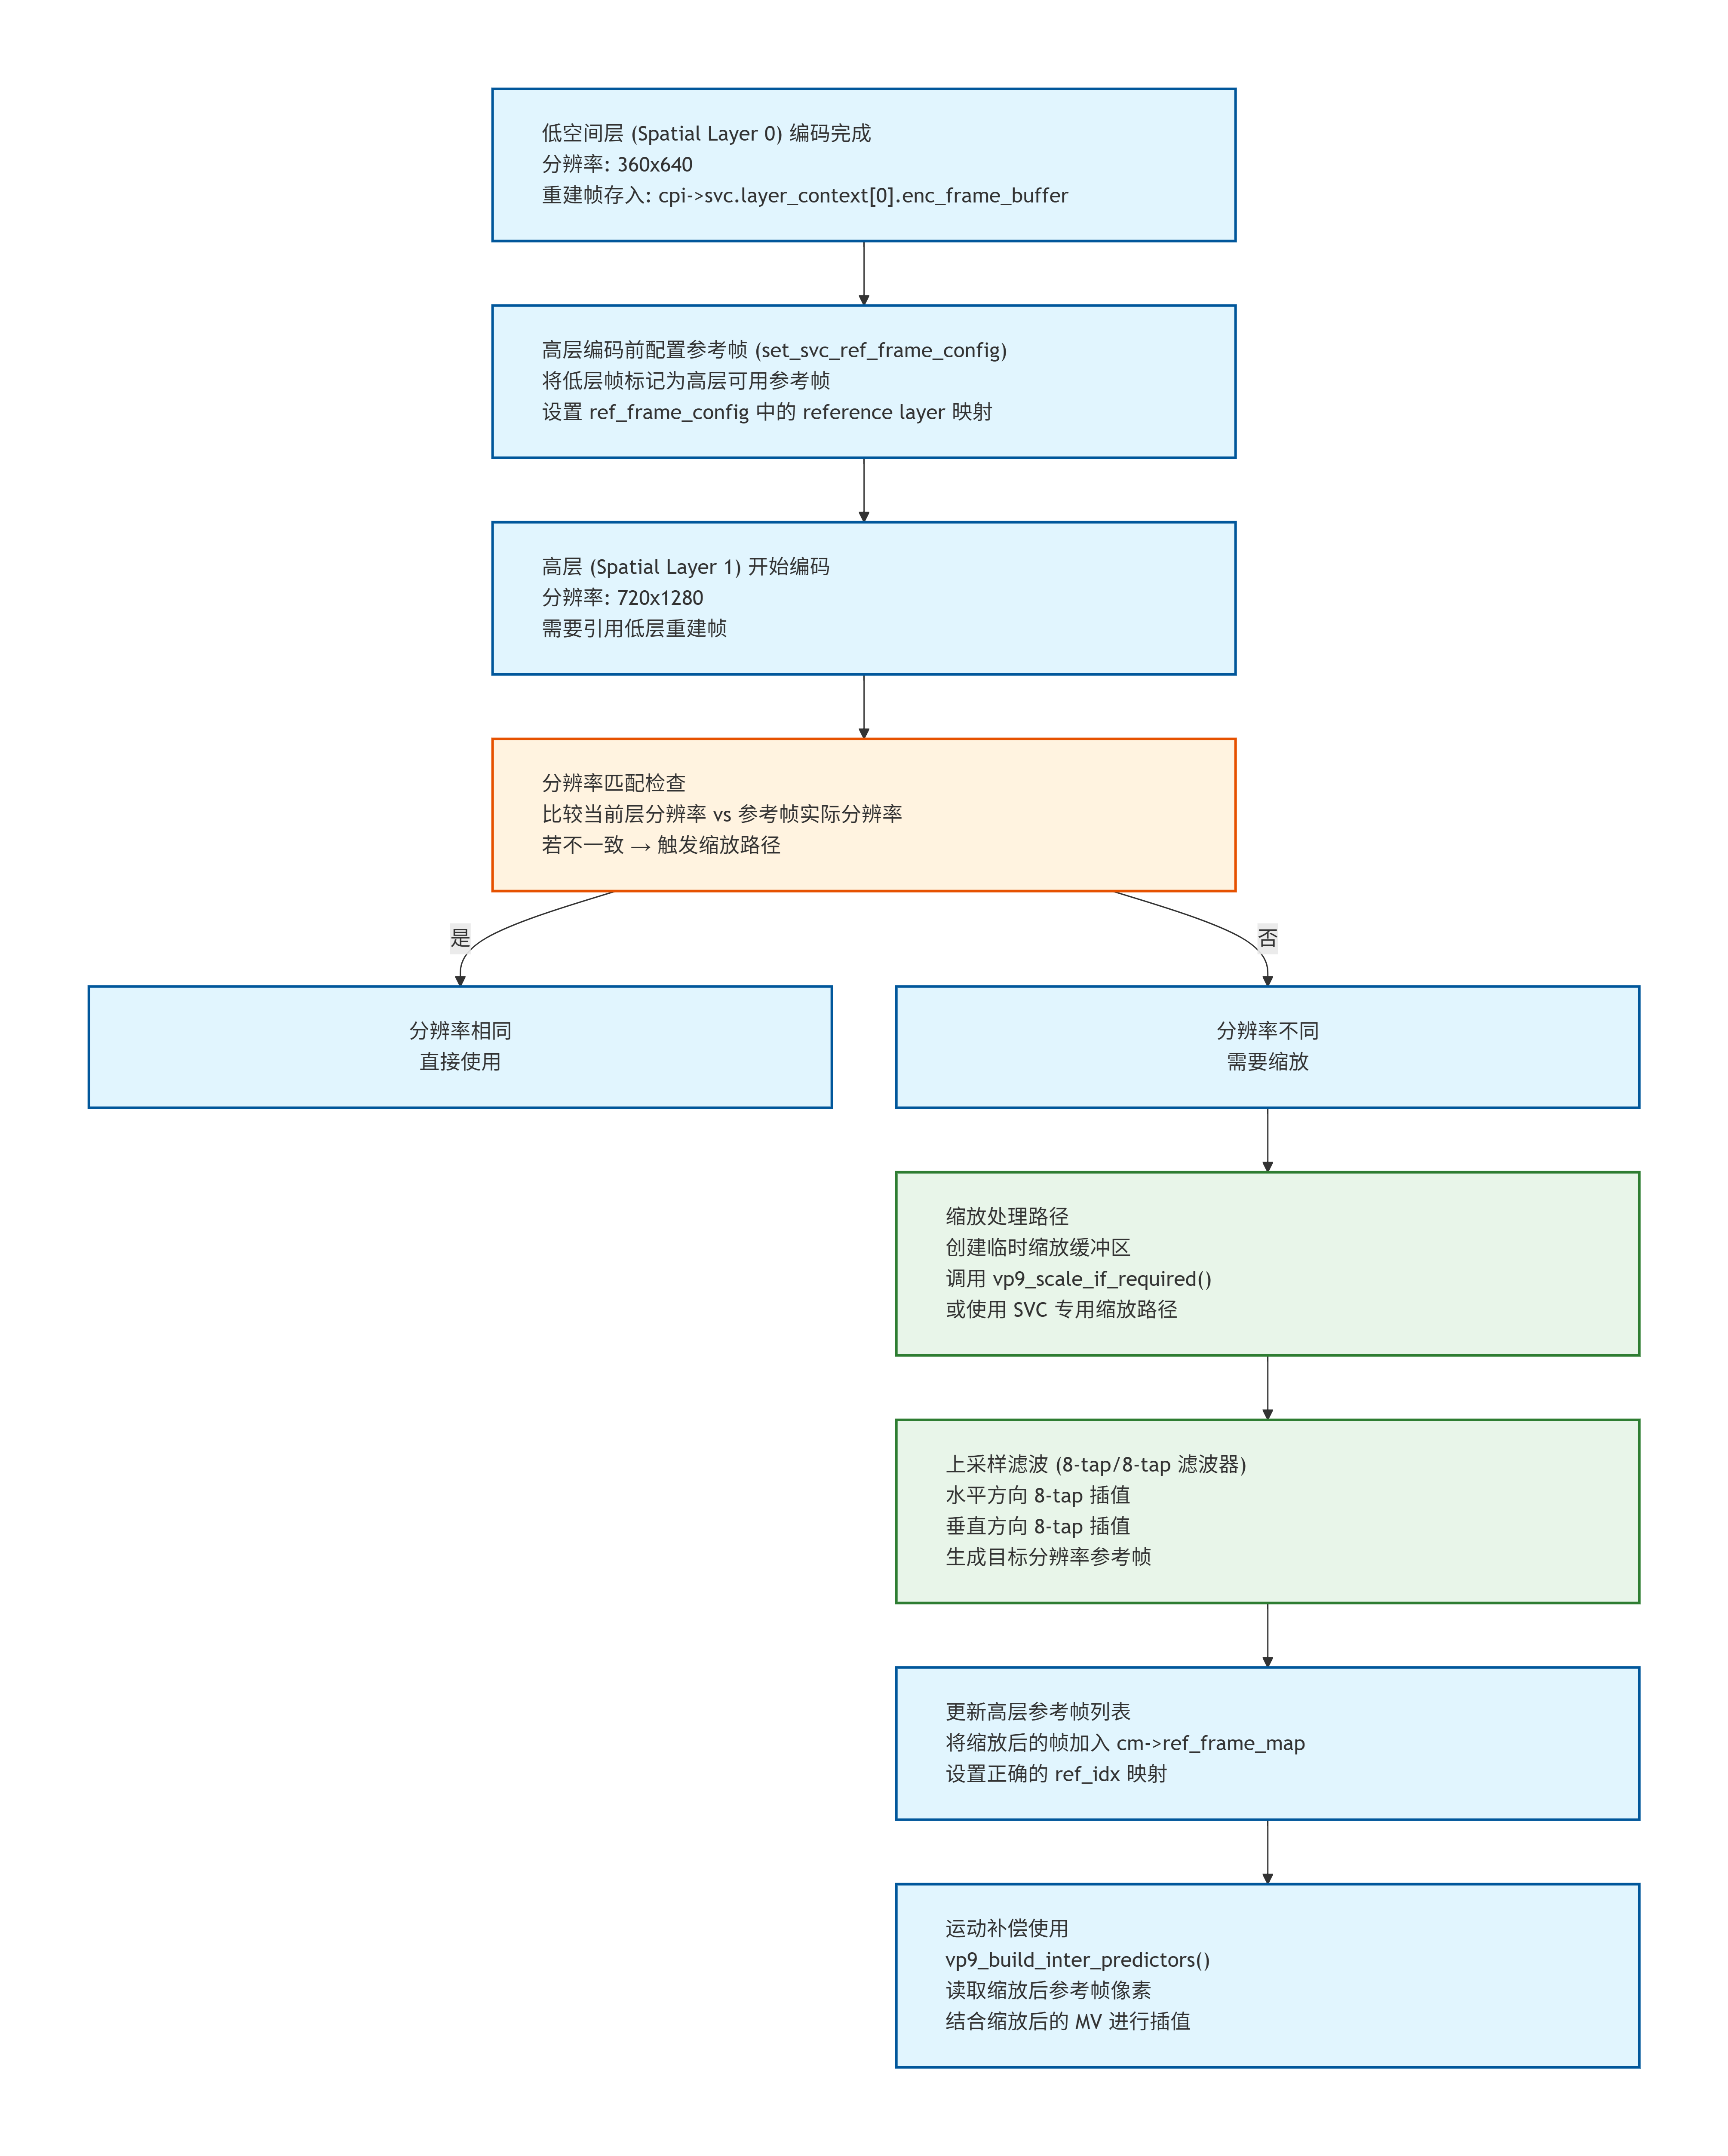
Libvpx中scale_2d() — 2D 8-tap 上采样滤波,其实现质量一般,性能较差。如果换成AI超分,(目前只针对1:2放大,将来可考虑任意尺寸放大),复杂度低和超分质量高pnsr约35.2DB。运动补偿的残差在通常的量化下大部分会直接走skip模式。在以前的上采样滤波模式下,大部分还是帧间运动补偿,而层间缩放补偿占比小。采用超分后,因为超分质量更高,帧间运动补偿占比会大量减少,而层间缩放补偿占比会更高。
综上,通过以上大量的优化,vp9-SVC在L3T3编码上压缩率和编码复杂度上有跨越式改进。使得720p30编码比传统的x264压缩率提高,复杂度也会更低。如果是在1080p或者4K高分辨率下,相比x264有更明显优势。最终编码是9个等级的子流,对于rtc的抗弱网实现质的飞跃。因为SVC的码流子码率基本固定,画质也有保障。在rtc的接收端同样还可以继续使用超分提升弱网画质。

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 22
 0
- 0


 已为社区贡献3条内容

所有评论(0)