NeurIPS 25 | VideoREPA: 视频理解能促进生成吗?
这篇文章回答了一个问题:视频理解能帮助视频生成吗?VideoREPA将Representation Alignment首次扩展到模型微调,用于提升视频生成模型所生成视频的物理合理性。
题目:VideoREPA: Learning Physics for Video Generation through Relational Alignment with Foundation Models
代码:https://github.com/aHapBean/VideoREPA
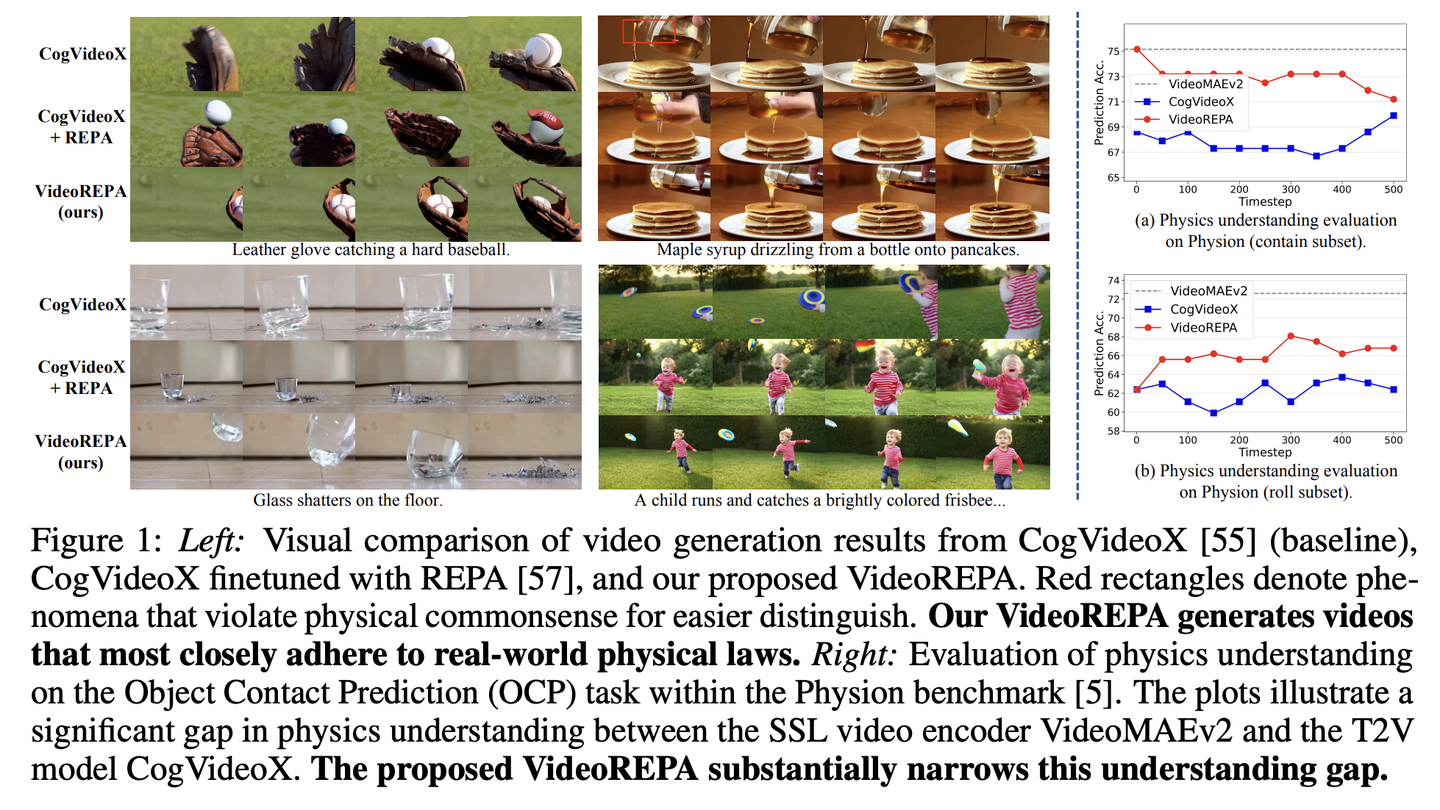
左图展示了VideoREPA相对于baseline的物理合理性提升,右图展示了视频生成模型与视频理解模型在物理理解上的性能gap
首先当前的大规模文本生成视频模型(如 CogVideoX、VideoCrafter2)虽然在视觉质量上取得突破,但仍普遍违背物理规律,比如物体悬浮、穿透等现象。这也降低了视频生成模型作为世界模型的可信度。 进一步我们发现视频基座模型,比如VideoMAEv2的物理理解能力要远好于参数量远远更大的T2V模型比如CogVideoX。
有一个较为共识的insight是,理解可以帮助生成,所以我们进一步探索了能否将视频基座模型的这种物理理解能力迁移到视频生成模型中,即探索视频(物理)理解能否帮助生成(物理规律合理的视频)。
应该用什么工具去进行这样的迁移呢?
前段时间读到REPA(Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You Think)这篇文章虽然领域不同,但是它建立了这生成模型和基座模型的联系,极大提速了图片生成diffusion模型的预训练。后续也有很多变体,但是鲜有应用到Video Generation领域的变体。
我们尝试将REPA用于迁移物理知识,但是发现REPA直接应用到视频生成领域有较大的困难:
(1) 只关注空间特征,忽视时序动态
(2) 原本为从零训练设计,不适用于微调(视频生成基座很难直接从头训练)
(3) 硬对齐易破坏原模型的语义结构
(4) 潜空间压缩与维度不匹配,难以对齐
💡 针对以上缺陷,我们提出了一个新的token relation distillation loss(TRD loss):
-
不再直接对齐特征值,而是对齐特征间的关系结构(相似度(Gram)矩阵);
-
引导生成模型学习理解模型中的空间与时间关系:
-
🧩 空间关系:帧内物体间的几何与语义联系;
-
⏳ 时间关系:跨帧的运动连续性与动力学一致性。
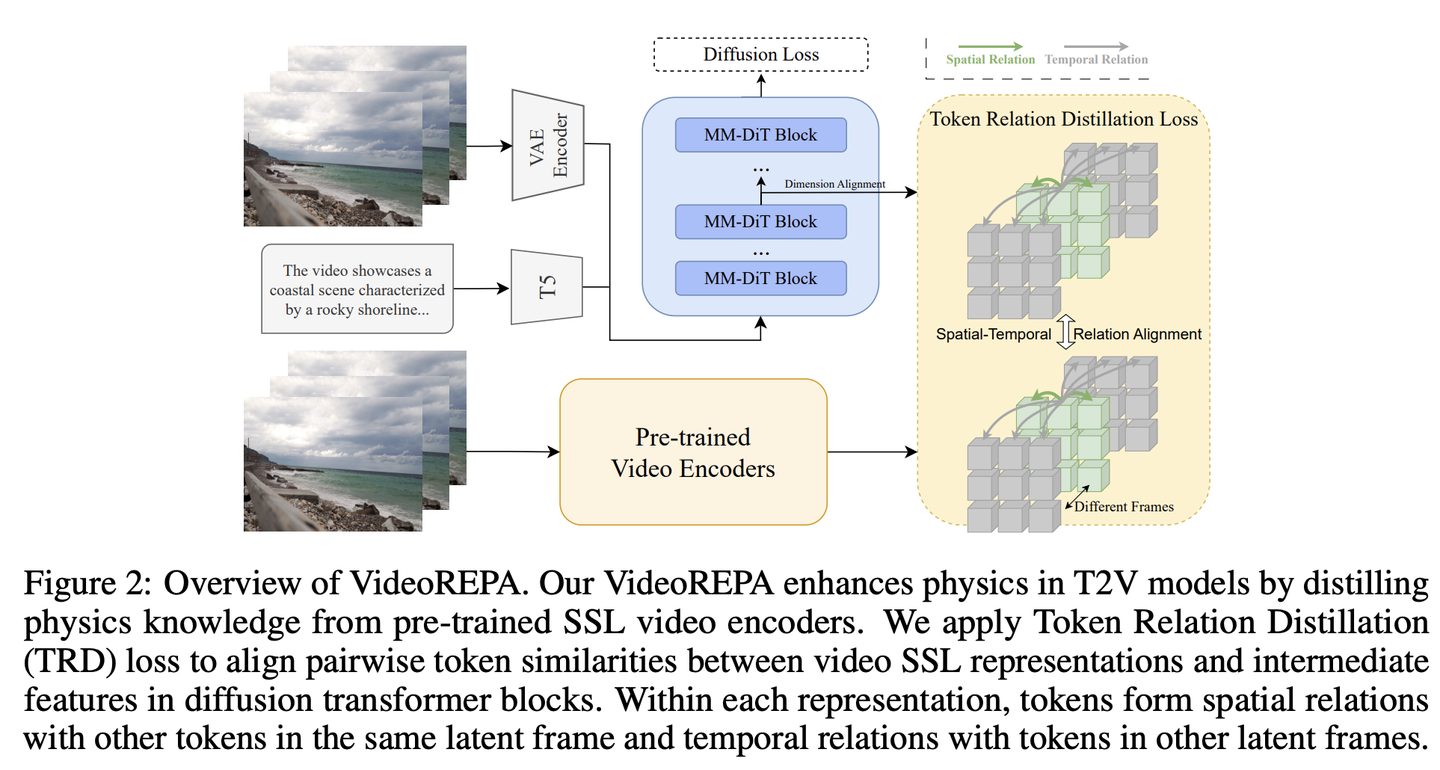
VideoREPA框架示意图
我们还将REPA对齐的DINOv2换成了VideoREPA中的VideoMAEv2。具体形式上是直接对齐Gram矩阵,和后来的DINOv3有一些相似之处hh
结果:
经过测评,发现视频生成模型的物理理解能力有提升。在物理合理性评测基准 VideoPhy上,VideoREPA 相比基线模型提升了 +24.1%。
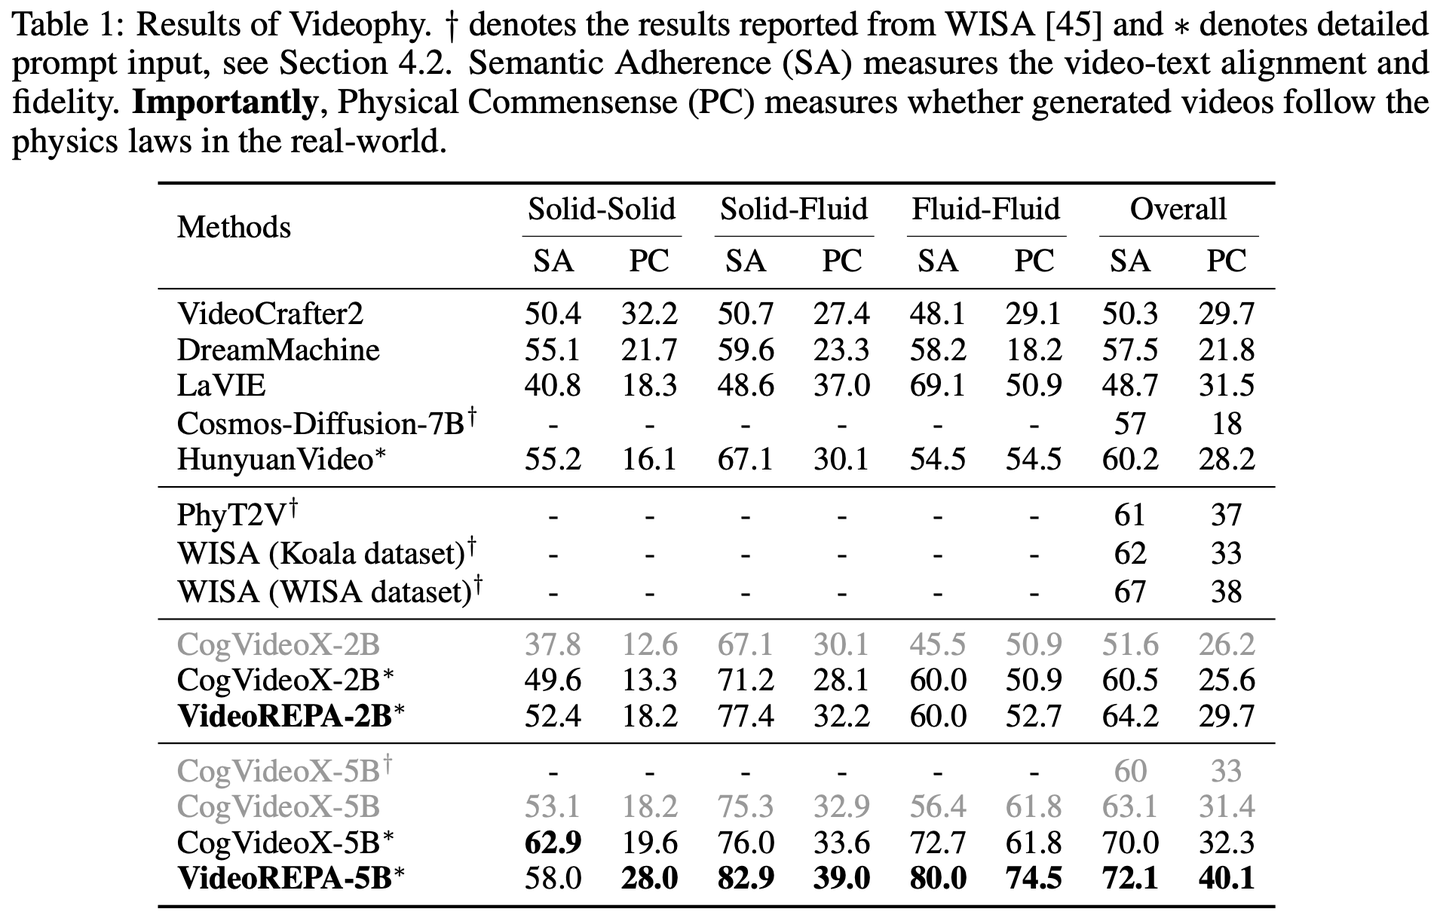
Videophy上的结果
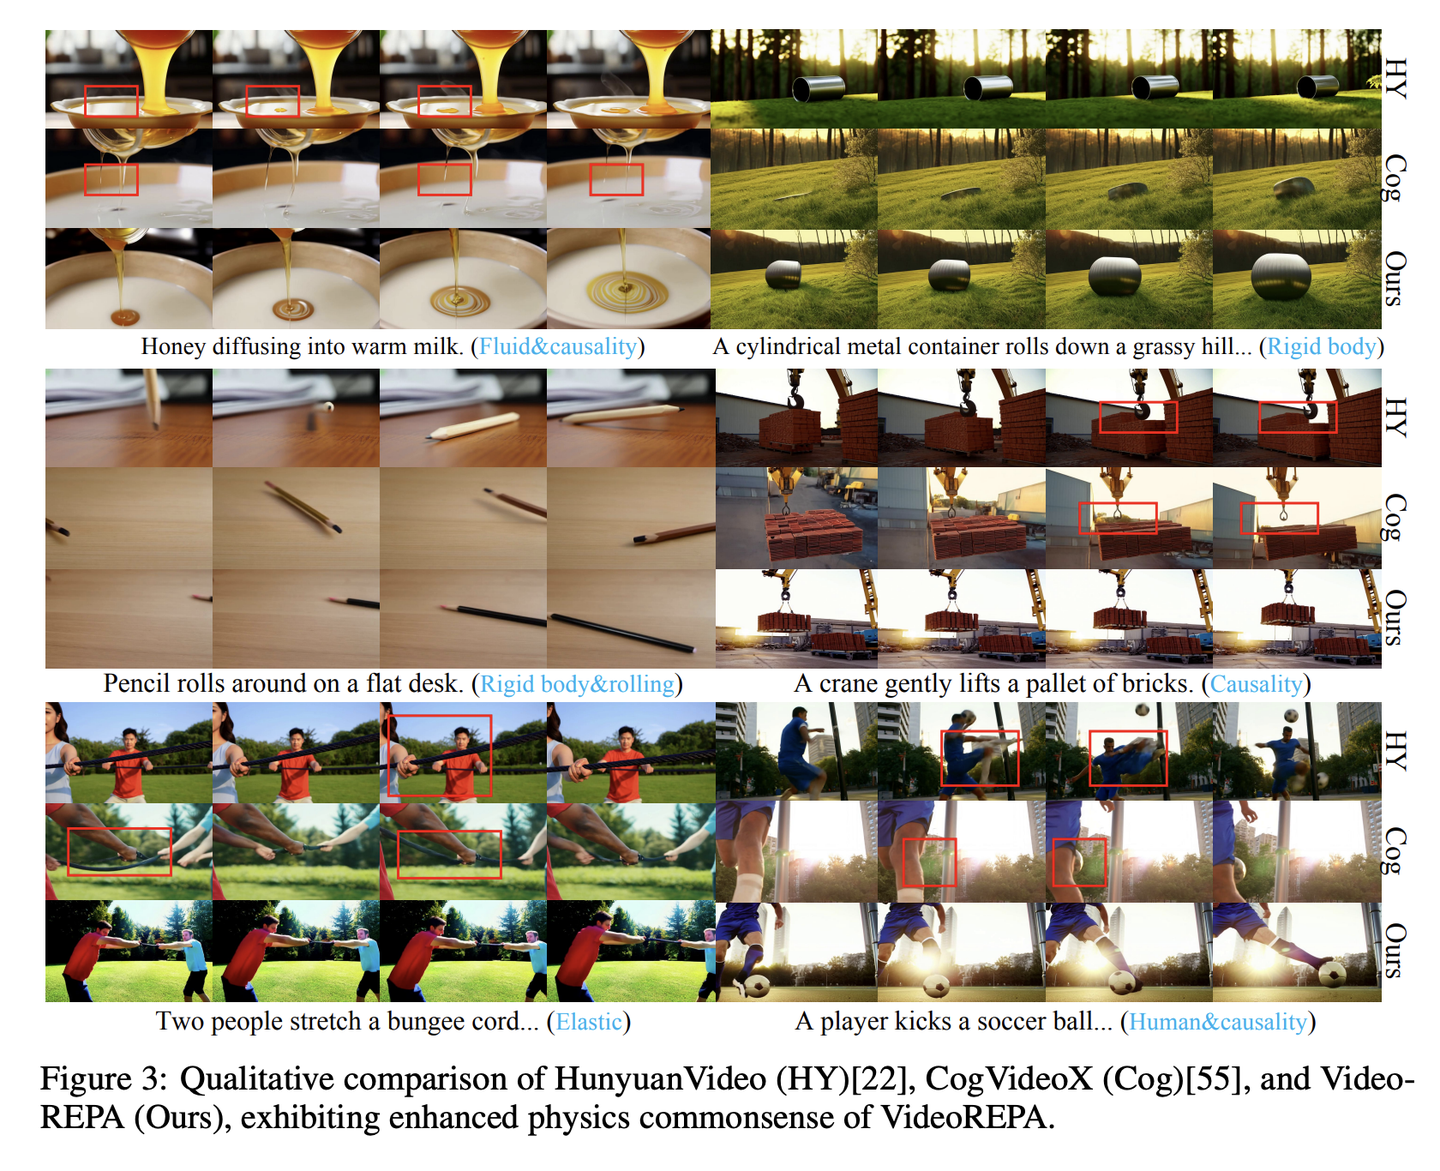
Quanlitative results可视化结果
实测上画面确实比REPA直接用于视频生成微调稳定很多,算是在视频生成领域REPA类方法的第一次尝试,当然方法并不完美,欢迎大家讨论,提出宝贵意见。
TRD loss也可以潜在用于微调其他类型的模型,目前代码已经开源,欢迎试用和star🌟。

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)