人大:优化长视频理解效率和信息冗余
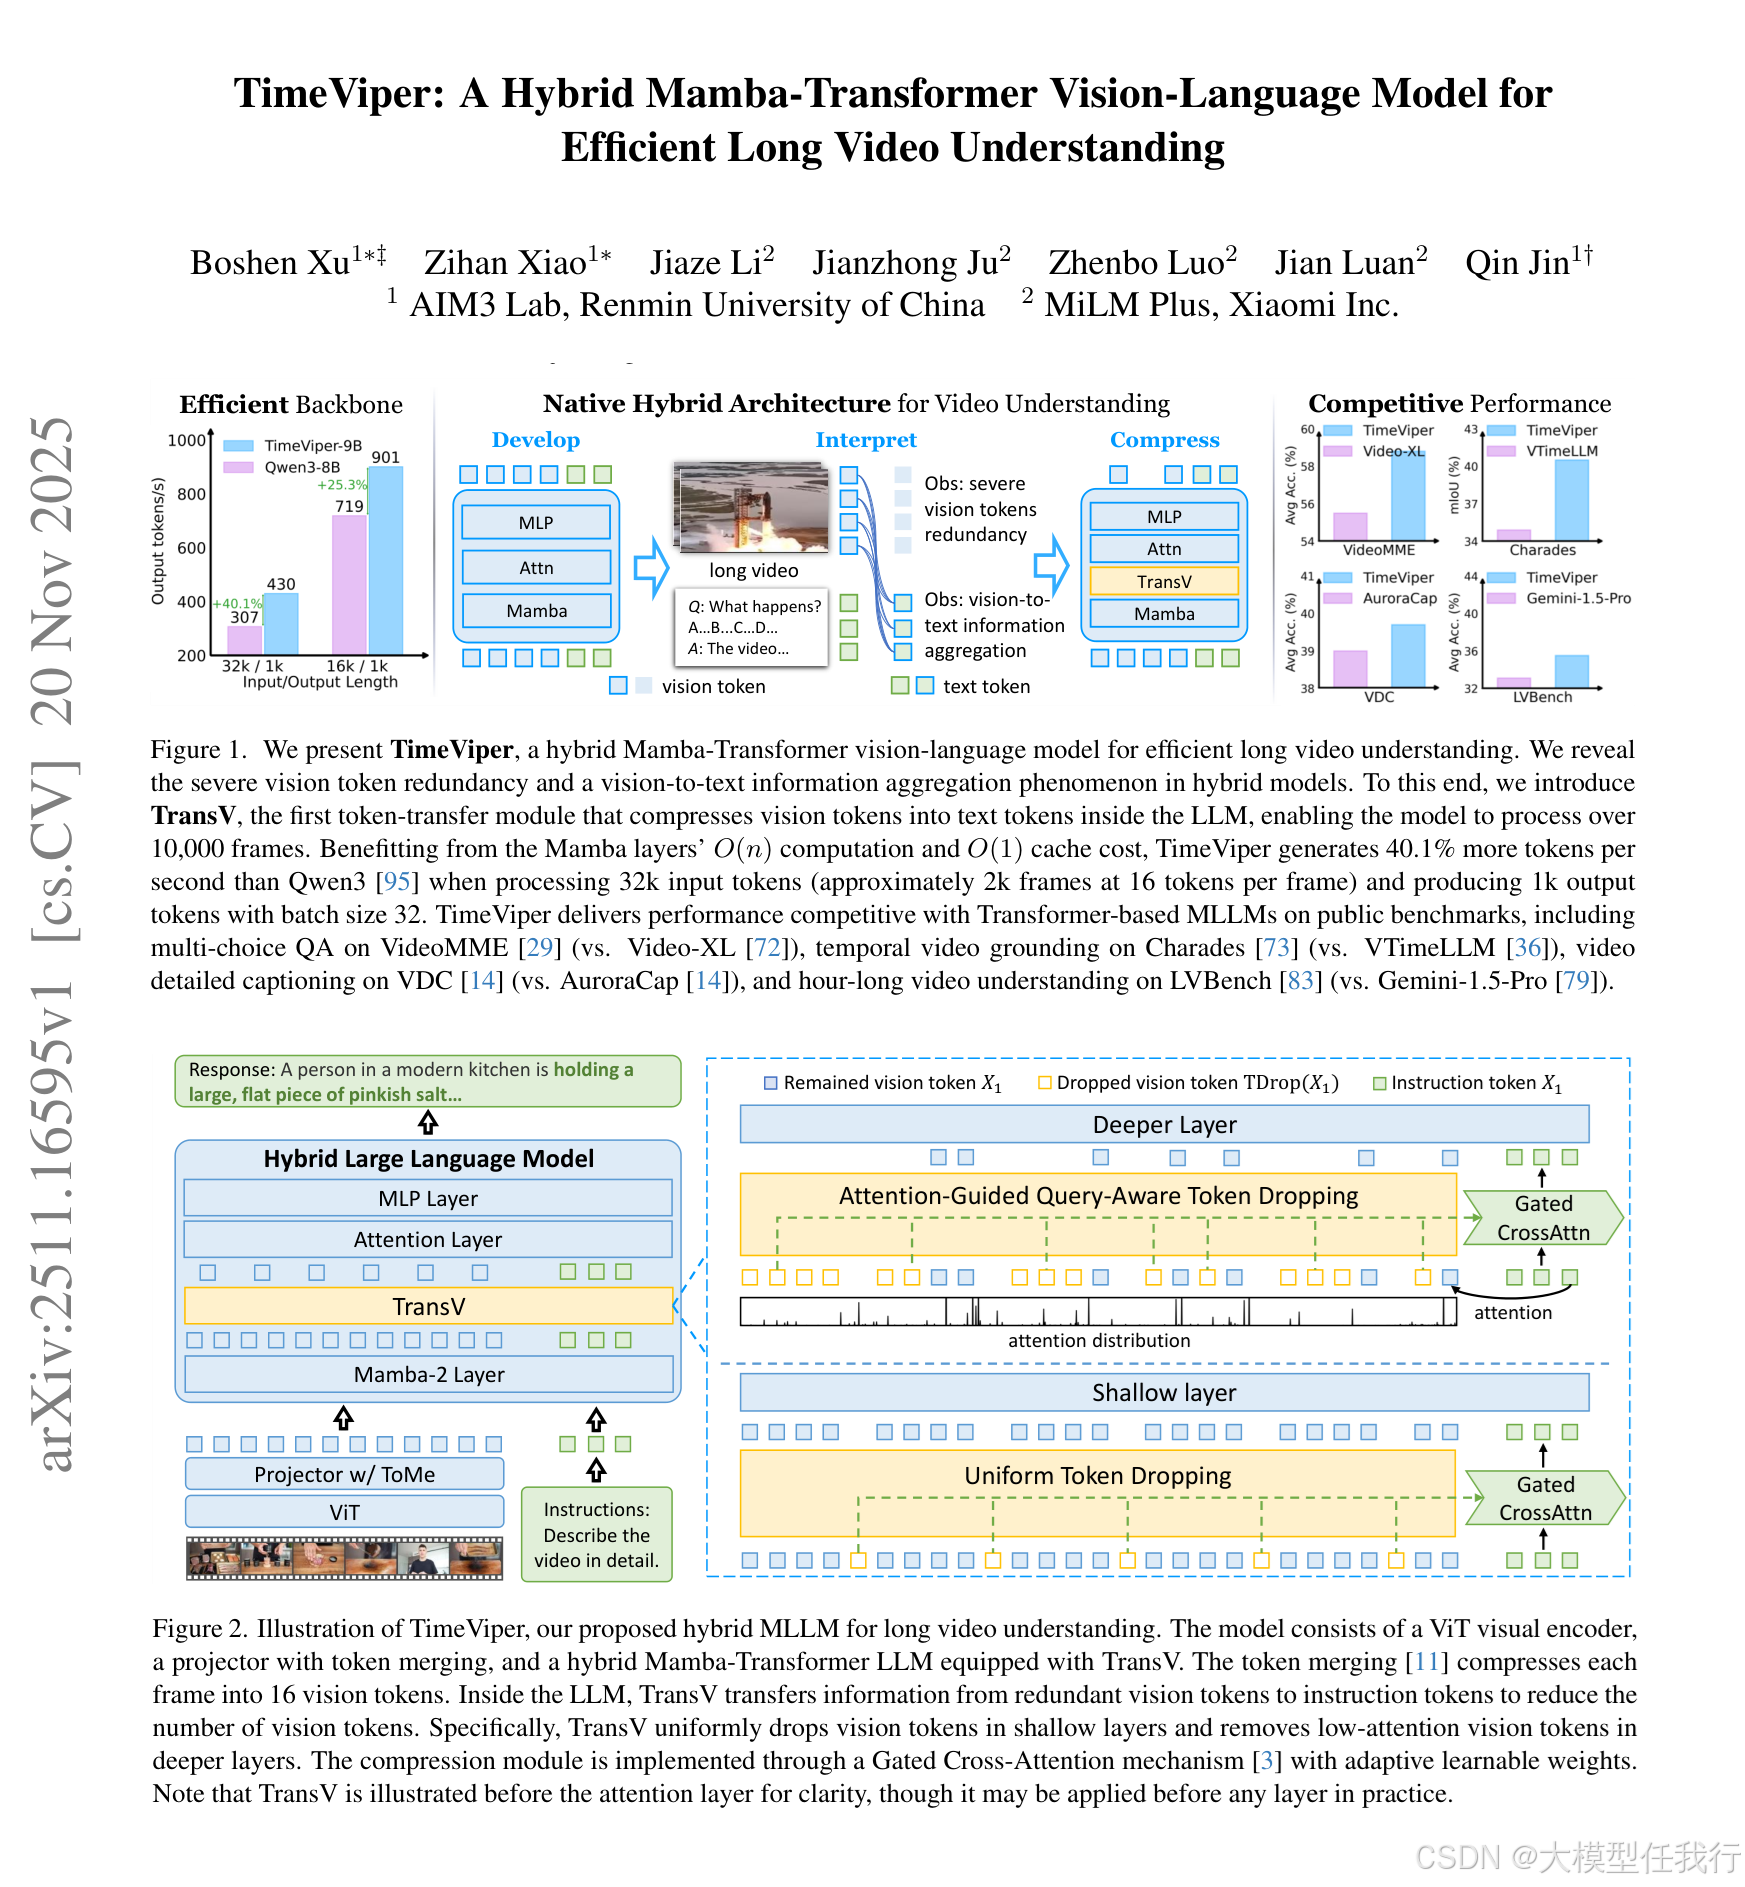
📖标题:TimeViper: A Hybrid Mamba-Transformer Vision-Language Model for Efficient Long Video Understanding
🌐来源:arXiv, 2511.16595
🌟摘要
我们介绍了 TimeViper,这是一种混合视觉语言模型,旨在解决长视频理解的挑战。处理长视频既需要高效的模型架构,也需要一种有效的机制来处理扩展时间上下文。为此,TimeViper 采用混合 Mamba-Transformer 主干,将状态空间模型的效率与注意力机制的表达能力相结合。通过这种混合设计,我们揭示了视觉到文本的信息聚合现象,其中信息随着LLM深度的增加而逐渐从视觉标记流向文本标记,导致严重的视觉令牌冗余。受这一观察的启发,我们提出了 TransV,这是一种令牌信息传输模块,它将视觉标记传输和压缩为指令标记,同时保持多模态理解能力。这种设计使 TimeViper 能够处理超过 10,000 帧的小时长视频。跨多个基准的广泛实验表明,TimeViper 在扩展帧数的同时与最先进的模型竞争。我们进一步分析了 Mamba 和 Transformer 层的注意力行为,为混合模型可解释性提供了新的见解。这项工作代表了开发、解释和压缩混合 Mamba-Transformer 架构的第一步
🛎️文章简介
🔸研究问题:如何在长视频理解中提高效率和减少视觉信息冗余?
🔸主要贡献:论文提出了TimeViper,一种混合的Mamba-Transformer模型,通过内部的LLM令牌压缩机制TransV来高效理解长视频。
📝重点思路
🔸论文提出了一种混合Mamba-Transformer结构,结合了状态空间模型的效率和自注意力机制的表达能力。
🔸设计了一个名为TransV的令牌信息传输模块,可以在LLM内部将冗余的视觉信息转换为指令令牌,从而减少视觉令牌的数量。
🔸进行了一系列实验,使用不同的令牌丢弃策略来评估视觉令牌在不同层次上的冗余程度。
🔎分析总结
🔸实验表明,随着网络层次的加深,视觉信息逐渐聚集到指令令牌中,深层视觉令牌几乎变得完全冗余。
🔸通过在浅层均匀丢弃视觉令牌和在深层基于注意力指导的丢弃方式,研究验证了视觉令牌的冗余性。
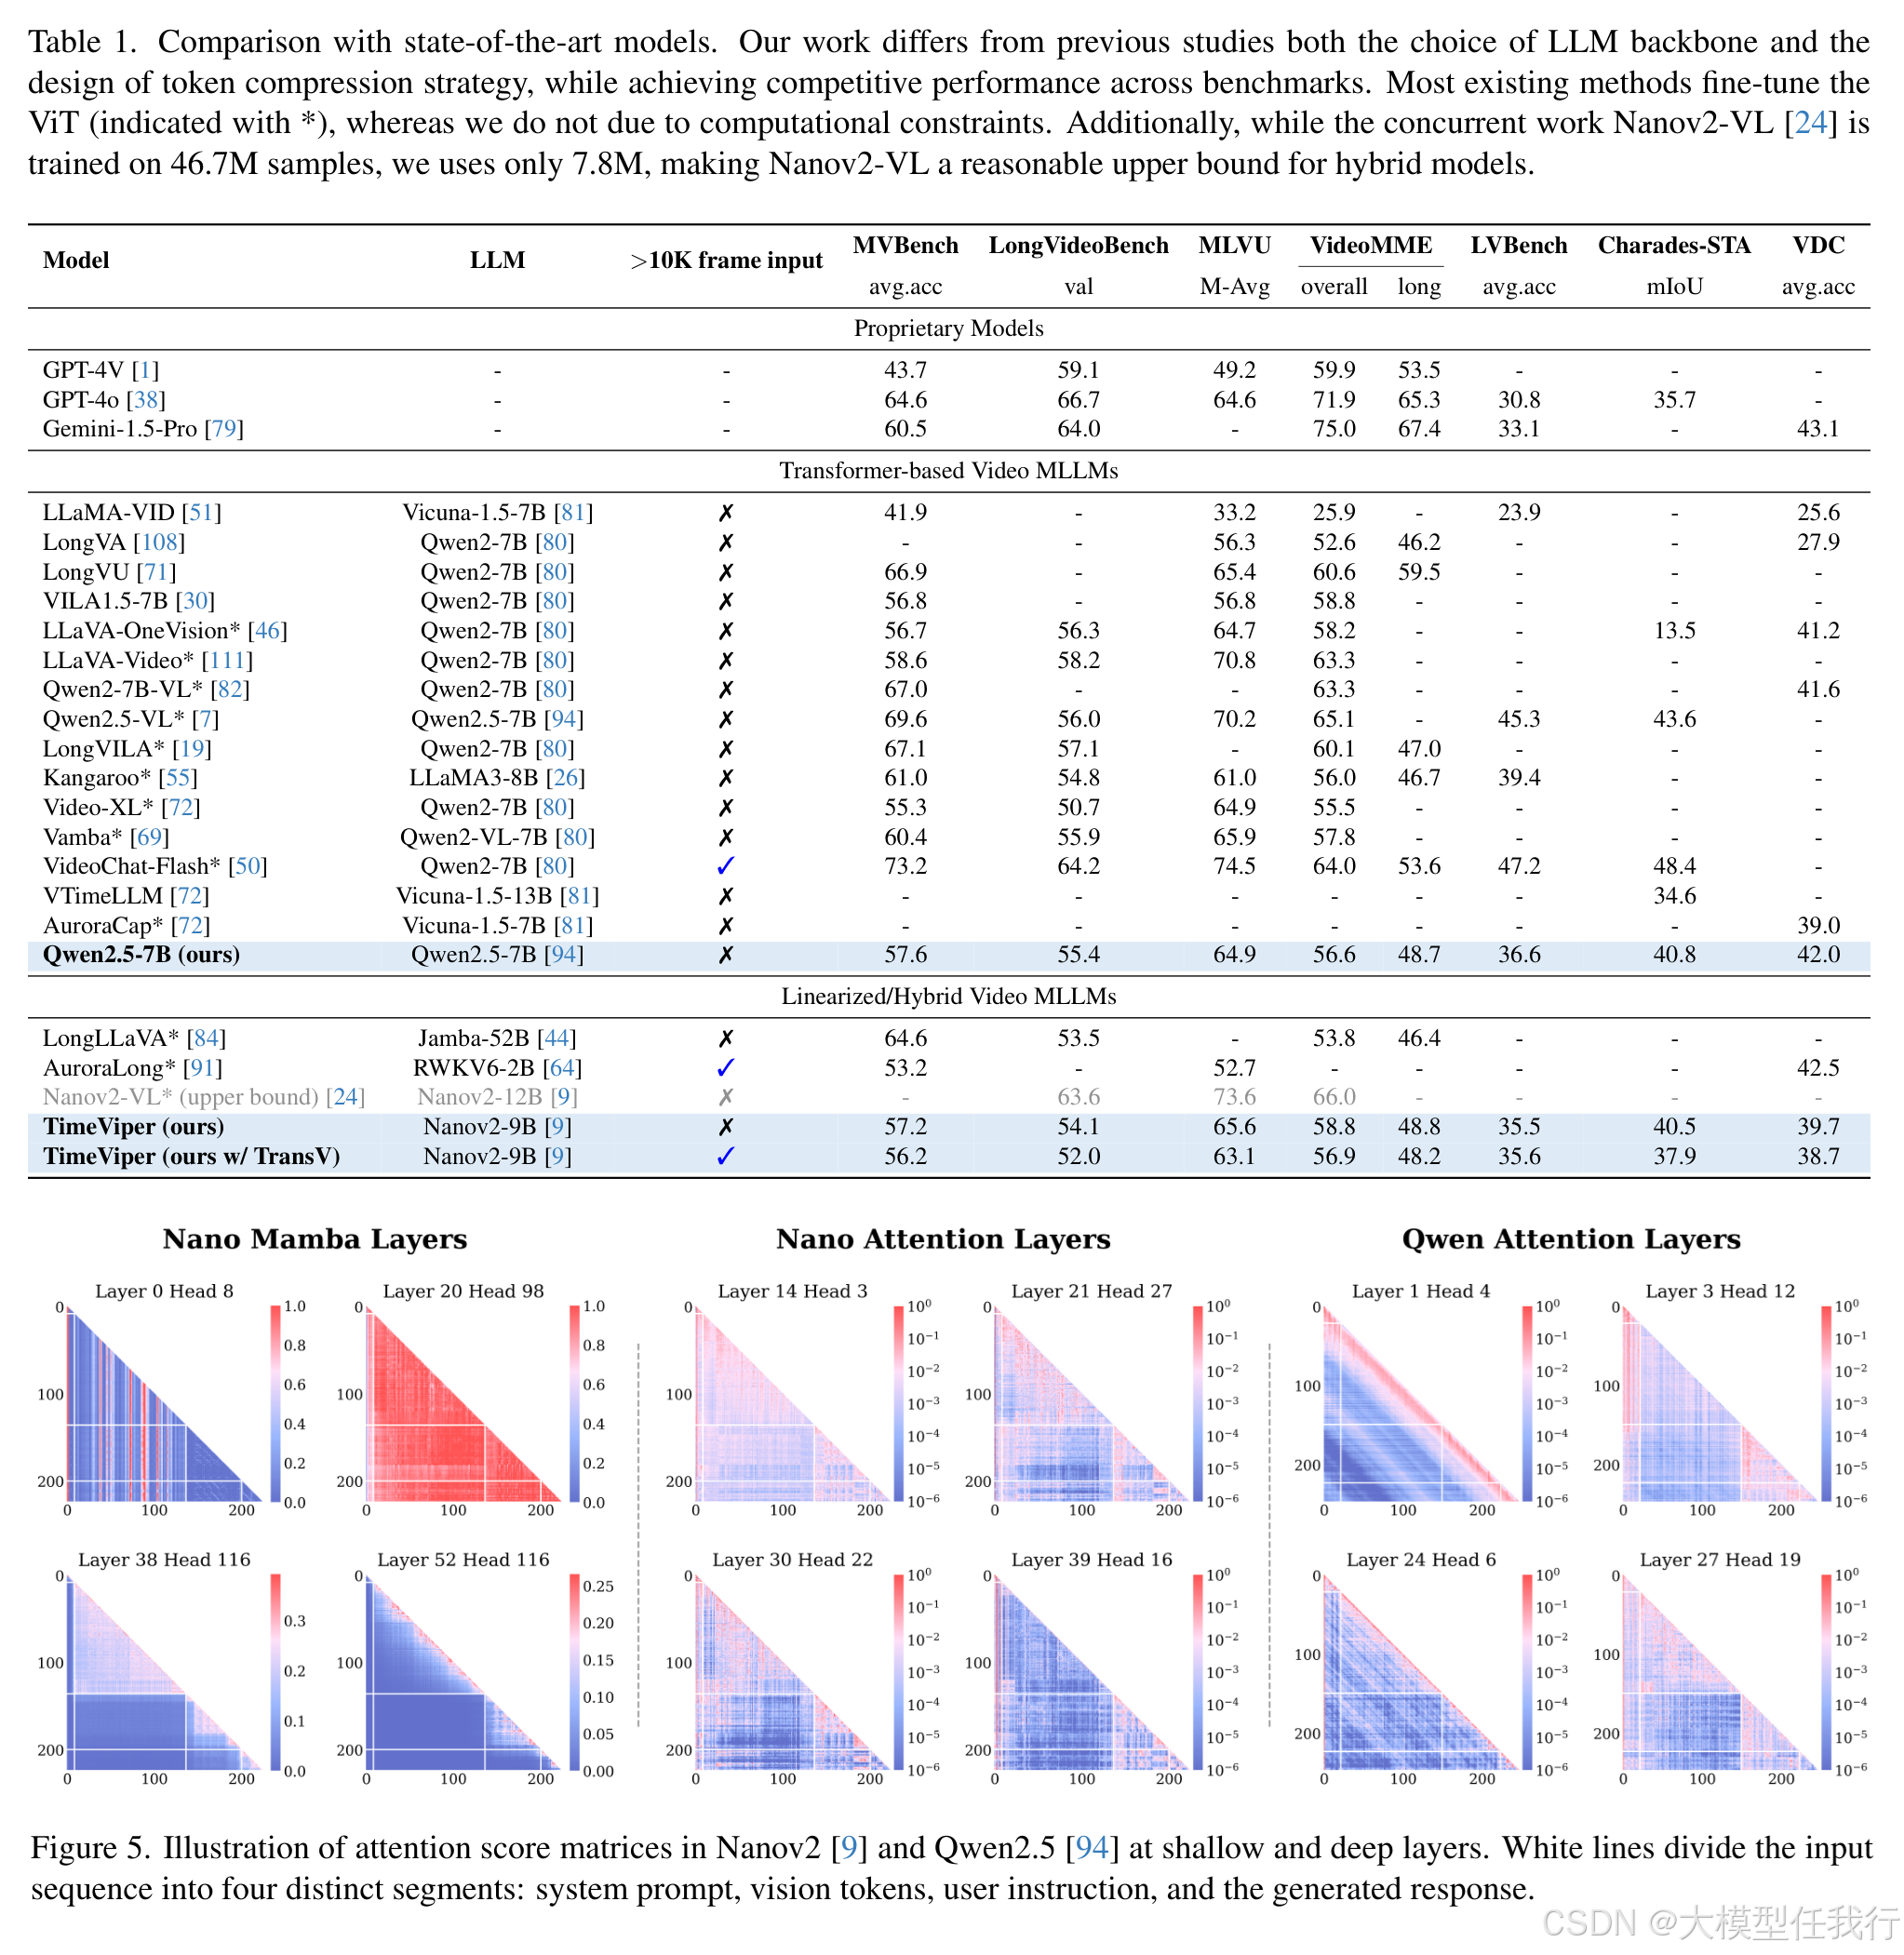
🔸TimeViper在长视频理解的多个基准测试中表现出色,包括多选择视频问答、时间视频定位和详细视频描述。
💡个人观点
论文通过内部信息传输机制实现混合模型结构,不仅提高了长视频理解的效率,还显著减少了视觉信息的冗余。
🧩附录

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)