炸裂!M3KG-RAG让音视频问答准确率飙升37%,小白也能秒会的多模态RAG黑科技!
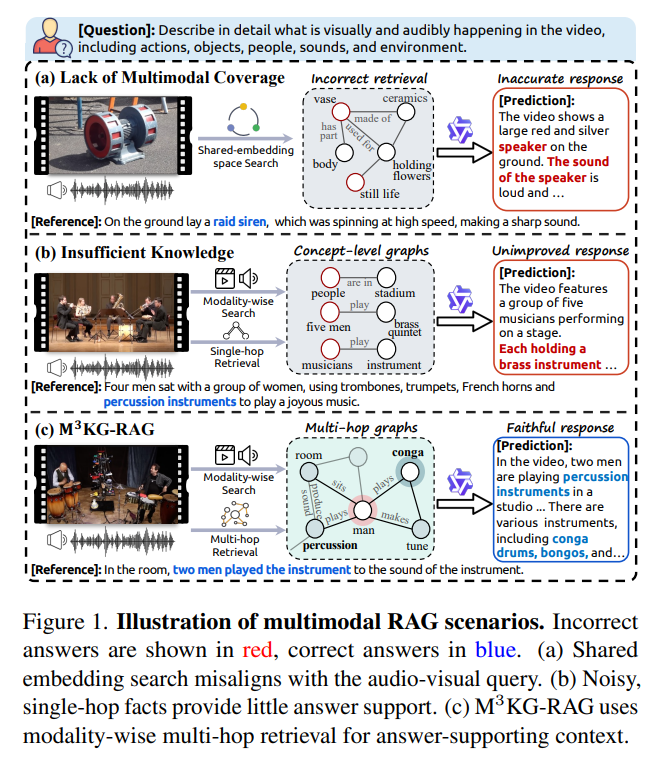
M3KG-RAG 是一个创新的端到端多模态 RAG 框架,通过构建多跳多模态知识图谱(M3KG)和提出 GRASP 检索策略,显著提升了多模态大模型在音视频问答任务中的推理能力和回答准确性。
一、方案介绍
工作原理
M3KG-RAG 框架包含两大核心组件:
- 多跳多模态知识图谱构建(M3KG):通过轻量级多智能体协作流程,从原始多模态语料中构建包含音频、视觉和文本信息的多跳知识图谱
- GRASP 检索策略:基于实体定位和选择性剪枝,确保检索到的知识与查询高度相关且对回答有用
核心技术创新
多智能体协作构建流程:
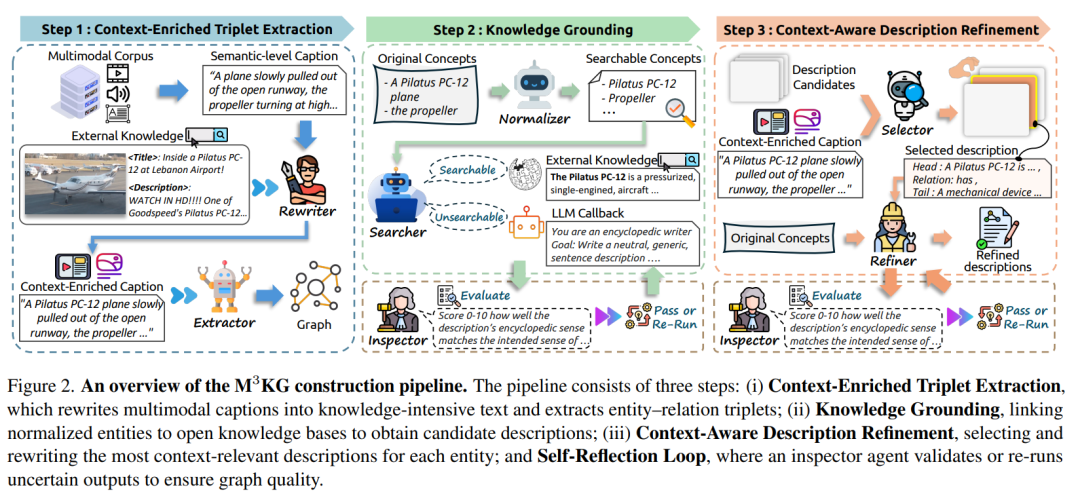
- 步骤1:上下文增强三元组提取 - 将通用字幕重写为知识密集型描述,提取实体-关系三元组
- 步骤2:知识接地 - 通过外部知识库获取实体的规范化描述
- 步骤3:上下文感知描述精炼 - 根据多模态上下文选择最相关的实体描述
- 自反思循环 - 通过质量检查确保知识图谱的准确性
GRASP 框架:
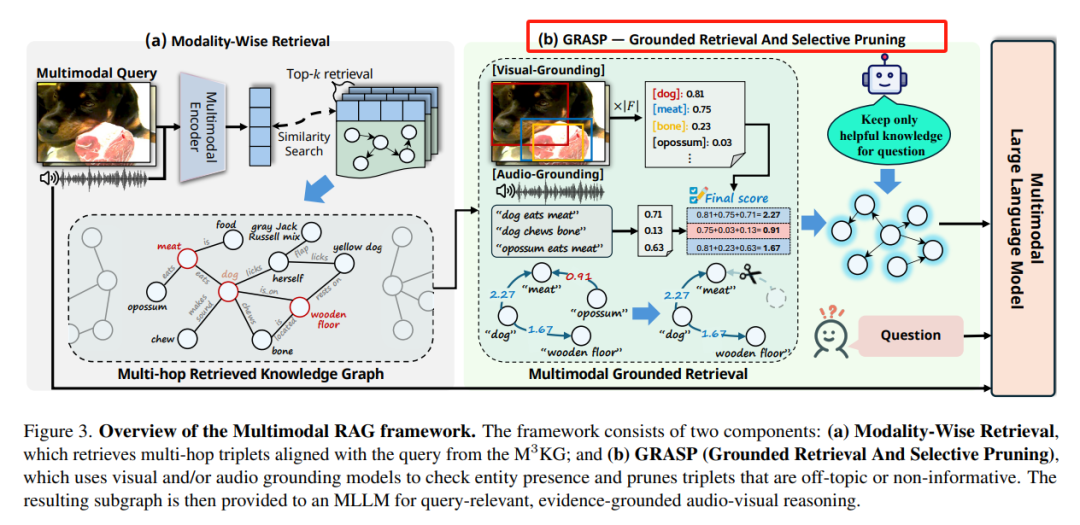
- 模态感知检索:避免跨模态嵌入空间的不匹配问题
- 视觉/音频定位:使用 GroundingDINO 和 TAG 模型验证实体在查询中的存在
- 选择性剪枝:通过轻量级 LLM 过滤掉对回答无用的知识
二、模型架构与方法论
多跳知识图谱构建
M3KG 的形式化表示为:G = {E, R, T, D̂, A, V, L}
其中每个三元组都链接到至少一个多模态项目,确保全图覆盖。
模态感知检索机制
针对不同模态查询采用不同策略:
- 音频查询:使用 CLAP 编码器在音频嵌入空间检索
- 视觉查询:使用 InternVL2 在视觉嵌入空间检索
- 音视频查询:拼接两种模态特征进行联合检索
实体定位与剪枝
视觉定位:s_v(e|q_v) = max_{f∈F} Φ_v(e;f)
音频定位:s_a(t|q_a) = Φ_a(σ(t);q_a)
通过设置阈值 η_v、η_a 和 η_av 进行精细化剪枝。
三、实验验证
数据集与基准测试
在三个多模态问答基准上评估:
- 音频问答:AudioCaps-QA 数据集
- 视频问答:VideoChatGPT (VCGPT) 基准
- 音视频问答:VALOR 基准
性能提升显著
VideoLLaMA2 模型:
- AudioCaps-QA:从 43.13 提升到 53.23(+23.2%)
- VCGPT:从 39.09 提升到 39.92(+2.1%)
- VALOR:从 25.66 提升到 29.25(+14.0%)
Qwen2.5-Omni 模型:
- AudioCaps-QA:从 49.00 提升到 60.77(+24.0%)
- VCGPT:从 42.21 提升到 44.35(+5.1%)
- VALOR:从 32.42 提升到 44.67(+37.8%)
GPT-4o 模型:
- 在所有基准上均实现 consistent 提升,证明方法对强基线模型依然有效
消融实验分析
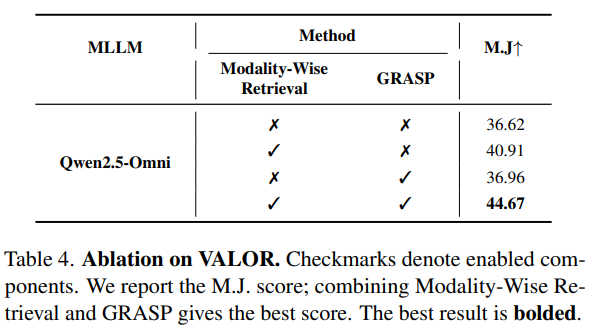
模态感知检索和GRASP 剪枝两者结合效果最好:
- 仅模态感知检索:40.91 分
- 仅 GRASP 剪枝:36.96 分
- 两者结合:44.67 分(最佳)
四、定性分析
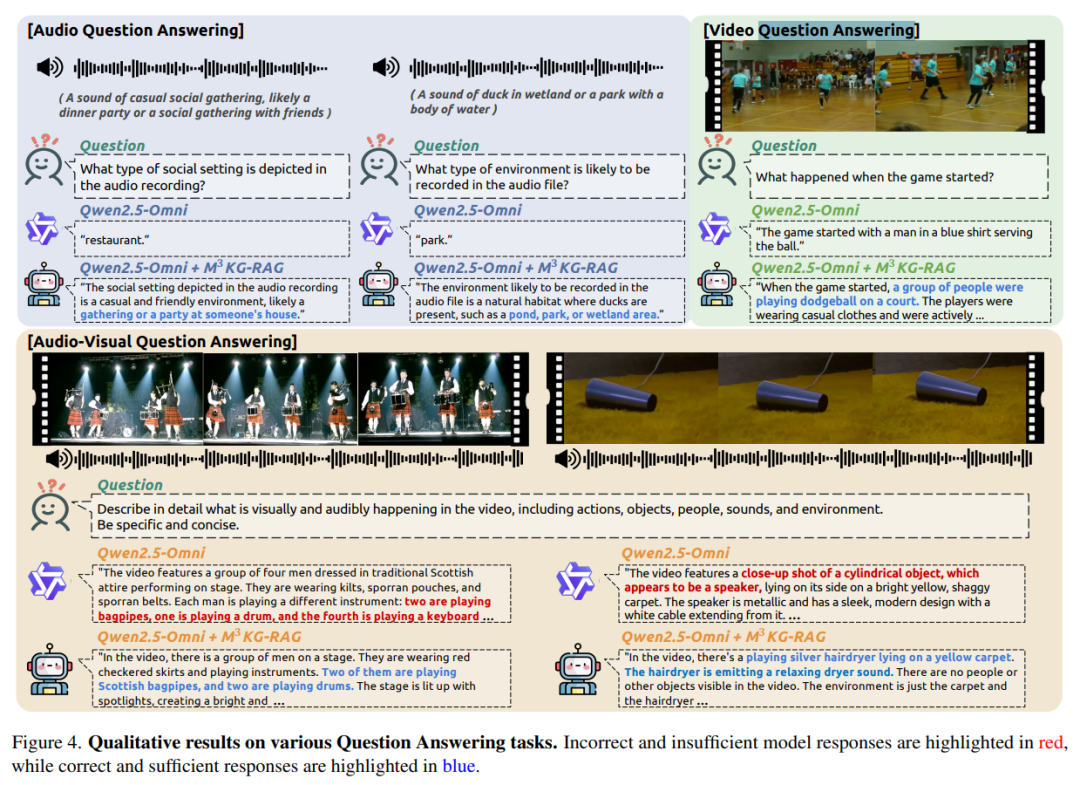
典型改进案例:
音频问答:从模糊的"餐厅"回答改进为准确的"家庭聚会"描述
视频问答:从泛泛的"球类运动"改进为精确的"躲避球比赛"描述
音视频问答:从错误的"原声吉他"改进为正确的"电吉他"识别
五、技术优势总结
- 解决模态鸿沟问题:通过模态感知检索避免跨模态嵌入不匹配
- 提升推理深度:多跳知识图谱捕获复杂的时空依赖关系
- 增强回答准确性:GRASP 策略确保知识的query相关性和answer有用性
- 良好的扩展性:轻量级架构适配不同规模的多模态大模型
M3KG-RAG 为多媒体内容理解、智能问答系统、教育辅助等领域提供了新的技术路径,特别是在需要深度音视频推理的场景中具有重要应用价值。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 48
 0
- 0


 已为社区贡献2条内容

所有评论(0)