AI+视频检索新姿势!基于RAG技术的完整实现代码,附6大核心模块详解,助你秒变大模型开发高手!
在短视频、在线课程、企业培训等多媒体内容爆炸式增长的时代,我们每天被海量的视频信息包围。然而,当我们需要在长达数小时的视频中定位特定信息时,传统的关键词搜索或手动拖动进度条的方式显得力不从心。基于RAG(检索增强生成)的视频检索技术,正成为解决这一痛点的创新方案。
一、RAG视频检索:重新定义多媒体内容访问方式
RAG技术结合了传统信息检索与生成式AI的优势,在视频检索场景中展现出独特价值。与传统的基于元数据(如标题、标签)的搜索不同,RAG视频检索能够深入理解视频内容的语义信息,实现精准的内容定位。
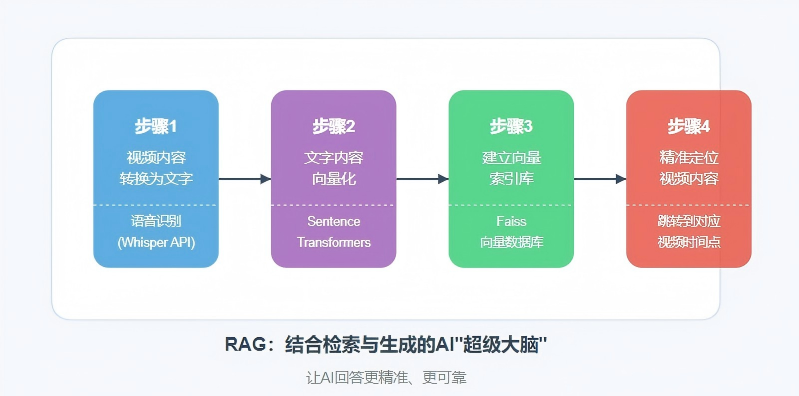
核心工作原理
RAG视频检索系统的工作流程可概括为以下四个阶段:
- 内容理解阶段:将非结构化的视频内容转化为结构化的语义表示
- 知识构建阶段:创建可检索的多模态知识库
- 查询处理阶段:将用户自然语言查询映射到语义空间
- 结果生成阶段:返回精确的视频片段定位与解释
这种"理解-构建-检索-生成"的闭环,使得系统不仅能找到相关视频片段,还能理解用户查询的深层意图,提供更准确的匹配结果。
二、技术架构深度解析:六步构建生产级视频检索系统
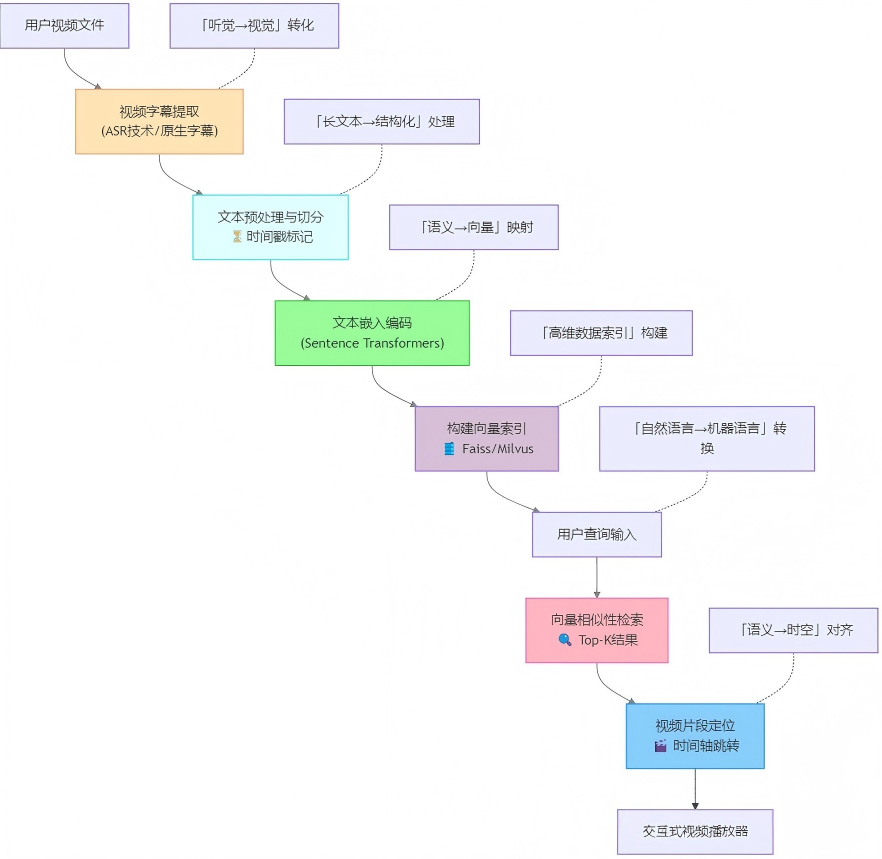
步骤1:多模态内容提取
视频内容的完整理解需要处理多种模态信息:
class VideoContentExtractor:
"""视频内容提取器"""
def extract_multimodal_content(self, video_path: str) -> Dict:
"""提取视频的多模态内容"""
content = {}
# 语音识别提取字幕
content['subtitles'] = self.extract_subtitles(video_path)
# 关键帧提取与视觉分析
content['key_frames'] = self.extract_key_frames(video_path)
# 音频特征分析
content['audio_features'] = self.extract_audio_features(video_path)
# 元数据提取
content['metadata'] = self.extract_metadata(video_path)
return content
def extract_subtitles(self, video_path: str) -> List[Dict]:
"""提取视频字幕,支持多种ASR引擎"""
# 可根据需求选择不同的ASR引擎
engines = {
'whisper': WhisperASR(),
'wav2vec': Wav2VecASR(),
'deepspeech': DeepSpeechASR()
}
# 获取最佳引擎配置
engine = self.select_optimal_engine(video_path)
# 执行语音识别
subtitles = engine.transcribe(video_path)
return [{
'text': segment.text,
'start_time': segment.start,
'end_time': segment.end,
'confidence': segment.confidence
} for segment in subtitles]
步骤2:语义分块与增强处理
原始字幕需要经过智能分块处理,以平衡检索精度与上下文完整性:
class SemanticChunker:
"""基于语义的视频内容分块器"""
def __init__(self, min_chunk_size: int = 50, max_chunk_size: int = 200):
self.min_chunk_size = min_chunk_size
self.max_chunk_size = max_chunk_size
self.sentence_detector = SentenceDetector()
def chunk_subtitles(self, subtitles: List[Dict]) -> List[Dict]:
"""智能字幕分块"""
chunks = []
current_chunk = []
current_duration = 0
max_duration = 30  # 每个分块最多30秒
for subtitle in subtitles:
# 计算当前分块的时长
segment_duration = subtitle['end_time'] - subtitle['start_time']
# 检查是否需要开始新分块
if (len(current_chunk) > 0 and
(len(' '.join([c['text'] for c in current_chunk])) > self.max_chunk_size or
current_duration + segment_duration > max_duration or
self.is_topic_boundary(subtitle, current_chunk[-1]))):
# 保存当前分块
chunks.append(self.create_chunk(current_chunk))
current_chunk = []
current_duration = 0
# 添加到当前分块
current_chunk.append(subtitle)
current_duration += segment_duration
# 处理最后一个分块
if current_chunk:
chunks.append(self.create_chunk(current_chunk))
return chunks
def is_topic_boundary(self, current: Dict, previous: Dict) -> bool:
"""检测主题边界"""
# 基于语义相似度的主题边界检测
similarity = self.calculate_semantic_similarity(
current['text'], previous['text']
)
return similarity < 0.3  # 相似度低于阈值认为主题变化
步骤3:多模态嵌入编码
为支持跨模态检索,需要对文本、视觉、音频等多种信息进行统一编码:
class MultimodalEmbeddingEncoder:
"""多模态嵌入编码器"""
def __init__(self):
# 文本嵌入模型
self.text_encoder = SentenceTransformer('all-MiniLM-L6-v2')
# 视觉嵌入模型
self.image_encoder = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
# 音频嵌入模型
self.audio_encoder = Wav2Vec2Model.from_pretrained("facebook/wav2vec2-base-960h")
def encode_chunk(self, chunk: Dict) -> Dict[str, np.ndarray]:
"""编码多模态分块"""
embeddings = {}
# 文本嵌入
text_embedding = self.text_encoder.encode(chunk['combined_text'])
embeddings['text'] = text_embedding
# 视觉嵌入(从关键帧提取)
if 'key_frames' in chunk:
visual_embeddings = []
for frame in chunk['key_frames']:
visual_embedding = self.image_encoder.get_image_features(frame)
visual_embeddings.append(visual_embedding)
embeddings['visual'] = np.mean(visual_embeddings, axis=0)
# 音频嵌入
if 'audio_segment' in chunk:
audio_embedding = self.audio_encoder(chunk['audio_segment'])
embeddings['audio'] = audio_embedding.last_hidden_state.mean(dim=1).squeeze()
# 多模态融合嵌入
combined_embedding = self.fuse_multimodal_embeddings(embeddings)
embeddings['combined'] = combined_embedding
return embeddings
def fuse_multimodal_embeddings(self, embeddings: Dict[str, np.ndarray]) -> np.ndarray:
"""多模态嵌入融合"""
# 加权融合策略
weights = {
'text': 0.5,
'visual': 0.3,
'audio': 0.2
}
combined = np.zeros_like(embeddings['text'])
for modality, weight in weights.items():
if modality in embeddings:
combined += weight * embeddings[modality]
return combined
步骤4:向量索引构建与优化
高效的向量检索是系统性能的关键:
class VectorIndexManager:
"""向量索引管理器"""
def __init__(self, dimension: int, index_type: str = 'HNSW'):
self.dimension = dimension
self.index_type = index_type
self.index = self.create_index()
self.id_to_metadata = {}  # 元数据映射
def create_index(self):
"""创建向量索引"""
if self.index_type == 'HNSW':
# HNSW图索引,适合高召回率场景
index = faiss.IndexHNSWFlat(self.dimension, 32)
index.hnsw.efConstruction = 200
index.hnsw.efSearch = 128
elif self.index_type == 'IVF':
# IVF索引,适合大规模数据
quantizer = faiss.IndexFlatL2(self.dimension)
index = faiss.IndexIVFFlat(quantizer, self.dimension, 100)
index.train(self.training_vectors)  # 需要训练数据
else:
# 默认使用Flat索引
index = faiss.IndexFlatIP(self.dimension)
return index
def add_to_index(self, embeddings: np.ndarray, metadata: List[Dict]):
"""添加向量到索引"""
# 归一化处理
faiss.normalize_L2(embeddings)
# 添加到索引
start_id = self.index.ntotal
self.index.add(embeddings)
# 保存元数据映射
for i, meta in enumerate(metadata):
self.id_to_metadata[start_id + i] = meta
def search(self, query_embedding: np.ndarray, top_k: int = 5) -> List[Dict]:
"""向量相似度搜索"""
# 查询向量归一化
faiss.normalize_L2(query_embedding.reshape(1, -1))
# 执行搜索
distances, indices = self.index.search(query_embedding.reshape(1, -1), top_k)
# 组装结果
results = []
for distance, idx in zip(distances[0], indices[0]):
if idx != -1:  # 有效结果
metadata = self.id_to_metadata.get(idx, {})
results.append({
'score': float(distance),
'metadata': metadata,
'chunk_id': idx
})
return results
步骤5:智能查询理解与重排
理解用户查询意图并优化检索结果:
class QueryProcessor:
"""智能查询处理器"""
def __init__(self):
self.query_expander = QueryExpansionModel()
self.reranker = CrossEncoderReranker()
def process_query(self, query: str, context: Dict = None) -> Dict:
"""处理用户查询"""
# 查询扩展
expanded_query = self.expand_query(query, context)
# 多粒度查询嵌入
query_embeddings = self.encode_query_multi_granularity(expanded_query)
return {
'original_query': query,
'expanded_query': expanded_query,
'embeddings': query_embeddings
}
def expand_query(self, query: str, context: Dict) -> str:
"""查询扩展,丰富查询语义"""
# 同义词扩展
synonyms = self.get_synonyms(query)
# 上下文感知扩展
if context and 'previous_queries' in context:
# 利用对话历史进行扩展
context_terms = self.extract_context_terms(context['previous_queries'])
synonyms.extend(context_terms)
# 去除重复,组合扩展查询
expanded_terms = list(set([query] + synonyms))
expanded_query = ' '.join(expanded_terms)
return expanded_query
def rerank_results(self, query: str, initial_results: List[Dict]) -> List[Dict]:
"""重排检索结果"""
# 准备重排数据
pairs = [(query, result['metadata']['text']) for result in initial_results]
# 计算相关性分数
scores = self.reranker.predict(pairs)
# 更新结果分数
for result, score in zip(initial_results, scores):
result['rerank_score'] = float(score)
# 按重排分数排序
reranked_results = sorted(
initial_results,
key=lambda x: x['rerank_score'],
reverse=True
)
return reranked_results
步骤6:结果生成与精确定位
生成最终结果并精确定位视频片段:
class ResultGenerator:
"""检索结果生成器"""
def generate_response(self, query: str, search_results: List[Dict]) -> Dict:
"""生成最终响应"""
if not search_results:
return self.generate_no_result_response(query)
# 提取top结果
top_results = search_results[:3]
# 生成自然语言摘要
summary = self.generate_summary(query, top_results)
# 生成精确定位信息
precise_locations = self.generate_precise_locations(top_results)
# 生成时间线概览
timeline = self.generate_timeline_overview(search_results)
return {
'query': query,
'summary': summary,
'precise_locations': precise_locations,
'timeline_overview': timeline,
'total_matches': len(search_results),
'top_matches': top_results
}
def generate_precise_locations(self, results: List[Dict]) -> List[Dict]:
"""生成精确定位信息"""
locations = []
for result in results:
metadata = result['metadata']
# 计算精确起止时间
start_time = metadata['start_time']
end_time = metadata['end_time']
# 添加前后缓冲
buffer = 2.0  # 2秒缓冲
precise_start = max(0, start_time - buffer)
precise_end = end_time + buffer
locations.append({
'start_time': precise_start,
'end_time': precise_end,
'duration': precise_end - precise_start,
'confidence': result['score'],
'text_preview': metadata['text'][:100] + '...' if len(metadata['text']) > 100 else metadata['text']
})
return locations
三、完整实现示例:生产级视频检索系统
# -*- coding: utf-8 -*-
"""
基于RAG的视频检索系统完整示例
"""
import numpy as np
import faiss
from typing import List, Dict, Tuple
from dataclasses import dataclass
from sentence_transformers import SentenceTransformer
from datetime import timedelta
@dataclass
class VideoSegment:
"""视频片段数据类"""
text: str
start_time: float  # 开始时间(秒)
end_time: float    # 结束时间(秒)
confidence: float  # 识别置信度
metadata: Dict     # 元数据
class RAGVideoRetrievalSystem:
"""RAG视频检索系统"""
def __init__(self,
embedding_model: str = 'all-MiniLM-L6-v2',
index_type: str = 'HNSW'):
"""
初始化视频检索系统
Args:
embedding_model: 嵌入模型名称
index_type: 索引类型 ('HNSW', 'IVF', 'Flat')
"""
# 初始化嵌入模型
self.embedding_model = SentenceTransformer(embedding_model)
# 初始化索引管理器
self.dimension = self.embedding_model.get_sentence_embedding_dimension()
self.index_manager = VectorIndexManager(self.dimension, index_type)
# 视频片段存储
self.video_segments: List[VideoSegment] = []
# 系统配置
self.config = {
'top_k': 5,
'score_threshold': 0.7,
'max_segment_duration': 30.0
}
def index_video(self, video_path: str) -> int:
"""
索引视频内容
Args:
video_path: 视频文件路径
Returns:
索引的视频片段数量
"""
# 提取视频内容
extractor = VideoContentExtractor()
content = extractor.extract_multimodal_content(video_path)
# 处理字幕
chunker = SemanticChunker()
chunks = chunker.chunk_subtitles(content['subtitles'])
# 编码和索引
embeddings_list = []
metadata_list = []
for chunk in chunks:
# 创建视频片段对象
segment = VideoSegment(
text=chunk['combined_text'],
start_time=chunk['start_time'],
end_time=chunk['end_time'],
confidence=chunk['avg_confidence'],
metadata={
'source_video': video_path,
'segment_id': len(self.video_segments),
'duration': chunk['end_time'] - chunk['start_time']
}
)
# 编码文本
embedding = self.embedding_model.encode(
segment.text,
convert_to_numpy=True
)
# 保存数据
embeddings_list.append(embedding)
metadata_list.append({
'segment': segment,
'chunk_data': chunk
})
self.video_segments.append(segment)
# 批量添加到索引
if embeddings_list:
embeddings_array = np.vstack(embeddings_list)
self.index_manager.add_to_index(embeddings_array, metadata_list)
return len(chunks)
def search(self,
query: str,
top_k: int = None,
filters: Dict = None) -> List[Dict]:
"""
搜索视频内容
Args:
query: 搜索查询
top_k: 返回结果数量
filters: 过滤条件
Returns:
搜索结果列表
"""
if top_k is None:
top_k = self.config['top_k']
# 处理查询
query_processor = QueryProcessor()
processed_query = query_processor.process_query(query)
# 编码查询
query_embedding = self.embedding_model.encode(
processed_query['expanded_query'],
convert_to_numpy=True
)
# 向量搜索
search_results = self.index_manager.search(query_embedding, top_k * 2)
# 应用过滤
if filters:
search_results = self.apply_filters(search_results, filters)
# 结果重排
reranked_results = query_processor.rerank_results(
processed_query['original_query'],
search_results[:top_k * 3]
)
# 生成最终结果
result_generator = ResultGenerator()
final_response = result_generator.generate_response(
processed_query['original_query'],
reranked_results[:top_k]
)
return final_response
def apply_filters(self, results: List[Dict], filters: Dict) -> List[Dict]:
"""应用过滤条件"""
filtered_results = []
for result in results:
metadata = result['metadata']
segment = metadata['segment']
# 时长过滤
if 'min_duration' in filters:
if segment.metadata['duration'] < filters['min_duration']:
continue
if 'max_duration' in filters:
if segment.metadata['duration'] > filters['max_duration']:
continue
# 时间范围过滤
if 'time_range' in filters:
min_time, max_time = filters['time_range']
if segment.start_time < min_time or segment.end_time > max_time:
continue
# 置信度过滤
if 'min_confidence' in filters:
if segment.confidence < filters['min_confidence']:
continue
filtered_results.append(result)
return filtered_results
def get_segment_preview(self,
segment_id: int,
preview_seconds: float = 10.0) -> Dict:
"""
获取视频片段预览信息
Args:
segment_id: 片段ID
preview_seconds: 预览时长
Returns:
预览信息
"""
if segment_id >= len(self.video_segments):
raise ValueError(f"无效的片段ID: {segment_id}")
segment = self.video_segments[segment_id]
# 计算预览起止时间
segment_duration = segment.end_time - segment.start_time
preview_start = segment.start_time
preview_end = min(segment.end_time, segment.start_time + preview_seconds)
return {
'segment_id': segment_id,
'start_time': preview_start,
'end_time': preview_end,
'duration': preview_end - preview_start,
'text_preview': segment.text[:200] + '...' if len(segment.text) > 200 else segment.text,
'confidence': segment.confidence,
'video_source': segment.metadata.get('source_video', 'unknown'),
'playback_url': self.generate_playback_url(
segment.metadata.get('source_video'),
preview_start,
preview_end
)
}
def generate_playback_url(self,
video_path: str,
start_time: float,
end_time: float) -> str:
"""生成播放URL"""
# 实际实现中,这里会生成指向视频片段的URL
# 例如使用视频服务器的API生成带时间参数的播放链接
return f"{video_path}?start={start_time}&end={end_time}"
# 使用示例
if __name__ == "__main__":
# 初始化系统
retrieval_system = RAGVideoRetrievalSystem()
# 索引视频
print("正在索引视频...")
segment_count = retrieval_system.index_video("sample_video.mp4")
print(f"成功索引 {segment_count} 个视频片段")
# 执行搜索
query = "RAG技术在视频检索中的应用原理"
print(f"\n执行搜索: {query}")
results = retrieval_system.search(query, top_k=3)
# 显示结果
print(f"找到 {results['total_matches']} 个相关片段")
print(f"摘要: {results['summary']}")
print("\n精确位置:")
for i, location in enumerate(results['precise_locations']):
print(f"{i+1}. [{location['start_time']:.1f}s - {location['end_time']:.1f}s] "
f"置信度: {location['confidence']:.3f}")
print(f"   预览: {location['text_preview']}")
print()
四、应用场景与行业实践
4.1 教育行业:智能学习助手
痛点:学生在复习课程视频时,难以快速定位知识点
解决方案:
# 教育视频检索配置
edu_retrieval = RAGVideoRetrievalSystem(
embedding_model='BAAI/bge-large-zh-v1.5',  # 中文教育领域优化
index_type='HNSW'
)
# 索引课程库
for course_video in course_library:
edu_retrieval.index_video(course_video)
# 学生查询示例
student_query = "神经网络的反向传播算法推导过程"
results = edu_retrieval.search(
query=student_query,
filters={'min_confidence': 0.75}
)
4.2 企业培训:知识传承平台
需求:新员工快速查找历史培训内容
特点:
- 支持多模态查询(文字、语音、图片)
- 跨部门知识共享
- 权限控制和访问审计
4.3 媒体制作:内容管理系统
应用:
- 素材检索:基于内容描述查找视频片段
- 版权管理:自动识别和定位受版权保护内容
- 自动标签生成:基于内容理解自动生成元数据
4.4 客户服务:视频知识库
场景:客户通过自然语言查询产品使用视频
优势:
- 减少客服培训成本
- 提升问题解决效率
- 7×24小时自助服务
五、性能优化与最佳实践
5.1 检索性能优化
class PerformanceOptimizer:
"""性能优化器"""
def optimize_retrieval(self, system: RAGVideoRetrievalSystem):
"""优化检索性能"""
# 索引压缩优化
if system.index_manager.index.ntotal > 10000:
system.index_manager.compress_index()
# 缓存热点查询
system.enable_query_cache(
ttl=3600,  # 缓存1小时
max_size=1000
)
# 异步处理
system.enable_async_processing(
max_workers=4,
batch_size=32
)
5.2 精度提升策略
- 多轮检索优化:结合粗排和精排模型
- 查询理解增强:使用大语言模型进行查询重写
- 结果多样性控制:避免返回过于相似的结果
- 反馈学习:基于用户点击行为优化排序
5.3 大规模部署建议
硬件配置:
- GPU:NVIDIA A10G或V100S(用于嵌入计算)
- 内存:每百万向量约4GB内存
- 存储:SSD用于向量索引存储
部署架构:
部署模式: 微服务架构服务拆分: - 内容提取服务 - 嵌入计算服务 - 向量检索服务 - API网关服务 - 缓存服务 - 监控服务
六、未来发展趋势
6.1 技术演进方向
- 多模态深度融合:文本、视觉、音频的端到端统一建模
- 实时检索优化:支持流式视频内容的实时索引和检索
- 个性化检索:基于用户历史行为的个性化结果排序
- 生成式增强:结合生成式AI的结果解释和总结
6.2 行业应用扩展
- 医疗健康:手术视频检索与分析
- 工业制造:生产线监控视频的异常检测
- 安防监控:事件驱动的智能视频检索
- 体育分析:比赛视频的技术分析
七、总结
基于RAG的视频检索技术正在重新定义我们对视频内容访问的方式。通过将先进的自然语言处理、计算机视觉技术与高效的信息检索系统相结合,我们能够实现从"观看视频"到"查询视频"的根本性转变。
核心价值体现:
- 效率革命:将小时级的查找时间缩短到秒级
- 体验升级:自然语言交互,无需记忆关键词
- 知识沉淀:将非结构化视频内容转化为可检索的知识资产
- 成本优化:减少人工标注和整理的工作量
实施建议:
- 从小规模试点开始:选择1-2个核心场景验证价值
- 建立质量评估体系:定义明确的准确率、召回率指标
- 迭代优化:基于用户反馈持续改进检索质量
- 考虑可扩展性:设计支持未来业务增长的技术架构
随着多模态AI技术的不断进步,基于RAG的视频检索系统将成为企业数字化基础设施的重要组成部分,为教育、培训、媒体、安防等多个行业带来变革性的价值。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
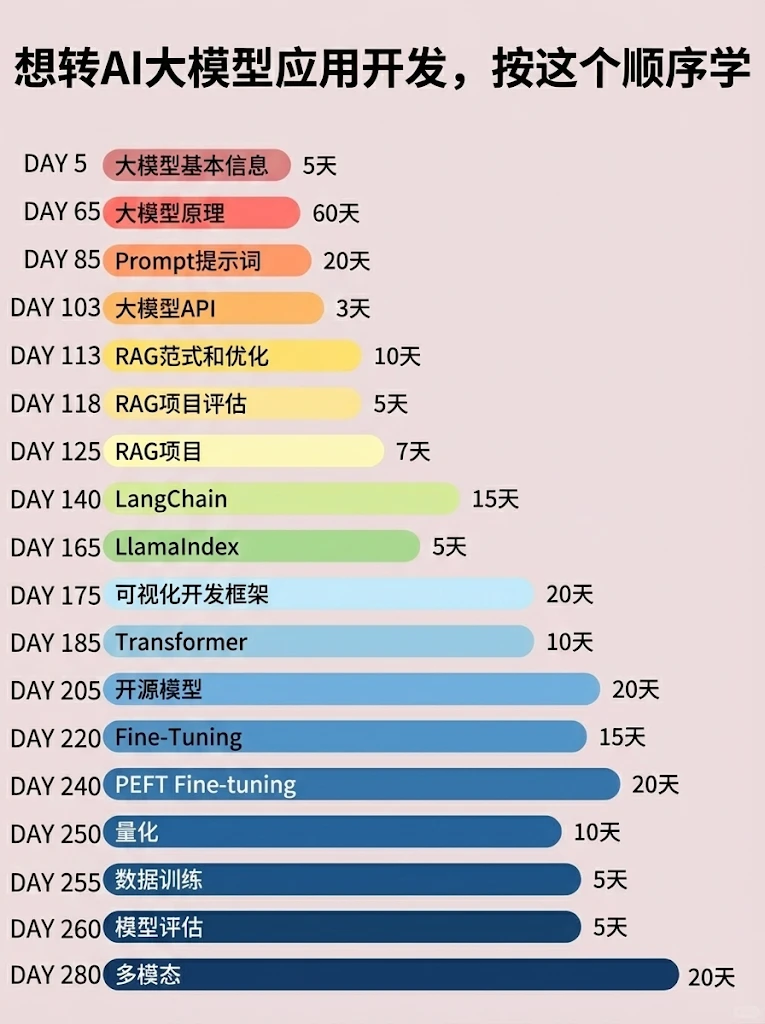
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 14
 0
- 0


 已为社区贡献2条内容

所有评论(0)