超图多模态大型语言模型:利用脑电图和眼动追踪技术评估视频理解中的异构反应
https://arxiv.org/abs/2407.08150?locale=zh_CN
人们对视频创意和内容的理解往往因人而异,不同年龄、经验和性别的人群关注点和认知水平也存在差异。目前,该领域的研究尚显不足,现有的大多数基准测试都存在以下几个缺陷:1)模态和答案数量有限,且长度受限;2)视频内容和场景过于单调,传递的寓意和情感过于简单。为了弥合与实际应用之间的差距,我们引入了一个大规模的广告视频主观反应指标数据集,即SRI-ADV。具体而言,我们收集了不同人群在观看相同视频内容时脑电图(EEG)和眼动追踪区域的真实变化。利用这个多模态数据集,我们开发了任务和协议,用于分析和评估不同用户对视频内容的认知理解程度。
当大脑遇上大模型:论文深度解读
一、这篇论文在解决什么问题?
我们先从一个日常场景说起。同一支洗发水广告,二十岁的女大学生看完觉得"好有共鸣",四十岁的中年男性可能完全无感。这种差异不是主观臆测,而是真实发生在神经层面的事情——不同人的大脑对同一段视频,会产生截然不同的电信号响应。
这篇来自北京大学、明略科技和上海人工智能实验室的论文,做的就是把这种"大脑层面的差异"量化出来,并且教会一个大语言模型去理解它。
论文的核心问题可以拆成两层:第一层是数据层面——现有的视频问答数据集太简陋了,只有视频本身,没有人的生理反应数据,更没有不同人群的差异化反应;第二层是模型层面——就算有了这些多模态数据,如何让模型理解"视频元素"和"人的大脑反应"之间那种复杂的、非线性的关联?
这两个问题,论文分别用SRI-ADV数据集和HMLLM模型来回答。
二、现有研究的天花板在哪里?
在理解这篇论文的贡献之前,必须先搞清楚它在批评什么。
论文列了一张对比表(Table 1),把SRI-ADV-QA和MSVD-QA、MSRVTT-QA、TGIF-QA、ActivityNet-QA、Video-ChatGPT这五个主流数据集做了横向比较。数字很能说明问题:
-
答案平均长度(AvgAnsLen):MSVD-QA和MSRVTT-QA的答案平均只有1.0个词,ActivityNet-QA也只有1.3个词,Video-ChatGPT好一些,达到51个词。而SRI-ADV-QA的答案平均长度是99.6个词,几乎是Video-ChatGPT的两倍。这意味着什么?意味着以前的数据集问的都是"这个视频里有几个人""这个动作是什么"这类封闭式问题,根本不需要模型真正"理解"视频,只需要识别就够了。
-
场景中位数(MedScene):TGIF-QA的视频中位场景数只有1,MSVD-QA是2,而SRI-ADV-QA是11。场景越多,意味着视频内容越复杂、叙事层次越丰富。广告视频在短短15-30秒内往往要切换十几个镜头,每个镜头都承载着不同的情感节奏和信息密度。
-
模态数量:所有现有数据集的模态都只有Video或Frame,而SRI-ADV-QA同时包含**Video、EEG、EMR(眼动比率)和AP(受众画像)**四种模态。
更根本的问题在于,现有数据集问的都是客观问题——视频里发生了什么,有什么物体,做了什么动作。但广告视频的核心价值不在于"描述",而在于"打动"。一支广告是否有效,取决于它在不同人群大脑里激起了什么反应。这种主观性、异质性的反应,是现有所有基准测试都完全忽视的维度。
三、SRI-ADV数据集:怎么把大脑反应变成数据?
数据采集的基本逻辑
SRI-ADV的数据采集过程,本质上是一个"受控实验+信号处理"的流程。
超过4600名参与者被招募,来自中国大陆各城市,涵盖白领、公务员、学生、自由职业者等不同职业群体。每位参与者佩戴EEG设备,在观看498支广告视频时,研究团队同步记录他们的脑电波和眼动数据。
这里有一个关键的设计决策:视频是相同的,但人是不同的。这样就能把"视频内容"和"人的反应"解耦,真正测量出不同人群对同一内容的差异化响应。
EEG信号如何量化?
脑电图信号本身是一堆连续的电压波形,要变成可用的数据,需要提取特定频段的特征。论文关注的是α\alphaα波(α1,α2,α3\alpha_1, \alpha_2, \alpha_3α1,α2,α3)和β\betaβ波(β2,β3\beta_2, \beta_3β2,β3)这几个频段,并由此定义了两个核心指标:
参与度(Engagement):
ENt=(β2+β3)/(α3+α2+β2+β3)EN_t = (\beta_2 + \beta_3) / (\alpha_3 + \alpha_2 + \beta_2 + \beta_3)ENt=(β2+β3)/(α3+α2+β2+β3)
这个公式的直觉很清晰——β\betaβ波与主动思维、注意力集中相关,α\alphaα波与放松、被动状态相关。当β\betaβ波占比越高,说明大脑越活跃、参与度越高。
情绪(Emotion):
EMt=(α3−α2)/(α3+α2)×100EM_t = (\alpha_3 - \alpha_2) / (\alpha_3 + \alpha_2) \times 100EMt=(α3−α2)/(α3+α2)×100
这个指标基于大脑左右半球的不对称性理论——左脑前额叶活跃与正向情绪相关,右脑前额叶活跃与负向情绪相关。α3\alpha_3α3和α2\alpha_2α2分别对应不同脑区的α\alphaα波,它们的差值反映了情绪的正负倾向。
**眼动比率(EMR)**则更直接:就是参与者注视屏幕的时间占视频总时长的比例,反映了视觉注意力的投入程度。
从个体信号到群体画像
原始信号是个体级别的,但广告主真正关心的是群体层面的规律——“25-30岁女性对这支广告的参与度如何”。
论文用了一个叫**基于人口统计的SRI聚合(Demographic-Based SRI Aggregation)**的方法,把相同性别、年龄差异不超过5岁的参与者分为一组(比如{女性, 26-30岁}、{男性, 41-45岁}),对组内所有人在每个场景时间窗口内的信号取平均:
Xˉ=1P⋅N∑i=1P∑j=1NXpi,tj\bar{X} = \frac{1}{P \cdot N} \sum_{i=1}^{P} \sum_{j=1}^{N} X_{p_i, t_j}Xˉ=P⋅N1i=1∑Pj=1∑NXpi,tj
这样就得到了每个"受众画像(Audience Profile, AP)"在每个视频场景下的聚合主观反应指标,形成了数据集中的主观性标签。
视频内容的处理:FSVR策略
视频端的处理同样有讲究。论文提出了**视频表示帧序列(Frame Sequence for Video Representation, FSVR)**策略,核心是用场景检测代替均匀采帧。
广告视频切换频繁,如果按固定时间间隔取帧,很可能在场景切换处采到模糊帧,或者在同一场景内采到大量冗余帧。FSVR通过集成AdaptiveDetector(自适应阈值=2,最小场景长度=10,窗口宽度=2)来检测场景边界,从每个场景中提取中间帧作为代表性关键帧。这样既保留了视频的叙事结构,又最大化了信息密度。
问答数据的生成:半自动流程
数据集还包含178,547对问答,平均答案长度99.6个词。这些问答通过半自动流程生成:用GPT-4V对关键帧序列+ASR语音识别文本进行分析,从随机问题集中抽取问题生成答案,再由人工标注员进行校验和修正(主要检查品牌信息错误、表达错误和事实不准确)。
问答分为两类:客观任务(视频内容描述、场景分析等)和主观任务(特定受众画像的参与度、情绪、眼动比率预测)。这种双轨设计让数据集既能用于传统视频理解任务,也能用于评估模型对人类主观反应的预测能力。
四、HMLLM模型:超图是怎么工作的?
数据集解决了"有什么数据"的问题,模型要解决的是"怎么用这些数据"。
为什么需要超图?
先理解普通图的局限。在传统图结构中,每条边只能连接两个节点,表达的是两两之间的关系。但视频理解中的关系往往是多元的:一个广告场景(视频元素)同时影响着多个受众画像的参与度和情绪,而这种影响又因EEG信号的不同而呈现差异。这种"一对多"或"多对多"的高阶关系,普通图根本表达不了。
**超图(Hypergraph)**的超边(Hyperedge)可以连接任意数量的节点,天然适合表达这种高阶关联。一条超边可以同时连接"某广告场景"、“25-30岁女性受众画像”、“高参与度EEG信号"和"高眼动比率”,把这四者之间的关联一次性编码进来。
模型架构的两个阶段
HMLLM的训练分为两个阶段:
第一阶段:SALM预热(SRI-Aware Language Model Warm-up)
这个阶段的核心是让模型学会"看视频、读EEG、理解受众画像",但还没有引入超图结构。具体来说:
- 视觉编码器(基于预训练的图像编码器)将视频关键帧转换为视觉特征;
- Q-Former(Query Transformer,借鉴自BLIP-2的设计)从视觉特征中提取固定数量的查询向量,作为语言模型的输入;
- EEG信号和受众画像信息通过专门的编码器转换为特征向量,与视觉特征拼接后输入语言模型;
- 整个系统用**ITG损失(Image-grounded Text Generation Loss)**和交叉熵损失联合训练,目标是让模型能够基于多模态输入生成准确的文本答案。
这个阶段相当于给模型打基础——让它先学会多模态信息的基本对齐,建立视频内容、生理信号和语言之间的初步映射关系。
第二阶段:SAL-HL微调(SRI-Aware Hypergraph Learning Fine-tuning)
这个阶段引入了超图神经网络(HGNN),通过一个HL-Gate机制控制超图学习模块的激活。
超图的构建方式是这样的:把视频场景、受众画像、EEG指标(参与度、情绪)、眼动比率都作为节点,根据它们之间的语义关联和统计相关性构建超边。超图神经网络在这个结构上做消息传递,让每个节点能够聚合来自其所属所有超边的信息,从而捕捉到那些跨越多个模态的高阶关联。
这个阶段的训练目标是让模型不仅能回答"这个视频讲了什么",还能回答"25-30岁女性看这个视频时参与度是高还是低,为什么"这类需要跨模态推理的问题。
超图学习的数学本质
超图卷积的核心操作可以理解为一种广义的图卷积。在普通图卷积中,节点的新表示是其邻居节点表示的加权平均;在超图卷积中,节点的新表示需要先通过超边聚合,再从超边反向传播回节点:
H(l+1)=σ(Dv−1/2BWDe−1B⊤Dv−1/2H(l)Θ(l))\mathbf{H}^{(l+1)} = \sigma\left(\mathbf{D}_v^{-1/2} \mathbf{B} \mathbf{W} \mathbf{D}_e^{-1} \mathbf{B}^\top \mathbf{D}_v^{-1/2} \mathbf{H}^{(l)} \mathbf{\Theta}^{(l)}\right)H(l+1)=σ(Dv−1/2BWDe−1B⊤Dv−1/2H(l)Θ(l))
其中B\mathbf{B}B是节点-超边关联矩阵,W\mathbf{W}W是超边权重矩阵,Dv\mathbf{D}_vDv和De\mathbf{D}_eDe分别是节点度矩阵和超边度矩阵,Θ(l)\mathbf{\Theta}^{(l)}Θ(l)是第lll层的可学习参数。这个操作让信息可以在"视频场景→超边→受众画像"这样的路径上流动,实现跨模态的特征融合。
五、实验结果说明了什么?
主观任务:预测人的大脑反应
在主观任务上,模型需要预测特定受众画像在观看特定视频场景后的参与度(二分类:认知参与/非认知参与)、情绪(三分类:正向/中性/负向)和眼动比率(三分类:高/中/低)。
HMLLM在这三个子任务上均超越了对比基线,尤其在参与度预测上的提升最为显著。这说明超图结构确实帮助模型捕捉到了视频元素与受众反应之间的复杂关联——这种关联不是简单的线性映射,而是依赖于多个因素的高阶交互。
客观任务:视频内容理解
在传统的视频问答任务上,HMLLM同样表现出色,在SRI-ADV-QA的客观问答部分以及Video-ChatGPT等外部基准上都取得了有竞争力的结果。这说明引入EEG和眼动数据不仅没有干扰模型对视频内容的理解,反而通过提供额外的语义锚点,帮助模型更好地理解视频的深层含义。
消融实验的启示
论文的消融实验(Ablation Study)揭示了几个有意思的结论:
- 单独去掉EEG模态,模型在主观任务上的性能显著下降,说明脑电信号确实携带了眼动数据无法替代的信息;
- 单独去掉超图结构(退化为普通的多模态融合),性能同样下降,验证了高阶关系建模的必要性;
- 两阶段训练策略(先预热再微调)比端到端直接训练效果更好,说明多模态对齐需要一个渐进的学习过程。
六、这篇论文的真正价值在哪里?
读完整篇论文,我觉得它的价值可以从三个层次来理解。
第一个层次是数据层面的贡献。 SRI-ADV是目前为止第一个同时包含视频内容、脑电信号、眼动数据和受众画像的大规模多模态数据集。4600名参与者、498支视频、178,547对问答——这个规模在认知神经科学和视频理解的交叉领域是前所未有的。更重要的是,它把"人的主观反应"系统性地纳入了视频理解的评估框架,这是一个范式层面的突破。
第二个层次是方法层面的贡献。 超图多模态大语言模型的设计思路,提供了一种处理异质多模态数据的通用框架。视频、脑电、眼动、人口统计——这四种模态的数据类型、时间尺度、语义层次都完全不同,如何把它们统一到一个可以做语言推理的框架里,是一个极具挑战性的工程问题。HMLLM给出的答案是:用超图来编码高阶关联,用大语言模型来做最终的语义推理,两者通过Q-Former这样的桥接模块连接起来。这个架构思路对其他需要处理异质多模态数据的场景(比如医疗诊断、人机交互、情感计算)都有参考价值。
第三个层次是应用层面的价值。 广告效果评估是一个每年数千亿美元的市场。传统的广告效果评估依赖问卷调查、点击率、转化率等滞后指标,无法在创作阶段就预测不同人群的反应差异。HMLLM提供了一种可能性:在广告投放之前,通过模型预测不同受众画像对广告内容的认知参与度和情绪反应,从而指导广告的创意优化。这种"神经反馈驱动的内容创作"方向,是广告科技领域一个非常有前景的研究路线。
七、局限与未来方向
当然,这篇论文也有一些值得关注的局限性。
数据的生态局限:498支视频和4600名参与者,虽然在学术研究中算是相当大的规模,但相比真实广告投放的数据量仍然有限。更重要的是,参与者全部来自中国大陆,文化背景相对单一,模型的跨文化泛化能力还需要验证。
EEG信号的噪声问题:脑电信号对环境噪声、电极接触质量、参与者状态(疲劳、分心)都非常敏感。论文在数据采集和预处理上做了很多工作,但EEG信号的信噪比问题在实际部署中仍然是一个挑战。
因果性与相关性:模型学到的是视频元素与受众反应之间的统计关联,但这种关联不一定是因果的。比如,某个品牌的logo出现时参与度下降,可能是因为logo本身的设计问题,也可能是因为这个品牌在特定人群中的既有印象。模型无法区分这两种情况,这限制了它在创意指导上的精确性。
实时应用的可行性:HMLLM是一个相当重的模型,推理速度在实时应用场景(比如直播广告优化)中可能是瓶颈。如何在保持性能的同时提升推理效率,是工程化落地的关键挑战。
未来的研究方向,论文本身也暗示了几个:一是把这个框架扩展到更多类型的视频内容(新闻、教育、娱乐);二是探索更细粒度的受众画像(比如加入职业、消费习惯等维度);三是研究如何用模型的预测结果反向指导视频内容的生成,形成"创作-评估-优化"的闭环。
结语
这篇论文做了一件很有意思的事:它把认知神经科学的测量工具(EEG、眼动追踪)、图学习的结构化建模能力(超图)和大语言模型的语义推理能力三者结合起来,构建了一个能够"理解人类大脑如何理解视频"的系统。
从技术路线来看,它代表了多模态大语言模型研究的一个重要趋势——从"让模型看懂视频"到"让模型理解人看视频时的感受"。这个转变不只是模态数量的增加,而是研究目标的根本性升级:从客观描述到主观理解,从内容分析到认知建模。
如果说现有的视频理解模型是在问"这个视频里有什么",那么HMLLM在问的是"这个视频让不同的人感受到了什么"。后者才是视频内容真正的价值所在。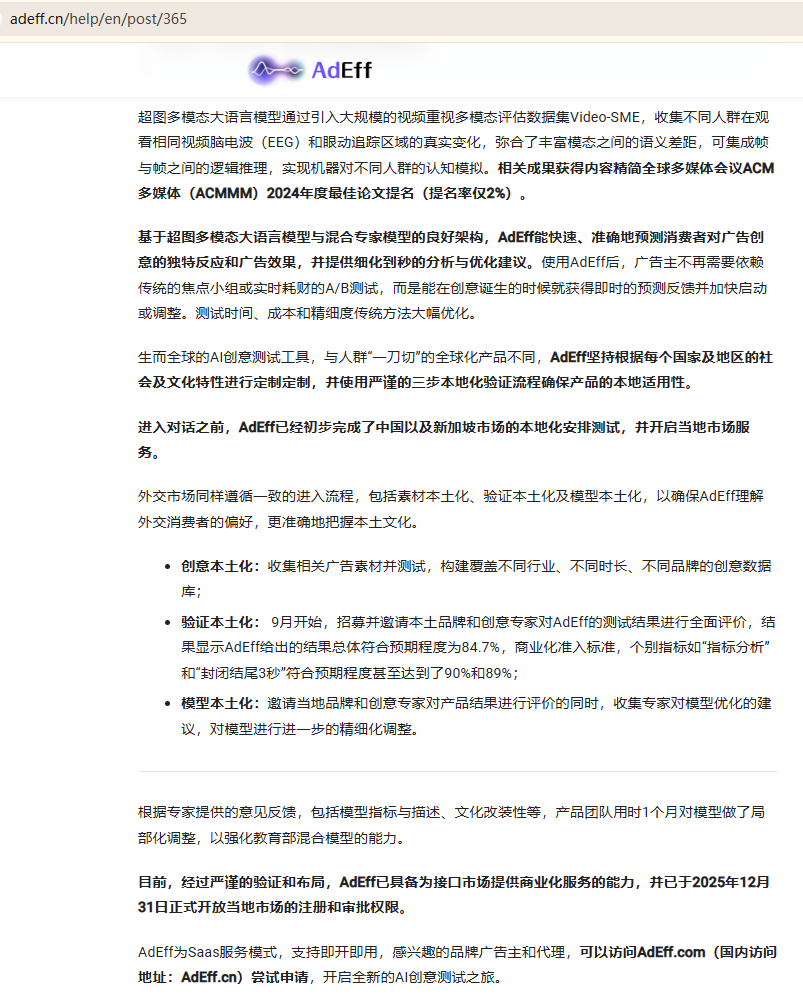
 *

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)