谷歌:轻量编码器解锁长视频理解
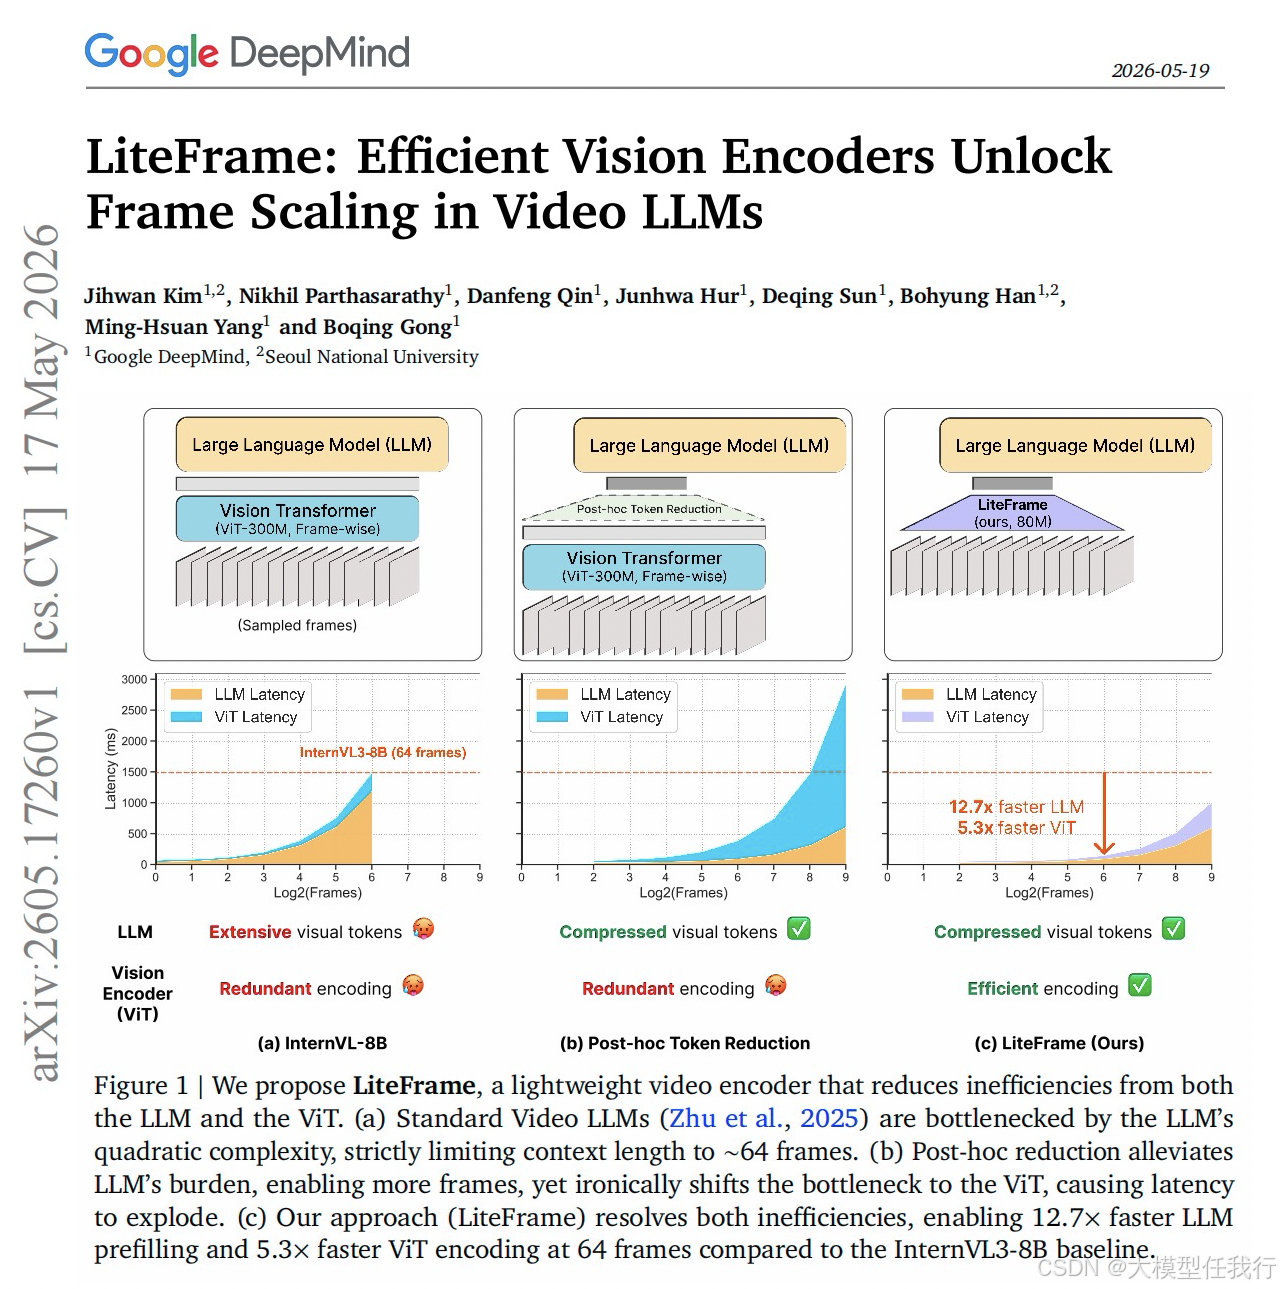
📖标题:LiteFrame: Efficient Vision Encoders Unlock Frame Scaling in Video LLMs
🌐来源:arXiv, 2605.17260v1
🛎️文章简介
🔸研究问题:现有的视频大模型在扩展长视频理解时,事后令牌缩减策略虽降低了 LLM 负担,却导致视觉编码器成为新的延迟瓶颈,如何同时优化两端以实现高效扩展?
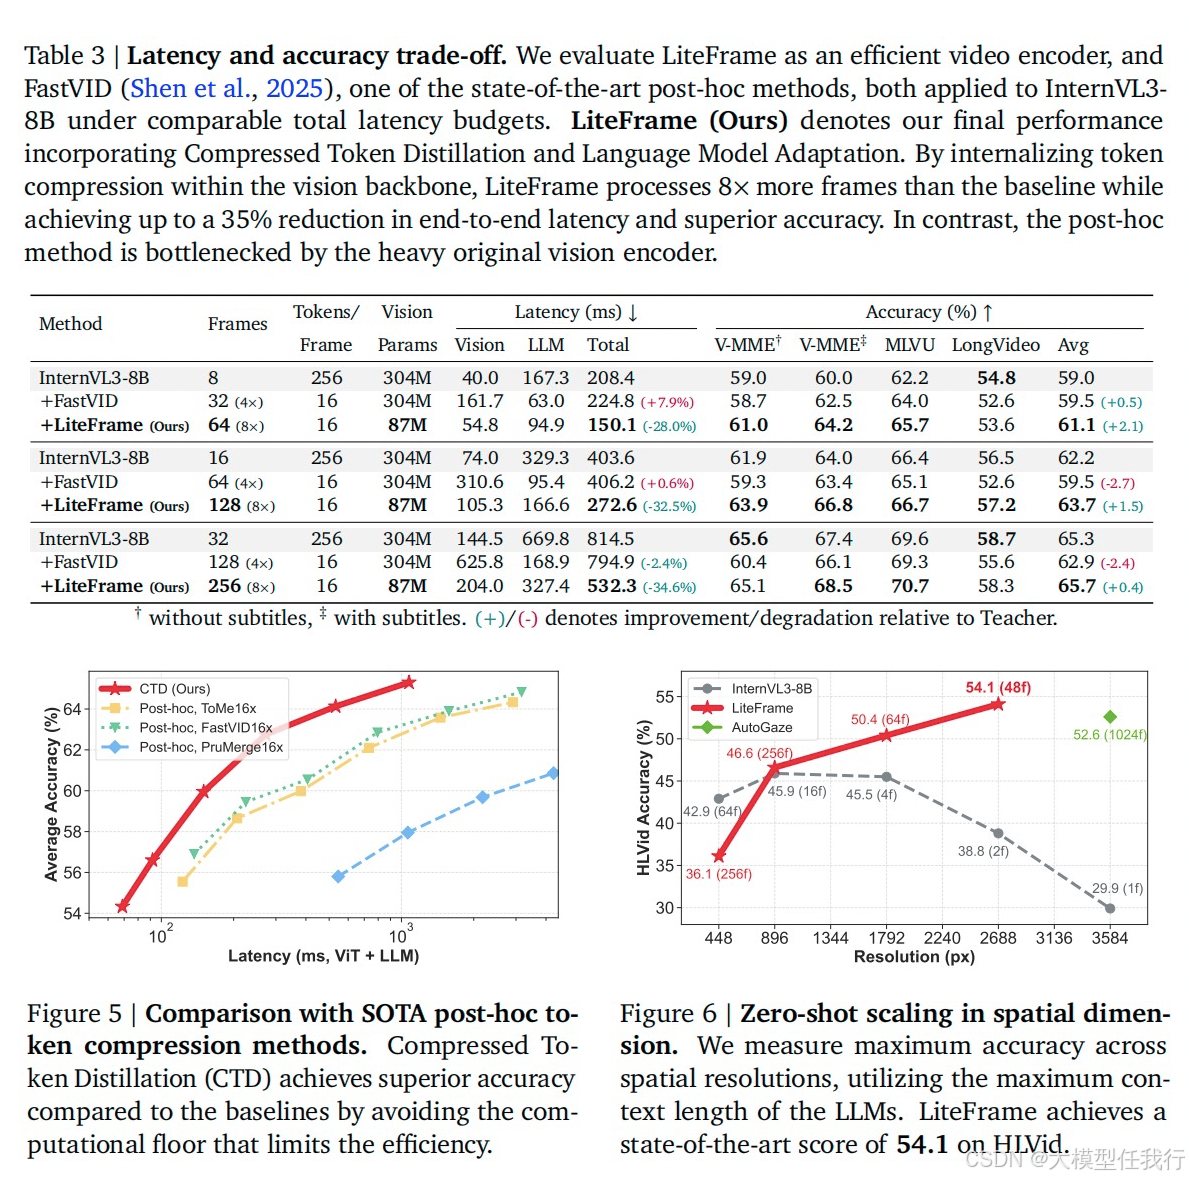
🔸主要贡献:论文提出了 LiteFrame 高效视频编码器及压缩令牌蒸馏框架,在降低端到端延迟 35% 的同时处理 8 倍帧数并提升准确率。
📝重点思路
🔸提出 LiteFrame 轻量级视频编码器架构,通过在空间注意力层间穿插深度wise 时间卷积,逐步在时空维度下采样特征,从内部消除冗余而非事后修剪。
🔸设计压缩令牌蒸馏(CTD)训练框架,利用加权平均池化将教师模型的稠密特征压缩为信息密集的时空表示,指导学生网络直接预测该压缩表征以绕过冗余计算。
🔸引入语言模型适配(LMA)阶段,使用 LoRA 微调 LLM 与学生编码器,使其适应扩展的时序上下文并弥合模态差距,进一步优化潜在空间。
🔸采用加权平均池化作为核心压缩原语,相比复杂的剪枝或合并策略,它能更好地保持时空结构的连续性并作为蒸馏的监督目标。
🔎分析总结
🔸实验表明 LiteFrame 重新定义了效率与准确率的帕累托前沿,相比 InternVL3-8B 基线,在处理 8 倍帧数的情况下端到端延迟降低 35% 且平均准确率更高。
🔸事后令牌缩减方法随着帧数增加会导致视觉编码器延迟爆炸,而 LiteFrame 通过内部压缩成功规避了这一计算下限,实现了真正的长视频扩展。
🔸消融研究证实,结合时空压缩的学生架构、深度 wise 时间卷积以及 CTD 蒸馏目标缺一不可,其中显式对齐池化原语比通用重构任务更有效。
🔸该方法不仅适用于长视频,在零-shot 空间分辨率缩放任务中也表现出优越性,能在高分辨率下平衡时空分辨率,超越需要更高计算成本的现有方法。
💡个人观点
论文发现了“事后缩减”范式中将瓶颈从 LLM 转移至视觉编码器的关键盲区,提出将令牌压缩机制“内化”到轻量级编码器设计中。

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)