【VLM】视频理解benchmark:Video-MME v1和v2
note
- Video-MME-v1基准内置12种独立任务题型,覆盖基础视觉→时序动态→高阶综合推理全维度:
- 时序行为、运动模式、多目标跨帧追踪、时序先后推理、事件因果推导、长视频摘要、跨模态信息融合、多语言视频理解、细节定位、空间关系推理、抽象剧情理解、多线索综合问答
- Video-MME-v2想推动的是一次评测理念上的转变,真正需要比较的是谁能够在连续、动态、多模态的信息中,像人一样,真正理解正在发生的事情
文章目录
一、Video-MME
1、Video-MME介绍
论文:Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis
- 项目主页(榜单、数据集、任务说明):https://video-mme.github.io/home_page.html
- GitHub评测代码仓库:https://github.com/BradyFU/Video-MME
arXiv论文:https://arxiv.org/pdf/2604.05015
二、核心优化点
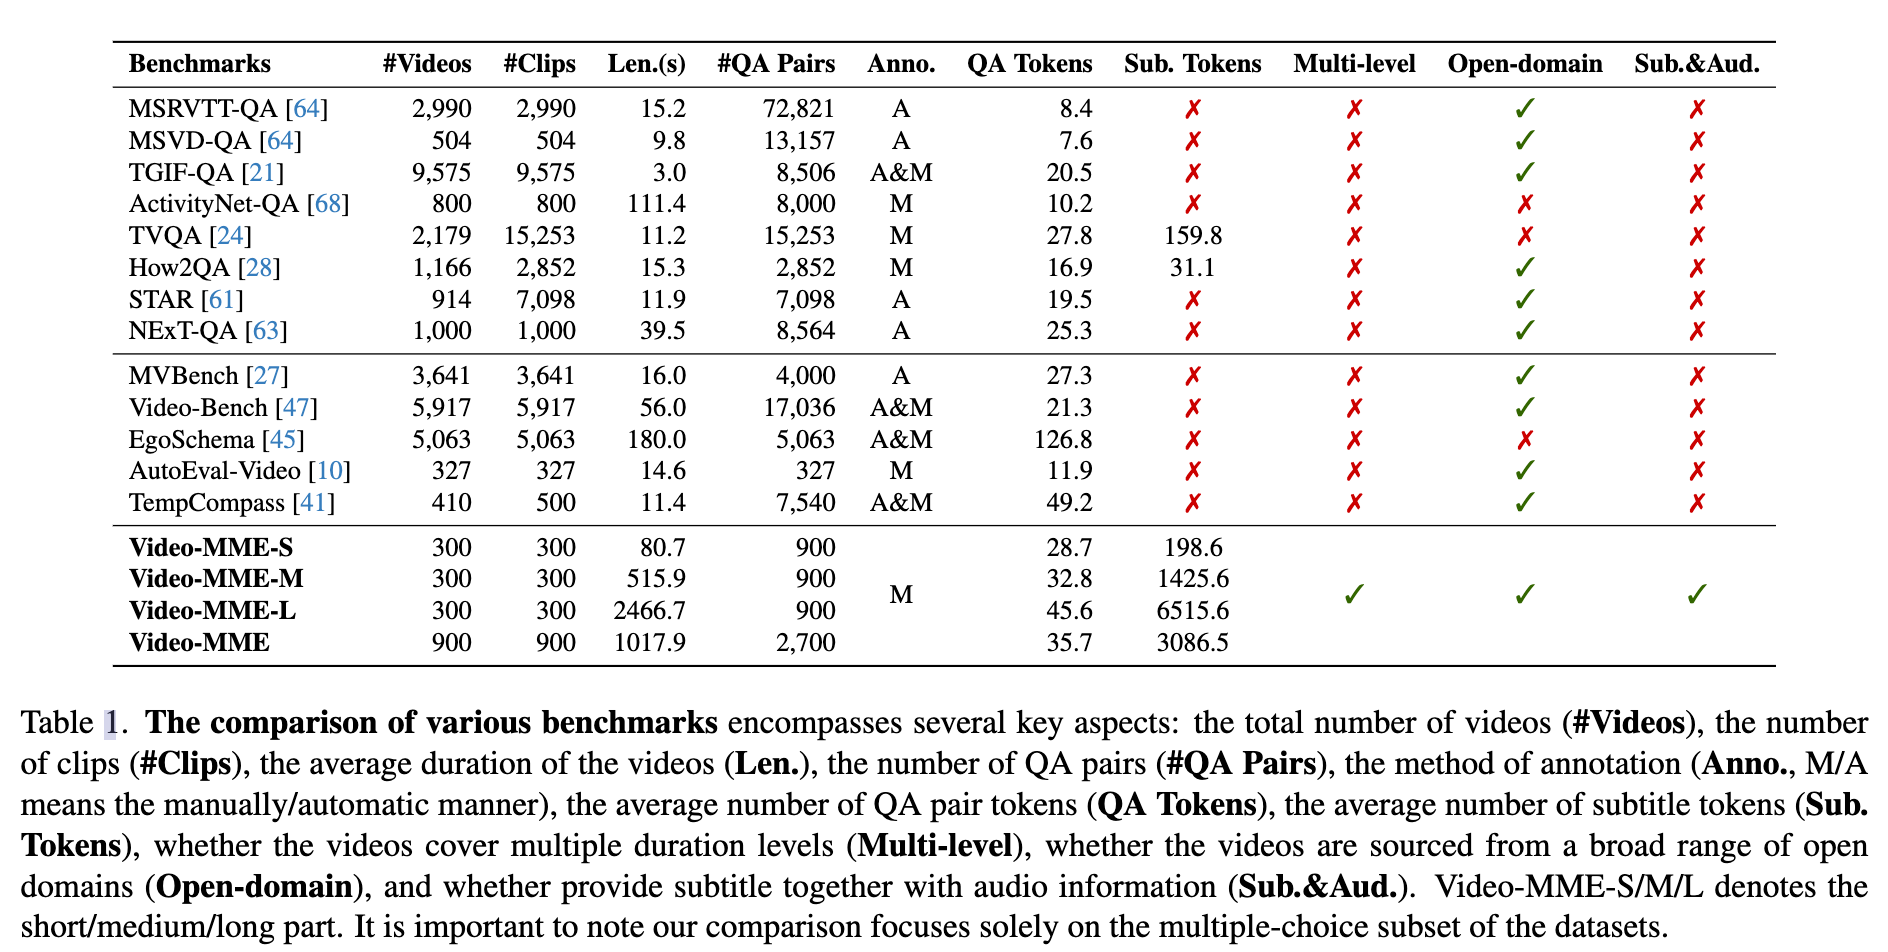
- 研究痛点:过往多模态评测基准仅聚焦静态图像,缺少覆盖长短时序、音视文多模态融合的标准化视频评测集,无法统一衡量时序记忆、跨帧推理、多线索联合理解能力。
-
四大核心设计
◦ 场景全覆盖:6大主领域(知识科普、影视、体育、舞台艺术、日常记录、多语言),30个细分子场景;
◦ 完整时序跨度:视频时长11秒~1小时,分短/中/长视频,专门测试长上下文记忆;
◦ 多模态输入范式:支持纯画面、画面+字幕、画面+音频三种评测模式,量化音/文本对视频理解的增益;
◦ 高质量人工标注:900段视频(总254小时)、2700道选择题,全程人工校验,无机器生成脏数据。 -
核心创新:构建12类分层视频理解评测任务体系,从底层视觉感知到高层综合推理全覆盖,形成完整能力分层评测标准。
2、Video MME 12类任务体系
基准内置12种独立任务题型,覆盖基础视觉→时序动态→高阶综合推理全维度:
-
画面物体识别:识别画面内物体、属性、场景基础视觉感知
-
动作识别:区分人物/物体动态行为、运动模式
-
多目标跨帧追踪:持续定位多物体在不同时间戳的位置变化
-
时序先后推理:判断事件、动作发生的时间先后顺序
-
事件因果推导:基于时序上下文分析事件发生的因果逻辑
-
长视频摘要:提取数十分钟长视频核心主线、关键情节
-
跨模态信息融合:联合画面、字幕、音频信息完成统一推理
-
多语言视频理解:适配带多语种字幕/语音的跨语言视频问答
-
细节定位:精准定位特定物体、台词、动作出现的时间片段
-
空间关系推理:判断物体间远近、方位、遮挡等空间约束
-
抽象剧情理解:解读隐喻、人物情绪、剧情伏笔、叙事逻辑
-
多线索综合问答:融合时序、空间、音文多条线索做多跳推理
3、Video MME关键实验结果
Video MME关键实验结果(2025年版):

- 闭源模型性能:Gemini 1.5 Pro平均精度75%,高于GPT-4o(71.9%),为初代榜单最优;
- 时序衰减规律:所有模型准确率随视频时长拉长持续下降,开源模型长时序短板显著大于闭源;
- 模态增益结论:叠加字幕/音频输入后,模型整体准确率提升8%~15%,单帧视觉不足以支撑复杂推理;
- 任务分层差距:12类任务性能分化明显,抽象剧情、长视频摘要、多线索综合问答是所有模型普遍弱项。
二、Video-MME-v2
链接:https://arxiv.org/pdf/2604.05015
1、benchmark介绍
考虑三个维度:
1、信息检索和聚合
2、时序理解
3、复杂推理
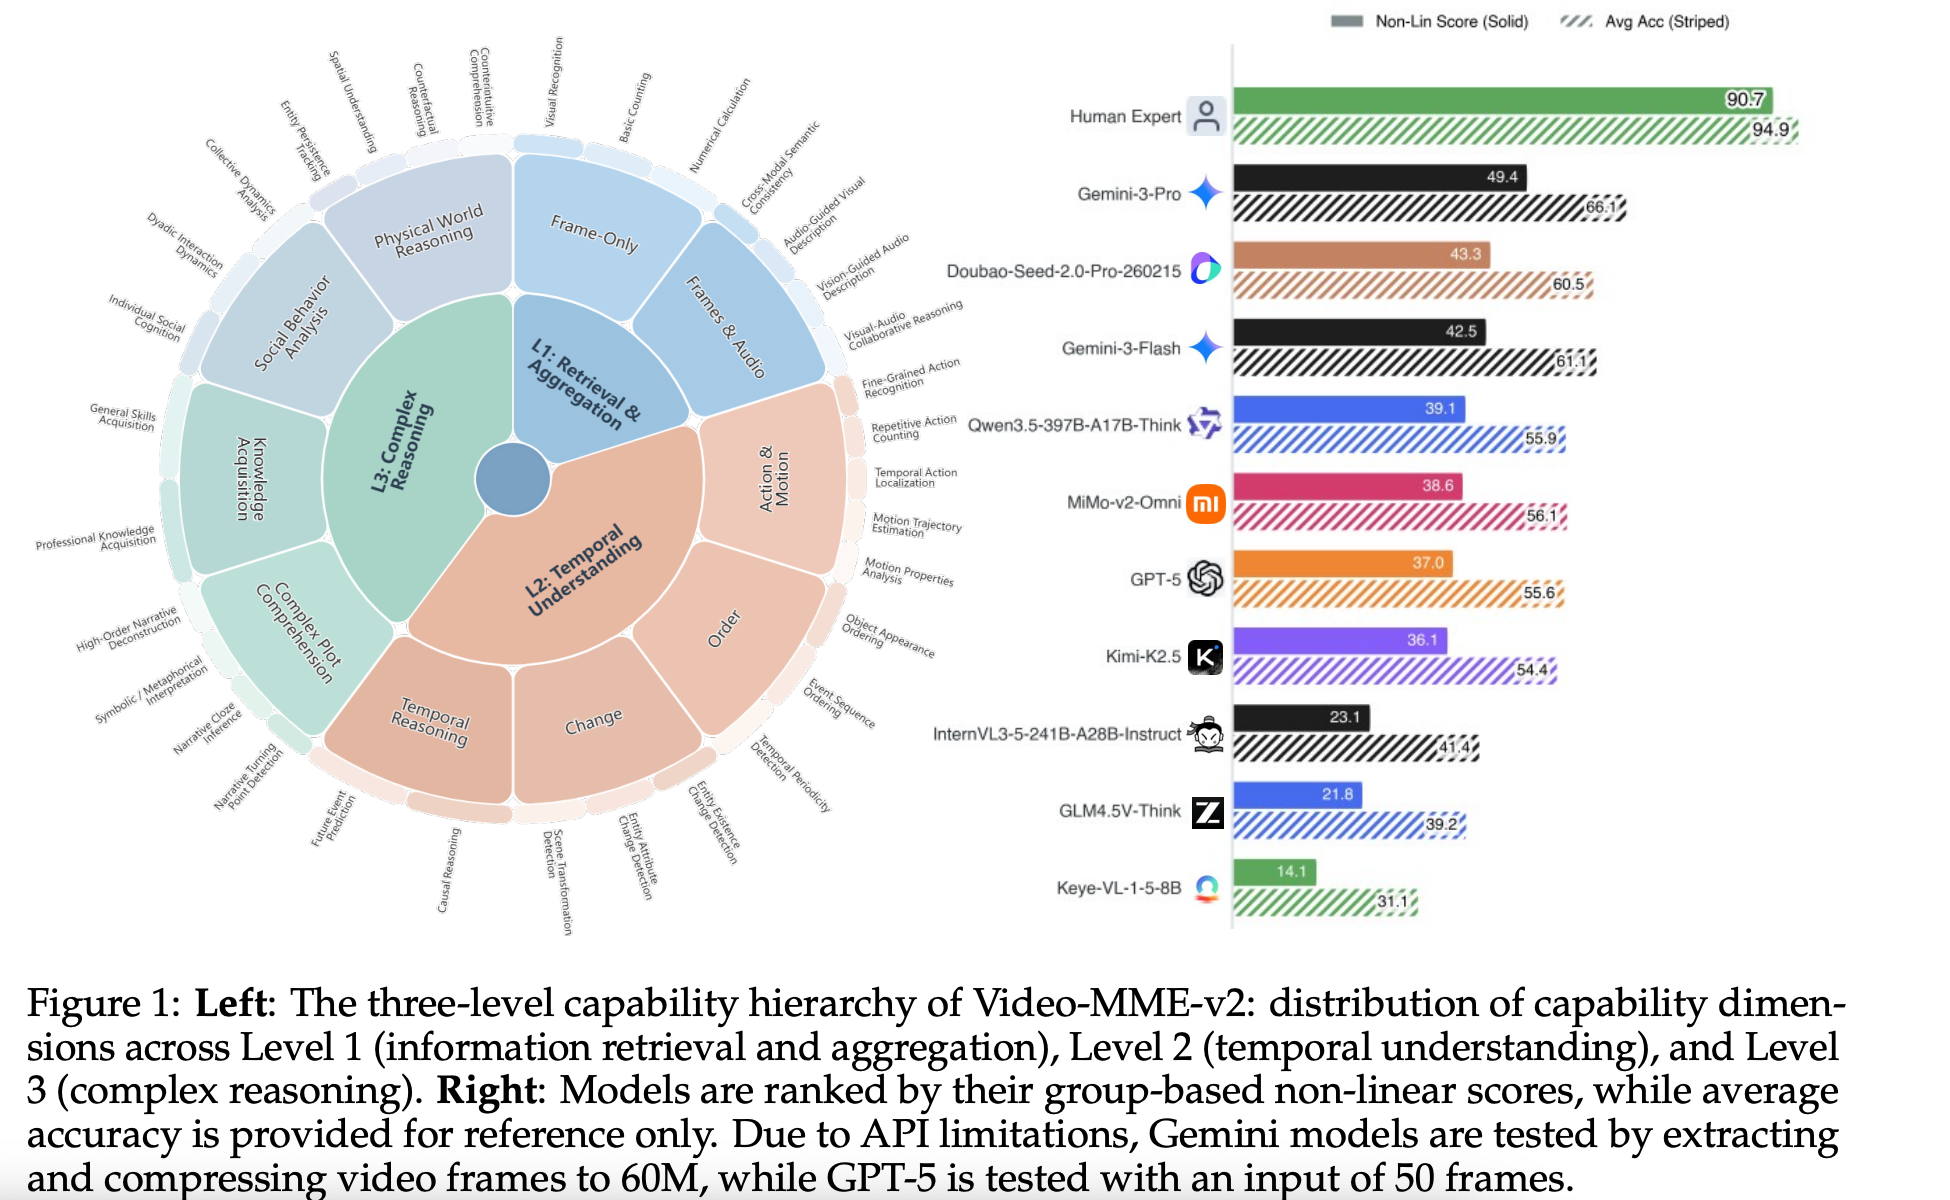
评测方法:
1、能力一致性考察:多个角度提问确保模型是真的会
2、推理连贯:非线性评分机制(如零散答对几题不能拿高分、首错阶段机制)
传统单选题目benchmark,高估模型效果
目前效果:gemini 3 pro领先,seed2.0 pro紧随其后,但是和human差别仍然很大
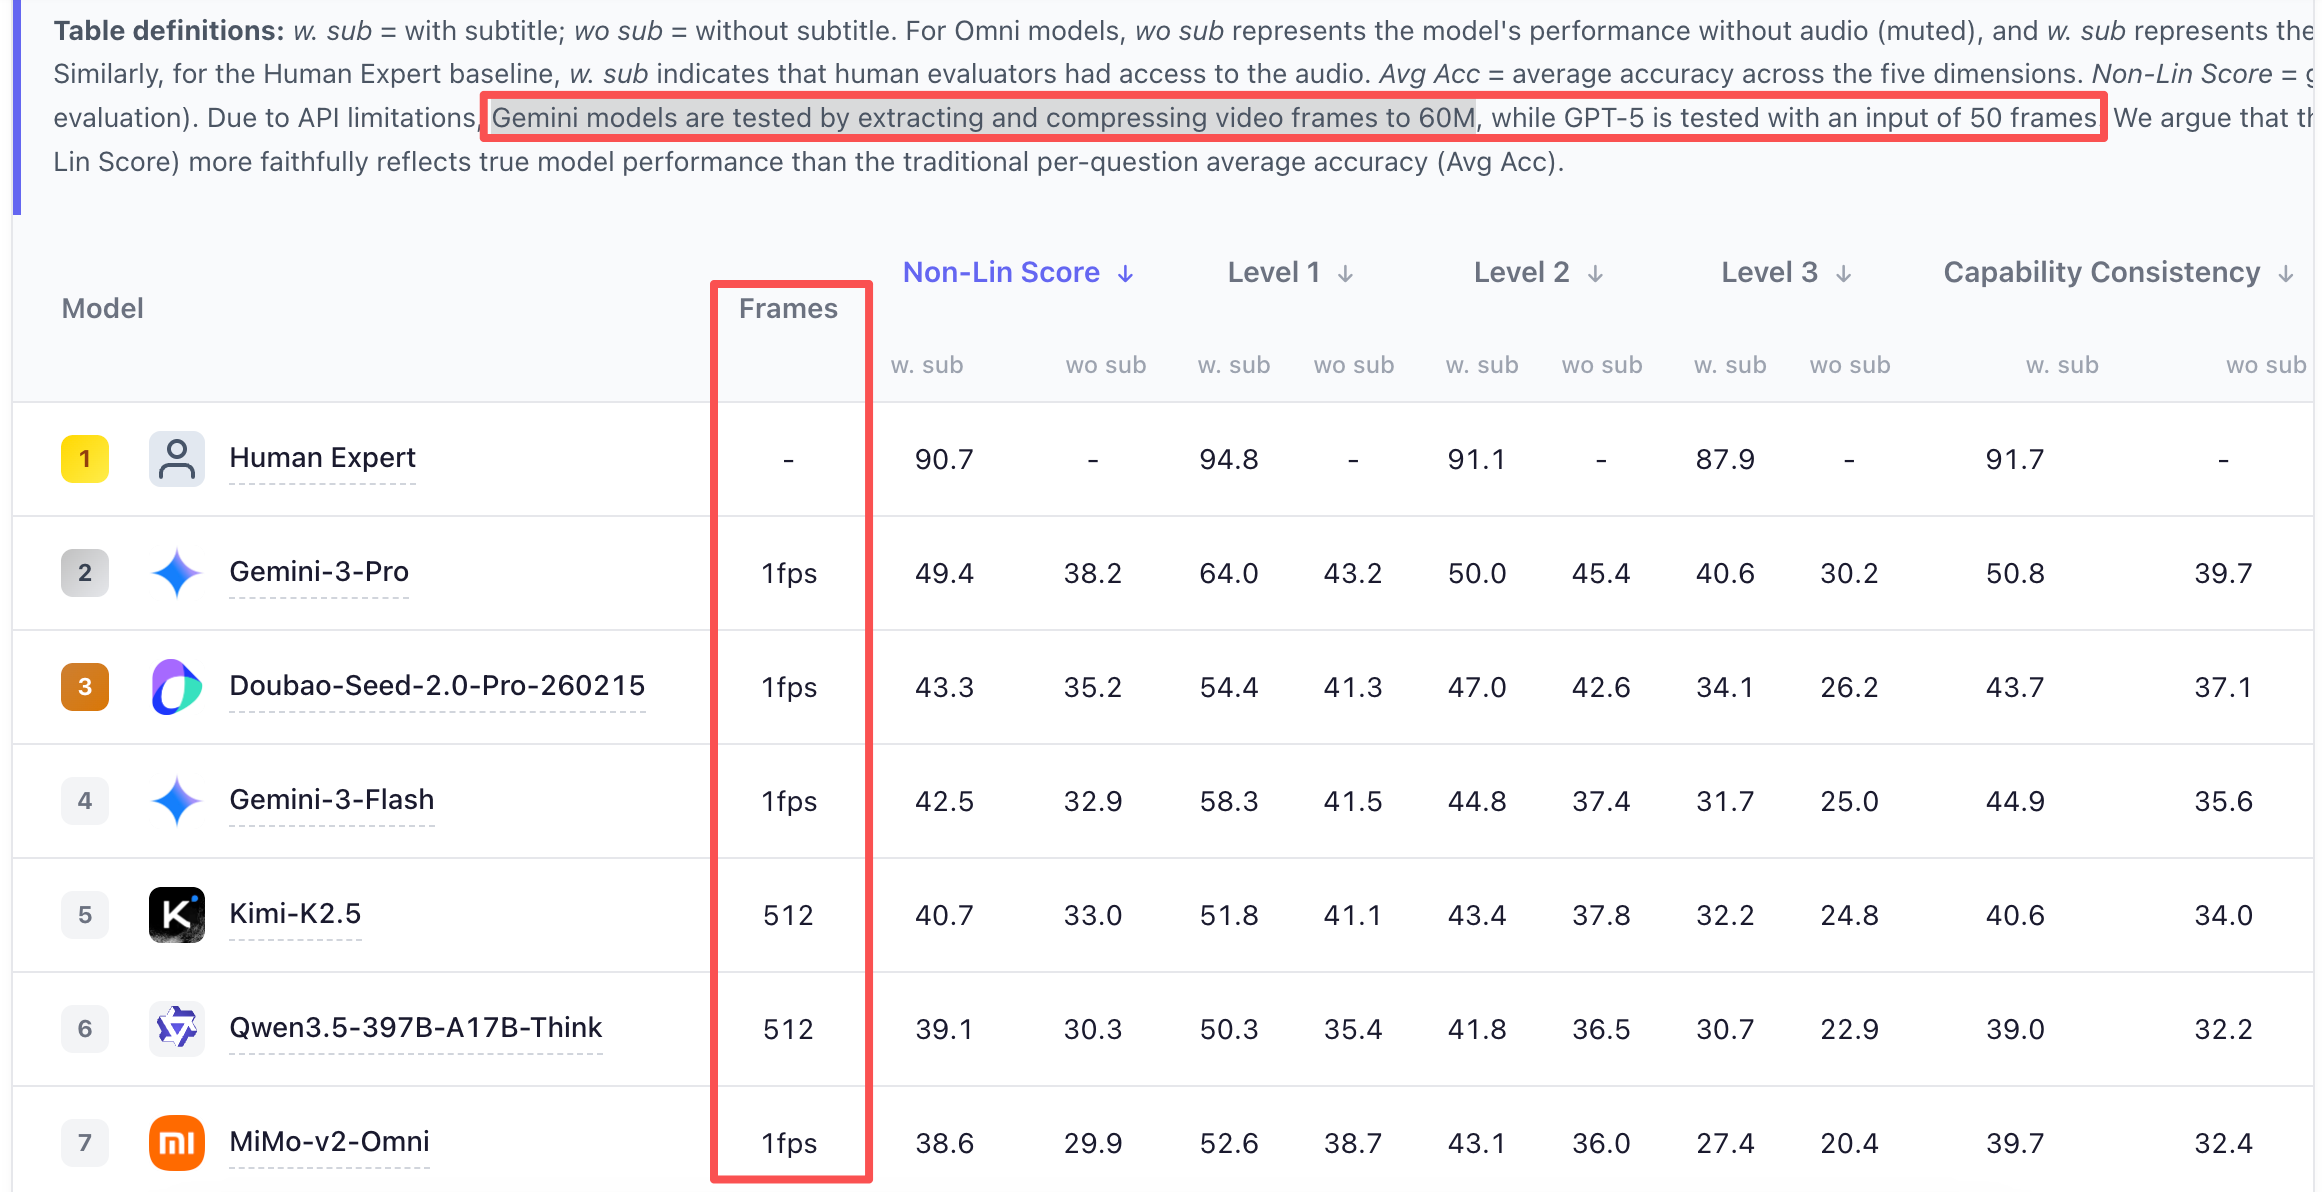
非常直观的评测结果显示(截止20260704):人类专家的非线性得分为90.7(传统ACC为94.9),而当前最强的商业模型Gemini-3-Pro得分仅为49.4,开源模型Qwen最好的结果为39.1。在更严格的评测框架下,模型与人类之间仍然存在显著差距。
2、数据统计
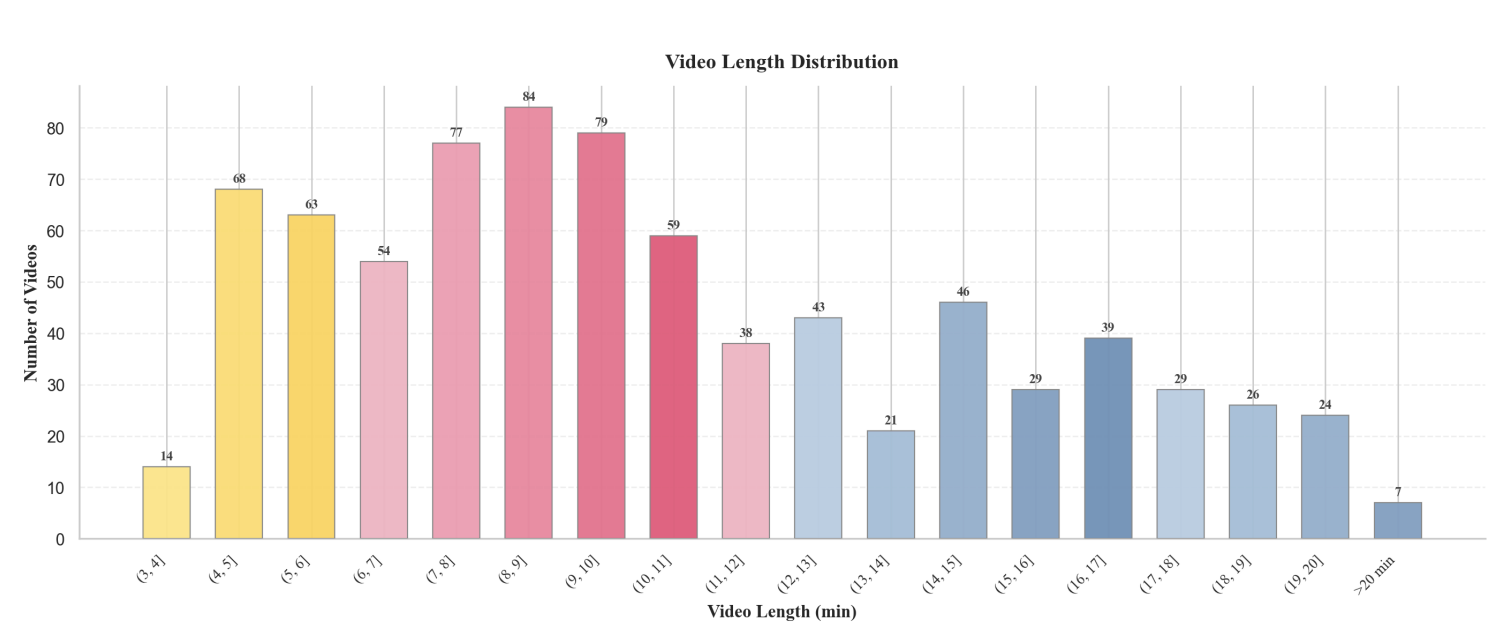
数据长度分布统计:
3、thinking的收益
thinking的收益不是无条件成立的,它高度依赖文本线索。
论文实验显示,开启 Thinking 后,模型在"有字幕/音频"的设定下,通常比在"纯视觉"设定下获得更明显的提升。 例如,Qwen3.5-122B-A10B-Think(64 frames) 在无字幕和有字幕设置下,分别带来 +3.8/+5.8 的提升。这说明,显式文本语义仍然是很多模型完成多步推理时非常重要的"锚点"。
但另一方面,Thinking 也可能带来退化。Qwen3-VL-8B 在无字幕设定下出现了 -0.6 的下降,而 KimiVL-16B 在整体上出现了 -3.3/-3. 的性能回落,在更强调复杂推理的 Level 3 上,退化甚至达到 -4.0/-3.9。
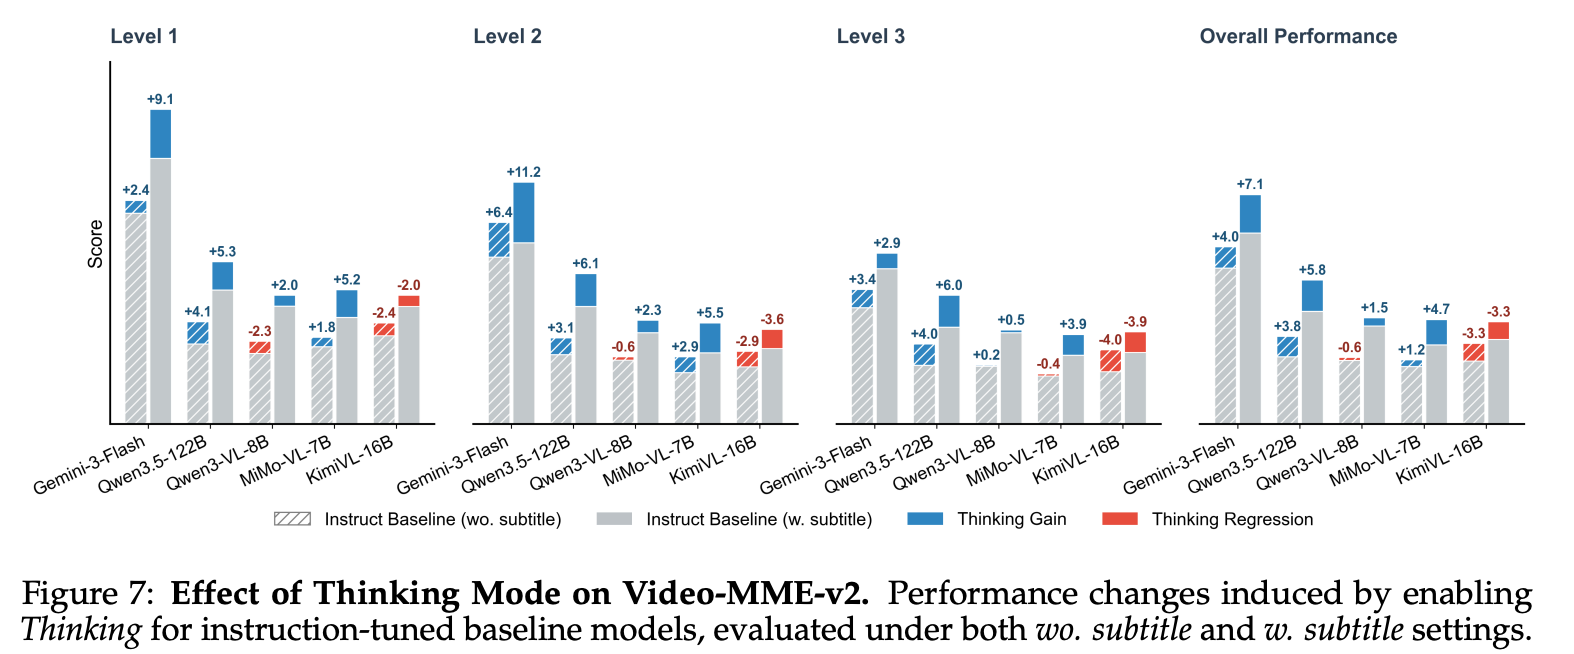
总结:当前很多模型的"推理增强",本质上仍然更擅长利用语言线索,而不是稳定地从纯视觉、纯音频中抽取支撑推理的证据。一旦文本锚点不足,Thinking 不但未必增益,反而可能引入更多噪声。
Reference
[1] Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis
[2] Video-MME-v2: Towards the Next Stage in Benchmarks
for Comprehensive Video Understanding

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 8
 0
- 0


 已为社区贡献7条内容

所有评论(0)