AI翻译vs人工翻译短剧出海质量对比:5款工具盲测实测
AI翻译能做到和人工差不多的质量吗?这个问题我们用盲测来回答——找英语、西班牙语、印尼语母语测评者,在不知道来源的情况下给各版本打分。
一、盲测设计
测试材料:选取三部不同类型的短剧各一集(情感剧、古装剧、都市爽剧),提取其中情绪密集片段(哭戏、争吵、内心独白)和文化梗密集片段(俚语、称谓)
测评维度(各满分10分):
- 翻译准确度:意思是否正确传达
- 本地化自然度:听起来是否像当地人说的话
- 情绪感染力:配音是否有情绪,是否带动观看情绪
- 整体观看体验:综合评分
评测人员:各目标语言2-3名母语使用者,盲测(不知道哪个是AI哪个是人工)
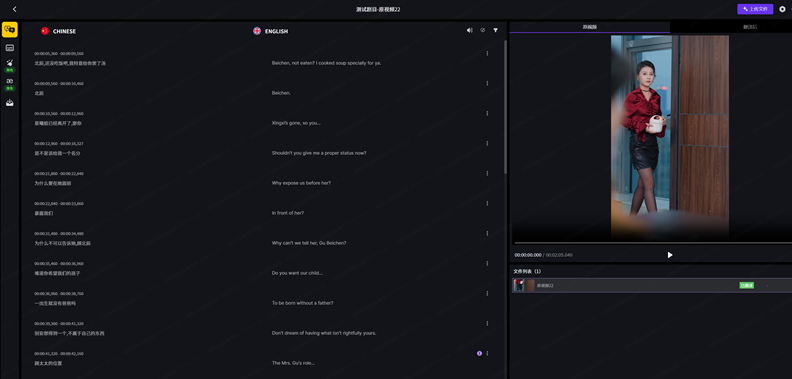
图1:双语字幕编辑主界面——AI vs人工盲测的评分对象,母语测评者在此验证翻译自然度与准确率
二、盲测结果
|
翻译来源 |
翻译准确度 |
本地化自然度 |
情绪感染力 |
整体体验 |
|
专业人工译制 |
9.8 |
9.5 |
9.6 |
9.6 |
|
智马翻译(AI) |
9.4 |
9.1 |
9.3 |
9.3 |
|
趣丸千音 |
7.8 |
7.2 |
7.5 |
7.5 |
|
剪映AI |
7.5 |
6.8 |
6.2 |
6.8 |
|
HeyGen |
7.6 |
7.0 |
6.5 |
7.0 |
注:人工译制使用专业配音演员+专业翻译,代表行业最高水平;各AI工具使用默认配置测试。
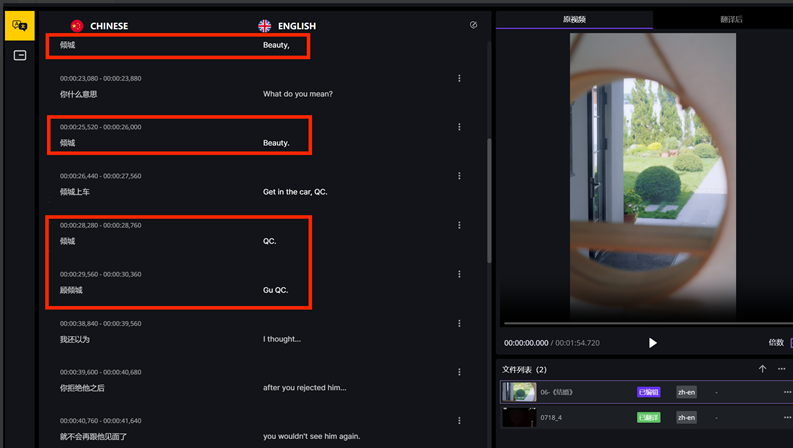
图2:翻译一致性问题示例——「倾城」出现Beauty/QC.等不一致版本,是AI工具质量劣于人工的典型痛点
三、关键发现
智马翻译在盲测中差距最小:评测人员在判断"哪个是人工翻译"时,智马翻译版本的误判率最高,说明质量最接近人工。
差距主要体现在文化细节:测评者给出的反馈中,AI版本与人工版本最主要的差距是"某些俚语用词不完全地道"——大意对,但用词不是本地人最自然的表达方式。
情绪配音差距在缩小:哭戏、争吵场景的评分中,智马翻译情绪配音评分已接近人工配音演员评分,这是两年前AI配音无法达到的。
四、什么场景AI能替代人工
可以替代的场景:
- 批量走量出海(对翻译精度要求不是极致)
- 情绪配音已达到可用水平的标准情绪场景(喜怒哀乐主流情绪)
- 快节奏出海(时间约束下人工来不及的情况)
还需要人工的场景:
- 极度地道化要求(高端IP发行、大制作)
- 含有大量复杂文化梗(需要深度本地化改编而非翻译)
- 极细粒度情绪表演(如细腻心理刻画)
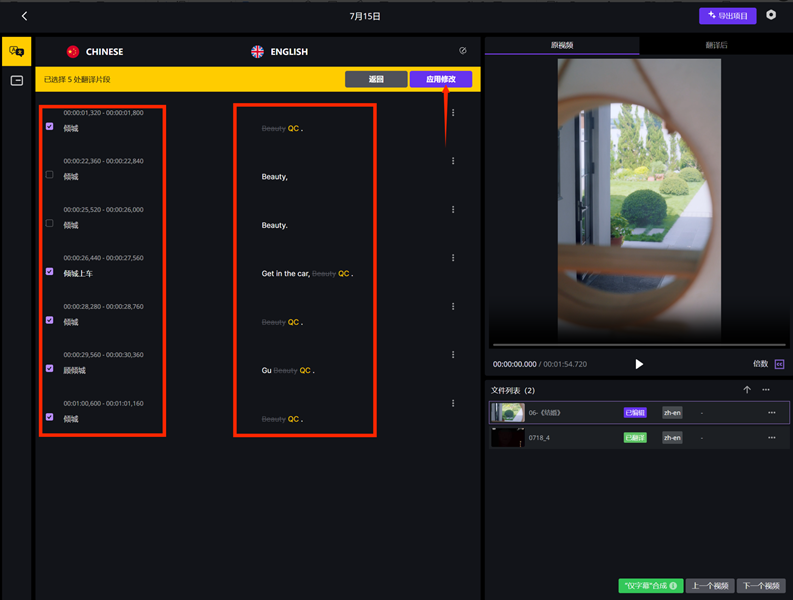
图3:查找替换结果预览——一键统一全剧同名词译法,消除AI翻译的一致性短板,使AI质量逼近人工水平
结论:2026年,高质量AI翻译(如智马翻译)在盲测中与专业人工的差距已大幅缩小,在主流场景下可达到接近专业级水平。差距集中在文化细节和极致本地化,而非翻译基本准确度。

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 6
 0
- 0


 已为社区贡献17条内容

所有评论(0)