豆包视频通话率先上线「全模态全双工」,AI终于能边看、边听、边说了
家人们,我发现最近豆包又变聪明了,之前只要有人说话别管是不是和它说话,它都回答,最近明显不会乱搭话了。
我一查,发现豆包的视频通话果然更新了。
这周末三伏天,热得我不想出门,晚饭吃啥成了世纪难题。
遇事不决问AI,老规矩,我点开了豆包视频通话让它给我推荐。
它一开始给我推荐做饭吃。我转头问了旁边的朋友想不想做饭,朋友说不想。
我又转回来跟豆包说:那我们点外卖吧。它就开始推荐外卖。
然后,我中间还和朋友商量豆包推荐的OK吗,全程也没耽误和豆包的对话,非常愉快地决定了晚饭。
整个过程我是两头切,一会儿跟朋友说话,一会儿跟豆包说话。
但是,豆包竟然全程只在我跟它说话的时候回应,我跟朋友聊的那几句,它一句都没搭话和插嘴。。。
要搁以前,你跟旁边人说一句你想做饭吗,它大概率已经开始教你做菜了。
豆包你果然是背着我偷偷进步了!这事儿勾起了我的好奇心,我又试了一下。
因为最近在纠结要不要出去旅游,我开着视频通话跟豆包聊。
我中间很几次说到一半停下来,在表达中也是各种乱停顿以及推翻。
它居然一直没有抢话,就等着我说完。
在我印象中,AI一般都是在你稍微停个两三秒,它就默认你说完了,顺着你的半句话就开始输出一堆你没问的东西。
这次好像开始能分的清楚,你是说完了,还是在思考,不该说话的时候学会了闭嘴,之前和AI语音聊天的人机味儿突然没有了。
为什么之前跟AI聊天总有一股人机味?
很多时候不是因为它说的内容不对,内容可能挺好的,推荐挺准的,回答挺全的。
但就是感觉不对。
AI的节奏不像人,因为在真实的人际沟通里,沉默、停顿不代表话说完了,其实是犹豫、思考,在组织接下来要说的内容。
真人之间的聊天,其实基本上一半靠说,一半靠不说。
AI的反应是该等的时候不等,不该接话的时候抢着接,就像跟一个完全不会看脸色的人聊天一样。
所以,豆包在闭嘴的时候,我甚至觉得它更聪明了。
学会闭嘴,还只是一半功力。
再比如,我家最近来了一只猫,新手养猫嘛,买了一堆东西,猫粮猫砂猫玩具堆了一桌子,我就开着豆包视频通话一边收拾一边归类。
我先告诉它分类规则:左边放玩具、梳子等非食品用品,右边放猫粮和零食。
接下来,我没有每拿起一样东西就问一句“这个应该放哪里”,而是按照我之前设定的规则连续整理。
在整理过程中,如果把某一件物品放到了错误的箱子时,豆包会主动开口,提醒我放错了位置:
不是你问我答,它一直在默默观察、判断,然后在它觉得你需要被提醒的时候才开口。
到这儿,我觉得它肯定升级了,但我还是试了一个更难的。
我让豆包陪我看一段视频,里面前前后后出现了好多人,三个核心人物 Papi 酱、罗翔和 LKS,以及路人甲乙丙丁。
这是一段播客,有几个人碰面打招呼场景,有三人正式的讨论对话,有露出的路人画面,场面挺乱的。
播放的同时,我不时向豆包提问,也会让它描述屏幕里的画面,区分多人场景中的声音、背景音:
它需要同时看懂画面、听清视频里的对话、分清谁说了什么,还得回应我的即时提问。
比如我问豆包,刚才Papi 酱、罗翔和 LKS分别说了什么,它能准确总结出来每个人的观点、以及画面发生了什么。
我问豆包画面里面有谁、穿黑色衣服的人是谁,它也能分辨出来。
再比如我问他背景音来自哪?它能告诉我是视频中的吹风机的声音,也就是它能同时做到边听、边看、边说。
这相当于同时给它出了好几道题:既要看懂画面、听清对话,分辨谁在说话,又要记住前后发生了什么,还得随时接住我的即时提问。
它既没有把视频里的人声误当成我在说话,也没有把几个人的观点张冠李戴。
◈新的底层模型—原生音视频多模态全双工大模型
有人可能会问,ChatGPT的语音模式不是早就做到了吗?
没错,GPT的实时语音是行业鼻祖,非常强,现在改成叫GPT-Live,可以在自己说话的时候同时继续听用户说话,判断是该继续听、暂停、回应还是调用工具,它的实时的体验感已经做的很好了。
但是OpenAI 官方明确写明:GPT-Live 首发时不支持视频和屏幕共享。
GPT-Live 目前主要是“音频全双工”,可以边听边说,但是不能边看。
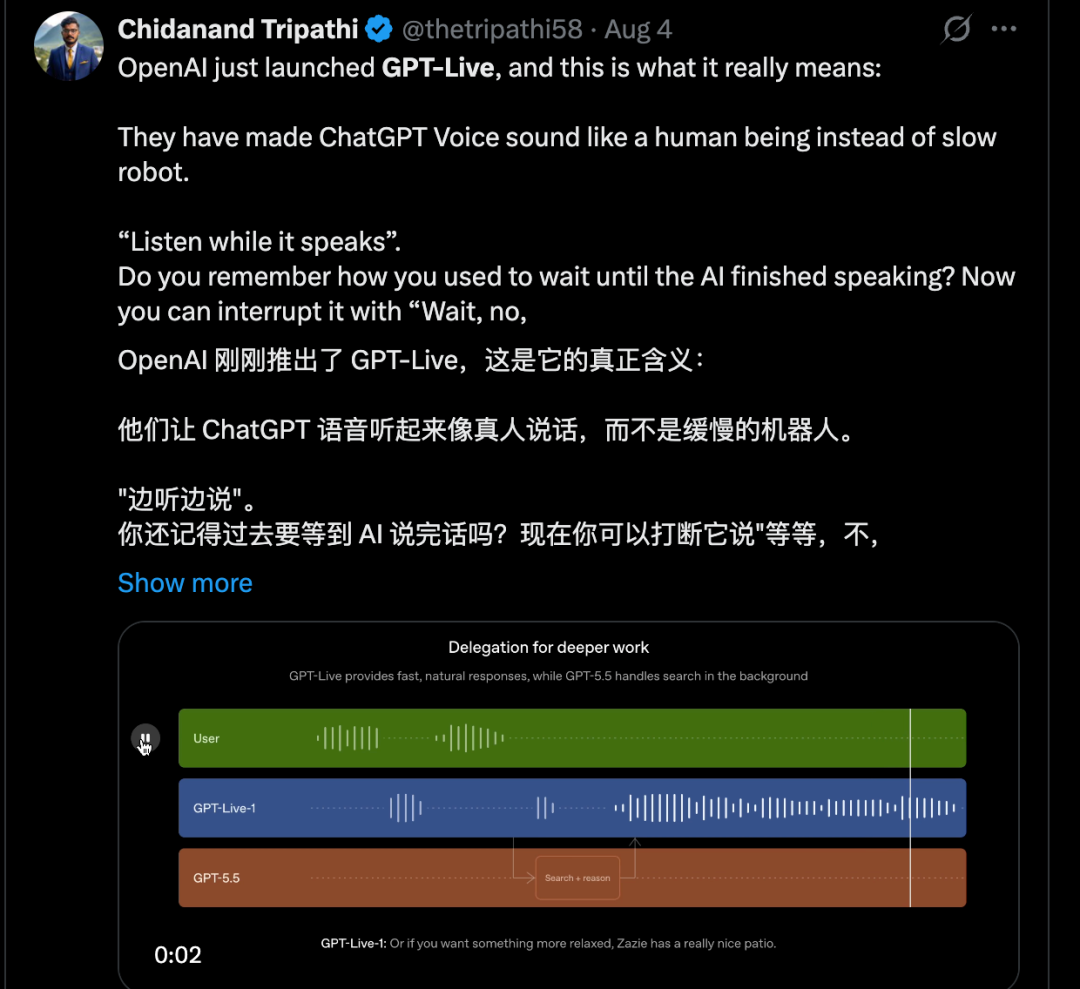
豆包这次把视频也接了进来,底座换了一个全新的底层模型,原生音视频全双工大模型—SeedRealtime。
模型传送门:
https://seed.bytedance.com/zh/seedrealtime
我前面说的这些体验背后的共同原因,其实就是这个模型。
放到整个行业里看,豆包这次升级的关键,是把“音视频全双工”做进了产品里。
不仅能边听边说,还能持续观察画面,在关键时刻主动提醒,多了“看”这一层。
「全模态」和「全双工」这两个词听起来有点技术,但对应到实际体验里,并不复杂。
你之前和AI视频通话,虽然屏幕一直开着,但不是一直能盯着屏幕的变化,交互方式依然很像对讲机,你问一句,它处理一句,它说话时,就不能看。
全模态和全双工的变化就是:在视频通话持续进行的过程中,画面、我的声音、旁边人的声音、环境中的背景音,都在不断进入模型。模型是一边看、一边听、一边判断,还可以同时开口回应。
这就是所谓的「全双工」,能同时处理视觉、听觉和语音,而且是实时的。
全双工真正难的地方,还不是让AI始终能听见、能看见。当它能听见、始终能看见以后,怎么知道哪些信息和自己有关。
比如,我转头和朋友说话,声音明明同样进入了手机,但豆包没有被带跑。
这个背后对应的是一种「交互指向性」能力:模型不只是识别一句话说了什么,还要结合说话人、面部朝向、视线、上下文和现场关系,判断这句话到底是不是说给它听的。
因为我发现我遮住镜头后,这项能力就没有了。
交互指向性在嘈杂环境里会更有用。
在车站、健身房或者会议现场,即便周围一直有人说话,AI也不会突然接话被带跑偏了。
我看到了一个官方的case,还是挺牛的:
即使在博物馆的多人嘈杂环境中,豆包依然能从混杂的人声中准确识别提问人的问题,并关联相应信息作出回答。。
而且,完全不需要等用户每次主动唤醒,不会答完一个问题就退出,它会持续保留对现场的观察和任务上下文。
行业里虽然都在往「全双工」上靠,比如OpenAI的GPT Live做了全双工,但还是音频层面的,能边听边说,但没有视觉,做不到边看边聊。Thinking Machines做的是全模态,但是还在研究阶段。
体验完以后,我觉得全模态全双工最重要的变化,是AI不该说话的时候学会了闭嘴,该说话的时候依旧能主动开口。
现在这个能力,就放进了一个普通人随手就能打开的视频通话产品里。
体验入口: 将豆包 App 更新至最新版本,在对话框内选择“打电话”,进入视频通话界面体验。

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)