同一段视频转码后 Hash 完全不同:系统如何证明它还是同一内容?
面向直播、OTT 与 Multi-CDN 的生产级音视频指纹系统设计
摘要
HTTP 200、正常播放和良好的 QoE,只能说明媒体能够被交付和解码,并不能说明用户看到的就是当前应该播出的节目。转码、缩放或重新封装会改变媒体对象的字节序列,因此精确哈希会随之改变;但解码后的音视频序列,仍然可能对应同一个预期事件。
本文讨论面向直播与 Multi-CDN 的生产级内容一致性子系统。它的主流程不是在全库中搜索“相似视频”,而是针对一个已知的预期事件,在明确的交付观测范围和允许的时间窗口内,对观测媒体流与可信参考序列执行 1:1 校验。要把这一能力真正用于生产,还需要视频/音频指纹、时间对齐、参考位置轨迹、同时感知时间与模态的策略、校准后的一致性分数、参考序列注册保护、成本感知采样,以及指纹证据与平台最终决策之间的严格边界。
这种系统给出的不是密码学意义上的证明,而是范围明确、时间受限且经过校准的内容一致性证据;其错误特征只在指定测试集(corpus)、工作点和已验证的变换范围内成立。
关键词: 视频指纹、音频指纹、MPEG-7、FFmpeg、直播内容一致性、Multi-CDN、错播检测、时间对齐、内容完整性
这是“生产级视频分发实践”系列的第八篇。上一篇文章把内容验证系统定义为独立的验证与控制平面;本文只深入其中一个组件:视频/音频指纹引擎。
本文的中心结论是:
指纹子系统生成的是范围明确、时间受限且经过校准的内容一致性证据;最终判定、根因归属和生产动作仍由验证与控制平面负责。
1. HTTP 200、QoE 良好,为什么仍然可能播错节目?
假设根据排期和预期状态,某个频道当前应该播放直播事件 E42。
平台从三条 CDN 交付路径得到以下观测:
| 观测 | 传输 | 播放 / QoE | 内容一致性 |
|---|---|---|---|
| Path A | HTTP 200 | 播放正常 | 观测媒体流与 E42 一致 |
| Path B | HTTP 200 | QoE 甚至优于 Path A | 观测媒体流与 E42 不一致 |
| Path C | 探针没有取得可用样本 | 未知 | 未完成一致性评估 |
在传统 CDN 监控面板上,Path B 可能看起来完全健康:
- 分片下载成功;
- 解码器没有报错;
- 没有发生卡顿;
- 吞吐量充足;
- 延迟甚至低于备用路径。
但用户实际看到的,可能是上一场节目、错误的区域信号源、故障切换后的旧内容循环,或者由错误源站映射产生的媒体流。
一个探针不能代表整个 CDN
即使已经确认发生 MISMATCH,正确的表述也应该是:
在特定交付观测范围和实际覆盖到的媒体区间内,观测媒体流与预期事件不一致。
交付观测范围必须显式记录:
delivery_scope_key = {
    tenant,
    channel,

    CDN delivery path,
    steering profile,
    resolver context,

    probe geography,
    probe network / ASN,

    resolved endpoint / POP / cache cohort,
    if observable,

    manifest variant,
    rendition,
    audio / ad policy
}
证据记录还必须包含实际覆盖到的媒体区间和采样时间。
这不等于“整个 CDN B 都在返回错误内容”。
即使两个探针位于同一城市,只要它们属于不同 ASN,也可能获得不同的 DNS 解析结果,进入不同的 POP、缓存群组或上游路由。
观测结果不等于根因归属
错误内容可能出现在:
- CDN 缓存;
- 流量调度;
- 转码器;
- 封装器;
- 源站映射;
- Origin Shield / 中间回源层;
- SSAI;
- 区域化处理;
- 参考链路;
- 探针本身。
指纹子系统只能形成关于观测媒体流是否与预期参考序列一致的证据,不能自动说明是哪一个组件制造了这个错误。
为什么不能只比较 SHA-256?
同一个源事件可以形成多种交付表示,例如 H.264 1080p / MPEG-TS、HEVC 720p / CMAF 和 AV1 1080p / CMAF。它们会形成不同的字节对象,因此精确哈希也不同。
这不是 SHA-256 的缺陷。
FIPS 180-4 将安全哈希定义为对消息计算摘要的机制;消息发生变化时,摘要也应随之变化。因此 SHA-256 正确回答的是:
两个对象的字节序列是否完全一致?[1]
但它不能回答另一个问题:
在允许的媒体变换之后,解码得到的媒体序列是否仍然对应当前预期事件?
转码会改变编码载荷。重新复用或重新封装即使保留了相当一部分基本流载荷,也可能改变封装对象的结构、时间戳、元数据或分片边界,因此精确对象哈希仍然会变化。
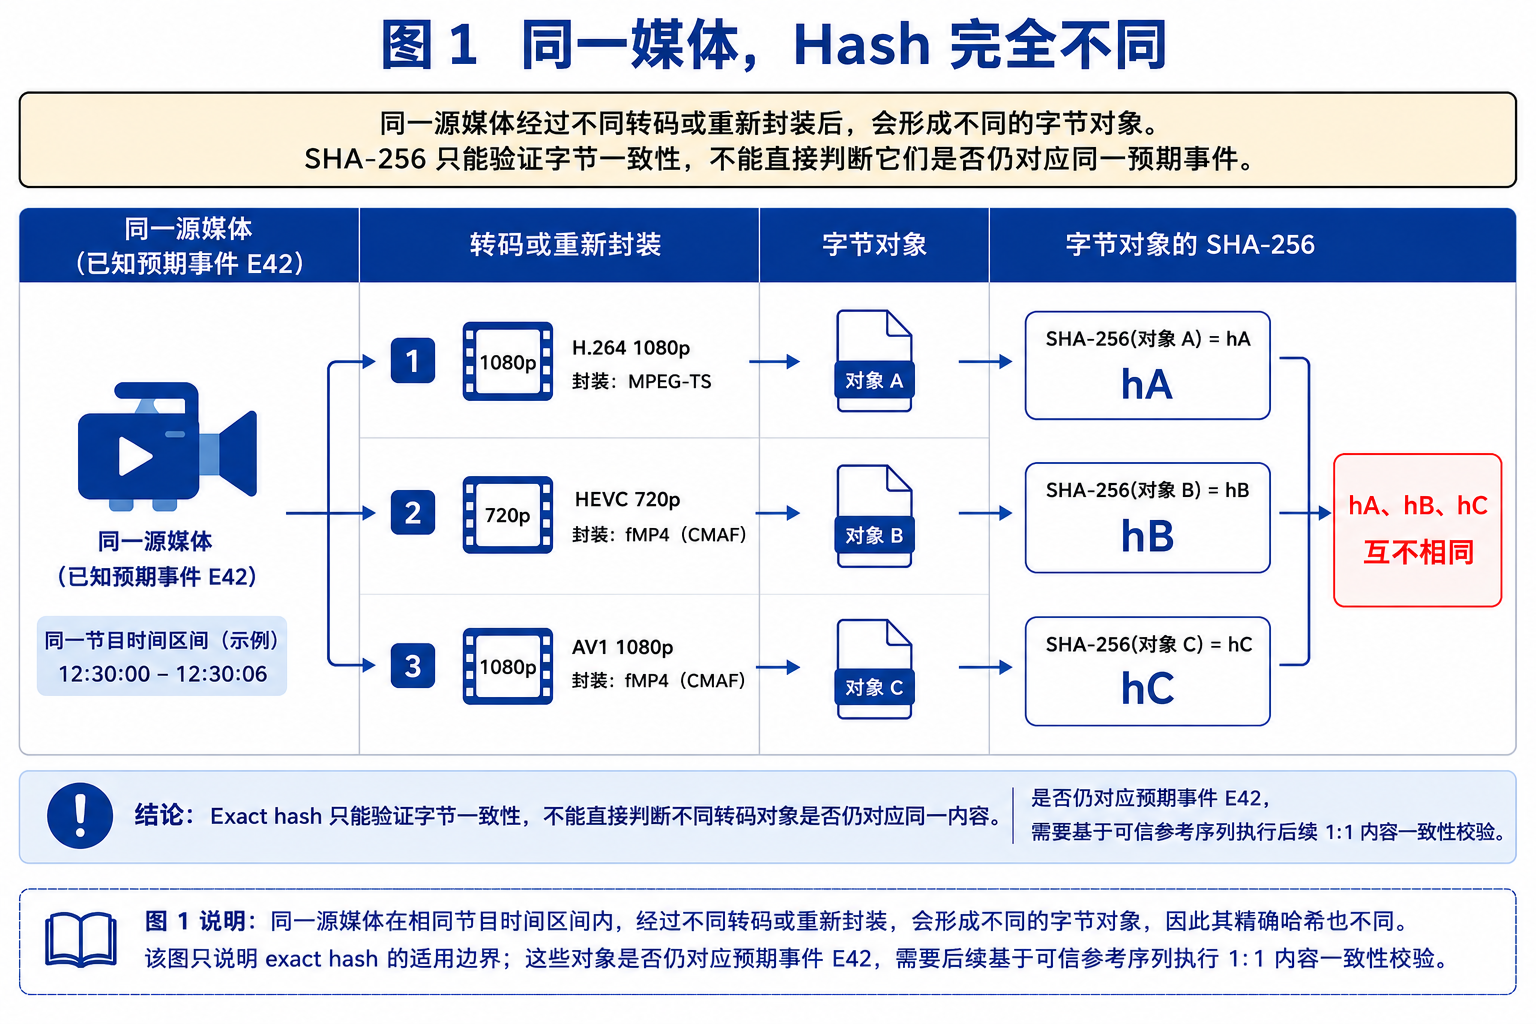
因此,本文的核心问题可以更准确地表述为:
对于一个已知的预期直播事件,系统如何验证:经过转码、封装和传输延迟后,通过特定交付观测范围取得的媒体序列,是否在允许的时间窗口内对应可信参考序列?
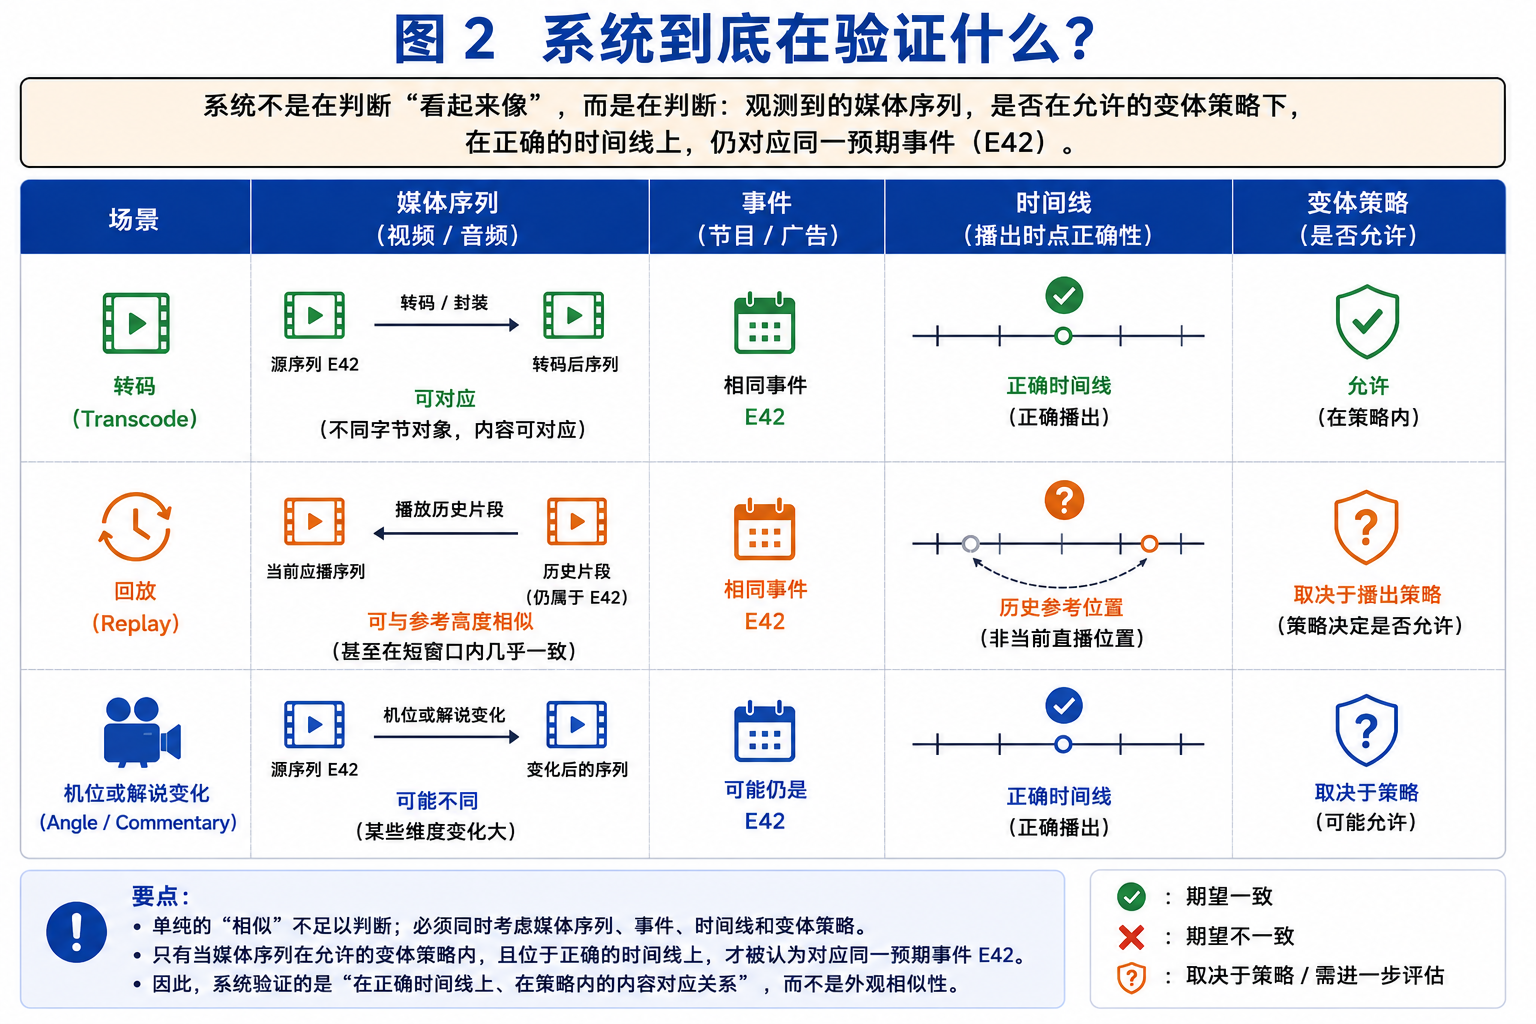
2. 系统说“同一内容”时,究竟在验证什么?
内容一致性不能被画成 Byte → Object → Rendition → Programme → Event → Semantic 这样的线性阶梯。
这些概念并不是层层包含的等级,而是彼此独立的架构维度;它们可能同时一致,也可能分别发生偏差。
独立的校验维度
| 维度 | 需要回答的问题 |
|---|---|
| 字节/对象关系 | 字节序列或权威对象版本是否完全一致? |
| 视频序列关系 | 在允许的变换之后,观测到的解码视频是否对应参考视频? |
| 音频序列关系 | 观测音频是否对应预期音频参考及其音轨角色? |
| 预期节目归属 | 当前媒体是否属于应该播出的节目或直播事件? |
| 播出时点正确性 | 当前播放的是否是该事件时间线上的正确位置? |
| 音轨/区域/变体策略 | 当前音轨、区域版本、广告替换和个性化决策是否被允许? |
几个典型场景:
| 场景 | 媒体序列 | 事件 | 时间线 | 变体策略 |
|---|---|---|---|---|
| H.264 1080p → HEVC 720p | 在允许的变换后,音视频可以对应 | 相同 | 相同位置 | 合法转码版本 |
| 进球回放 | 片段几乎可以完全匹配 | 仍是同一场比赛 | 不是当前直播位置 | 取决于播出意图 |
| 另一机位 | 视觉序列不同 | 可能仍是同一事件 | 同一直播时点 | 取决于制作策略 |
| 另一条解说音轨 | 视频一致、音频不同 | 相同 | 相同位置 | 必须由音轨策略显式允许 |
回放是最重要的例子之一。
指纹可以准确识别某个片段,但高相似度并不能回答:
这个片段此刻是否应该出现在直播时间线上?
因此,播出时点正确性不能被压缩成一个视觉相似度,也不能只看 event_id。
内容一致性契约
本文中的**内容一致性契约(Content Identity Contract)**是一个架构术语,不是某个行业标准的正式名称。
它应该定义:
- 当前期望哪个事件;
- 需要验证哪些视频/音频关系;
- 哪些媒体变换被允许;
- 哪些区域、音轨和广告变体合法;
- 哪一段参考时间区间有效;
- 多大的直播延迟属于正常范围;
- 当前证据覆盖哪个交付观测范围;
- 哪些情况应输出
MISMATCH; - 哪些情况必须保留为
AMBIGUOUS; - 当可信预期不存在时,哪些区间根本无法评估媒体一致性。
算法本身无法决定:
- 另一机位是否允许;
- 另一条解说音轨是否合法;
- 区域广告是不是授权替换;
- 回放是否符合当前播出意图;
- 紧急图文覆盖是否可以忽略;
- 某个会话此刻究竟应该收到哪条个性化广告。
这些都属于平台的产品、编辑和安全策略,而不是描述子本身能够决定的属性。
主流程:1:1 校验
如果预期状态已经给出 expected_event = E42,主问题就是:
观测媒体流是否对应可信参考
E42?
可以把接口抽象为:
verify(
    observed_media,
    expected_identity_policy,
    delivery_scope_key,
    actual_covered_intervals
)
局部一致性结果包括相对于 E42 的 MATCH、相对于 E42 的 MISMATCH、AMBIGUOUS 和 NOT_EVALUATED。
但“相对于 E42 的 MISMATCH”,并不等于已经识别出观测媒体流就是 E41。
1:N 识别是独立的诊断流程
如果系统希望判断观测媒体流是否更接近 E41,就必须启动另一条流程:
identify(
    observed_media,
    candidate_registry = {E41, E40, E39, ...}
)
它返回:
- 排序后的诊断候选;
- 第一候选与第二候选分差;
- 各候选的参考位置;
- 各候选的时间轨迹;
- 诊断分数。
1:N 识别需要单独评估:
- 候选数量;
- 虚警预算;
- 阈值;
- 索引要求;
- 延迟;
- 成本;
- 攻击面。
正确的生产流程是:先对预期 E42 执行 1:1 校验;只有校验失败且确有诊断价值时,才启动可选的 1:N 识别。
ANN 或向量索引可以帮助第二条流程做候选检索,但它们没有权定义当前应该播放哪个事件。
当预期事件已知时,通常没有必要在整个注册库上做全局搜索。
回到 Path B:1:1 校验失败只能说明它不符合预期 E42;在启动 1:N 诊断之前,系统还不知道实际播放的是什么。
预期策略必须同时感知时间与模态
不能把主节目视频、区域广告 A、区域广告 B 和中文音轨放进一个扁平集合中。
它们属于不同的匹配域,也受不同策略约束。
可执行的策略模型必须保留时间区间、视频变体和允许音频参考之间的绑定关系:
ExpectedIdentityPolicy {
    event_id
    identity_policy_version

    intervals[] {
        interval_id
        valid_from
        valid_to
        reference_time_base

        allowed_variants[] {
            variant_id

            video_reference {
                reference_id
                reference_version
            }

            allowed_audio_references[] {
                reference_id
                reference_version
                track_role
            }

            region_scope
            rights_scope
        }

        ad_policy
        timeline_rules
    }
}
全局进行版本管理的是 identity_policy_version。每一条参考序列的版本都必须跟随具体参考序列保存,而不能只在事件层放一个统一版本。
轨迹子系统再根据当前生效的策略与参考序列,形成独立的 reference_set_version,例如为当前生效的参考绑定生成版本号或哈希。
SSAI 的三种生产模式
对于服务端广告插入,可以有三种模式。
1. SSAI 控制平面提供可信的广告素材决策
流程是:预期广告素材 ID → 对应的视频/音频参考序列 → 普通 1:1 校验。
2. 验证器不知道具体广告素材,但知道广告时段
此时系统可以检查:
- 广告时段是否按计划发生;
- 插播前的节目连续性;
- 插播后是否回到正确的参考位置;
- 是否越过允许的广告时段边界。
但系统不能宣称广告内容本身已被验证。
3. 完全没有可信预期
该区间应得到 evaluation_status = NO_REFERENCE 和 identity_result = NOT_EVALUATED。
它不会因为播放正常就自动成为 MATCH。
策略预期与已验证的算法范围
| 变换 | 策略预期 | 实现必须验证的范围 |
|---|---|---|
| 码率变化 | 内容关系保持 | 完整的生产码率梯度 |
| H.264 → HEVC / AV1 | 内容关系保持 | 实际转码处理链路 |
| 分辨率变化 | 内容关系保持 | 平台使用的缩放比例 |
| TS → CMAF 重新封装 | 媒体关系保持 | 比较解码后的媒体,而不是封装对象哈希 |
| GOP / 分片边界变化 | 内容关系保持 | 与封装边界解耦 |
| 小型台标 / 字幕 | 通常保持 | 大小、位置与持续时间 |
| 裁剪 / 宽高比转换 | 条件性保持 | 自有变换测试集 |
| 大面积覆盖 | 条件性保持 | 需要音频和相邻窗口辅助 |
| 丢包 / 丢帧 | 条件性保持 | 覆盖率、缺口和解码器行为 |
| 另一条解说音轨 | 由策略决定 | 按音轨角色区分的音频评估 |
| 合法区域广告 | 仅在指定时间区间内允许 | 可信的变体决策 |
| 错误区域信号源 | 不允许 | 在困难负样本上的误匹配率 |
| 未授权插入 | 不允许 | 时间定位能力 |
| 回放 / 循环 | 片段可能匹配 | 轨迹必须识别错误播出时点 |
| 跨租户媒体 | 不允许 | 匹配前先按租户隔离 |
这张表不是任何指纹算法的鲁棒性承诺。它描述的是平台要求,实现必须通过实验验证自己的实际能力范围。
3. 指纹测量了什么,又不能回答什么?
感知指纹经常被称为“模糊 Hash”。这个比喻很方便,但并不准确。
密码学哈希会对字节序列的变化作出强响应;感知指纹则被设计为:在预先定义的一组媒体变换下,仍然保持可比性。
但指纹本身不会直接给出平台最终判定。
结果分为四层
| 层级 | 包含的内容 |
|---|---|
| 原始测量值 | 视频相似度、音频相似度、描述子匹配结果 |
| 序列与对齐元数据 | 参考位置、偏移、已对齐时长、缺口、漂移 |
| 校准后的一致性分数 | 在带标注的数据集上建立、并与版本绑定的原始证据解释 |
| 局部一致性结果 | 相对于预期策略的 MATCH、MISMATCH 或 AMBIGUOUS |
对于 calibrated_identity_score,数值越高,表示证据越支持预期参考序列。分数范围与解释方式必须与校准器版本绑定;不同算法或不同版本之间,不要求使用相同的数值区间。
因此必须区分:指纹不等于检测器,嵌入不等于一致性证据,相似度也不等于平台最终判定。
Deepfake 检测器回答的是:媒体中是否存在某类合成或篡改特征。
学习型嵌入(learned embedding)测量的是对象在特征空间中的距离或接近程度。
指纹机制校验的是:在给定不变性约束下,媒体序列是否对应某个参考序列。
这些机制中的任何一个,都不能单独决定平台是否有权把当前交付状态判定为正确。
MPEG-7 Video Signature:一个标准化基线
MPEG-7 Video Signature 作为 Video Signature Tools,被标准化在 ISO/IEC 15938-3:2002/Amd 4:2010 中。它面向“同一视频或经过修改的视频内容识别”,而不是通用语义相似度。[2]
它不是对整个文件只计算一个 Hash。MPEG 的官方描述包含:
- 密集帧级表示(dense frame-level representation);
- 稀疏片段级表示(sparse segment-level representation);
- 多阶段匹配(multi-stage matching);
- 时间定位(temporal localization)。
在 MPEG 评测数据集上,Video Signature 的总体成功率约为 95.49%,虚警率低于 每百万次比较 5 次。作者的同行评审论文给出了接近的结果:检出率约 96%,误匹配约为每百万次比较 5 次。[3][4]
这些结果说明:在给定基准测试范围内,鲁棒内容识别是可以实现的。 但它们不是某个直播/CDN 平台的生产 SLA。
不能写成:
MPEG-7 能让我们的生产系统达到 96% 准确率。
原因包括:
- 基准测试集与具体平台的媒体分布不同;
- 评测变换集合并不覆盖现代 ABR/CDN 处理链路的全部变化;
- 单次比较中的虚警不等于整个服务的错误事件判定;
- 1:1 校验与 1:N 识别面对的候选规模不同;
- SSAI、区域变体和直播时间线需要平台自己的策略;
- 工作点必须在自有测试集上重新测量。
即使单次比较的虚警率很低,在全库搜索中也可能产生大量错误候选。
因此应该先收缩候选范围:
tenant
→ channel
→ region
→ expected event
→ reference interval
→ identity policy version
→ compatible fingerprint version
→ direct verification
FFmpeg signature:实用基线,但不是生产服务
FFmpeg 提供 signature 滤镜,可以计算 MPEG-7 Video Signature,也支持对多个视频输入进行比对。
生成 XML 指纹文件:
ffmpeg -i input.mkv \
  -vf "signature=format=xml:filename=signature.xml" \
  -map 0:v -f null -
双输入比对:
ffmpeg -i input1.mkv -i input2.mkv \
  -filter_complex \
  "[0:v][1:v]signature=nb_inputs=2:detectmode=full:format=xml:filename=signature%d.xml" \
  -map :v -f null -
format=xml 必须显式指定,因为默认输出格式是二进制。[5]
这个滤镜很适合用于:
- 原型验证;
- 可复现的确定性基线;
- 变换实验;
- 构建校准数据集;
- 与其他描述子对比;
- 可行性检查。
但 FFmpeg 滤镜本身不会提供:
- 可信参考序列注册;
- 感知时间的预期策略;
- 版本化注册库;
- 租户隔离;
- 交付观测范围模型;
- 轨迹状态;
- 校准;
- 歧义处理;
- 安全的控制平面集成。
生产架构不能被简化为:FFmpeg signature → 一个阈值 → 关闭 CDN。
为什么还需要音频指纹?
经过缩放、强压缩、台标、字幕、下三分之一字幕条、局部覆盖或色彩转换之后,视觉表示可能明显变化;但节目音频仍然可能和参考序列保持对应。
系统可能得到这样的组合:视频证据为 AMBIGUOUS,音频证据较强,同时估算出的时间偏移保持稳定。
基于时频地标的音频指纹使用稀疏时频特征,可以同时帮助候选匹配和估算时间偏移。Avery Wang 的经典工作描述了这种方法对噪声、失真和查询片段时间位置的鲁棒性。[6]
但音频优先路径不是通用方案。
在以下场景中,它可能缺乏信息量:
- 静音;
- 配音音轨;
- 另一条解说;
- 无障碍音频描述;
- 区域音频替换;
- 单独被替换的音频;
- 稳定地标数量不足的内容。
更准确的表述是:
当预期音轨已知、被策略允许,并且对所选算法足够有区分度时,音频可以作为成本相对较低的粗对齐信号。
音频和视频是两类运行信号,但未必统计独立:它们可能来自同一信号源,也可能共享同一故障域。
4. 如何设计带有交付观测范围的生产级指纹架构?
最重要的边界,不在算法 A 和算法 B 之间,而在参考链路与观测链路之间。
两条链路必须在权威来源和数据路径上相互独立,避免同一故障同时污染实际输出和参考序列。
与此同时,提取器与归一化版本必须兼容。所谓“链路独立”,并不意味着两边必须使用不同的指纹算法。
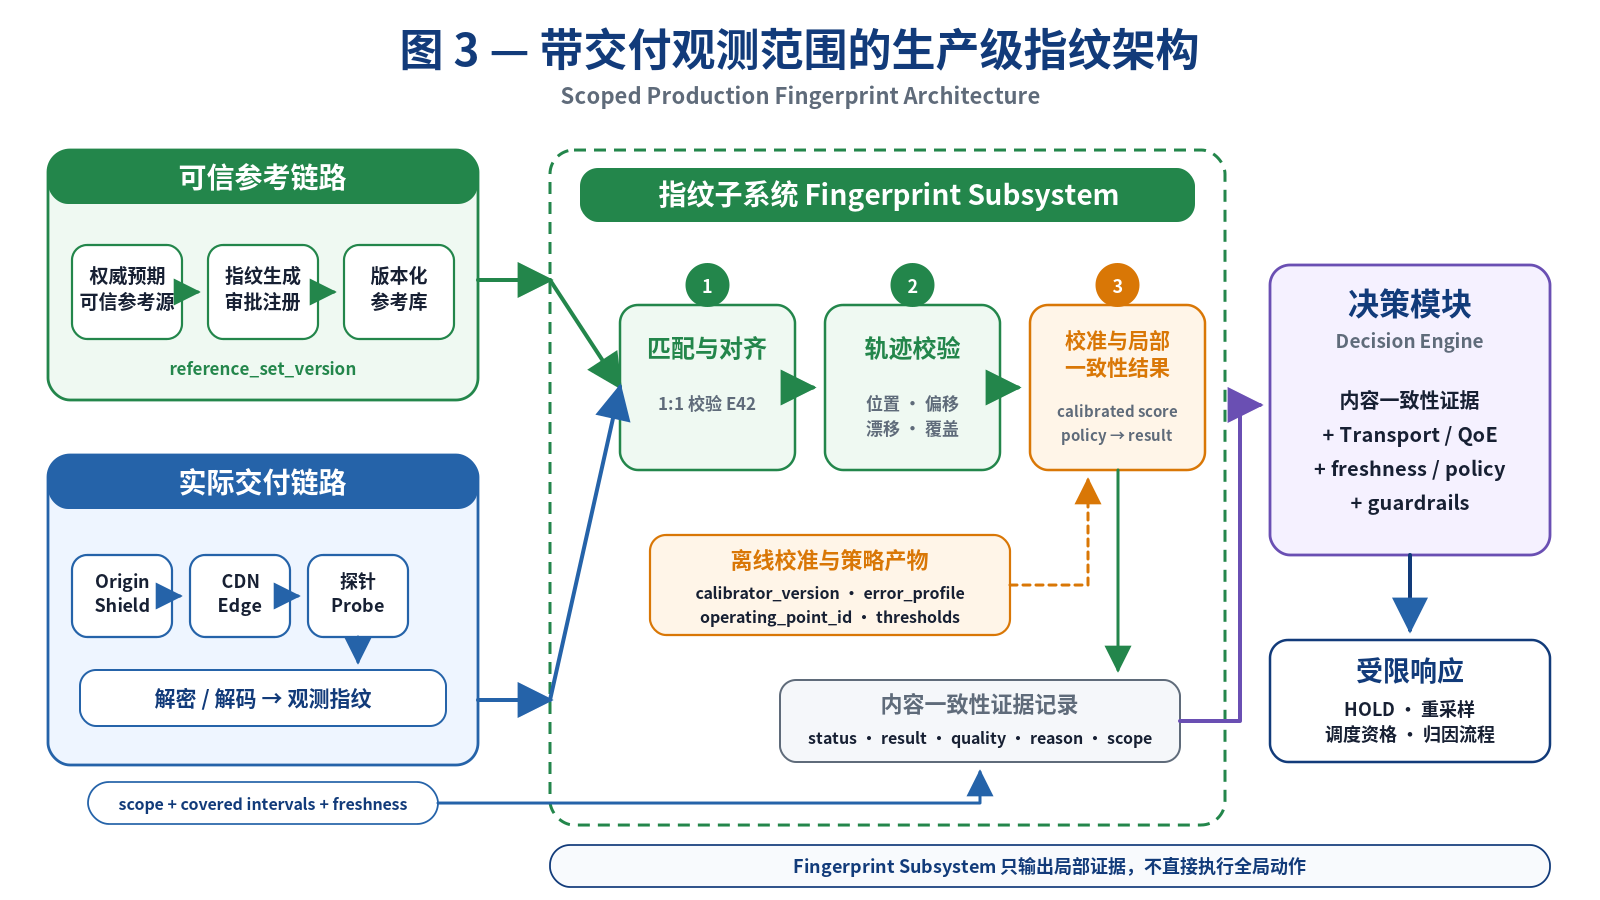
探针位置决定证据覆盖什么
源站侧探针最多只能形成以下证据:
当前源站输出与参考序列一致。
但它看不到:
- 边缘旧对象;
- 缓存键冲突;
- 错误缓存群组;
- CDN 特定转码故障;
- 错误区域路由;
- 清单个性化错误;
- 错误广告插入;
- 只影响某个 ASN 的问题;
- Origin Shield 之后出现的错误内容。
观测媒体流必须从待验证信任边界之后的位置取得。
如果探针位于 CDN 之前,那么即使 Path B 的边缘节点持续播放旧节目,这个错误也不会进入观测链路;验证器最多只能看到源站输出正常。
DRM 与明文媒体观测点(clear-media tap)是安全边界
验证器必须在待验证信任边界之后获得解码后的媒体。
不同的观测位置覆盖不同的信任边界。
位于 CDN 之前的明文媒体观测点
它可以形成关于采集、转码或源站侧媒体表示的证据,但无法覆盖 CDN 边缘交付是否正确。
CDN 之后、具备授权解密能力的探针
它可以验证真实交付路径,但需要:
- 许可证访问权限;
- 密钥隔离;
- 安全解码器;
- 最小权限;
- 对明文媒体留存的严格限制;
- 禁止明文帧进入普通日志和指标系统;
- 独立审计链。
播放器侧安全观测
它覆盖更大的范围:
CDN
+ network
+ client application
+ device / DRM stack
但此时证据记录还必须包含客户端版本、设备类型、DRM 实现和网络群组。
因此,观测点越靠近用户端,覆盖的交付链路越完整,安全模型也越复杂。
注册库应该保存什么?
参考注册库不是一张只保存指纹数据的表。
最小记录至少包括:
tenant_id
channel_id

programme_id
event_id

reference_id
reference_version
reference_interval

reference_time_base
clock_mapping_version
media_timeline_epoch

region_scope
rights_scope
audio_track_role

identity_policy_version
fingerprint_algorithm
fingerprint_version
normalization_version

source_lineage
enrollment_method
approval_record

created_at
valid_from
valid_to
reference_quality
parent_reference_id
其中尤其重要的是:reference_interval、reference_time_base、clock_mapping_version、media_timeline_epoch、identity_policy_version、enrollment_method 和 approval_record。
缺少这些字段时,匹配器可能识别出正确片段,却无法判断该片段此刻是否应该出现在直播时间线上。
参考序列污染
如果参考序列本身来自错误事件,再精确的匹配器也没有意义。
危险架构:
Current Production Origin
        ↓
Reference Generator
        ↓
Same Production Delivery
        ↓
Matcher
如果控制平面同时把 E41 错误地送入源站和参考指纹生成器:
wrong reference E41
==
wrong observed E41
→
false MATCH
参考架构必须明确回答:
- 谁定义预期事件;
- 哪个来源具有权威性;
- 谁可以生成指纹;
- 谁可以批准参考序列注册;
- 参考序列如何绑定到时间线;
- 如何发现过期和重复记录;
- 租户如何隔离;
- 版本迁移如何执行。
必须保持一个硬性不变量:
实际交付流绝不能自动升级为可信参考序列。
即使某个生产输出长期稳定,在独立权威方批准其注册之前,它仍然只是观测结果。
5. 同一内容晚了五秒:如何验证时间线连续性?
不同直播交付路径几乎不可能完全同步:
Reference path    +0 s
Delivery path A   +2 s
Delivery path B   +5 s
Delivery path C   +8 s
如果直接比较 Reference[t] 与 Observed[t],系统很容易误判为 MISMATCH。正确问题应该是:在允许的直播延迟范围内,是否存在一个偏移 Δt,使 Observed(t) ≈ Reference(t − Δt)?
首先必须明确时间基准
单独看到 12:30:20 并没有明确含义。它可能表示:
- 采集墙上时钟时间;
- HLS
EXT-X-PROGRAM-DATE-TIME; - 媒体 PTS;
- 归一化后的事件相对节目时间;
- 参考时间线中的位置。
证据结构必须把这些坐标分开:
capture_wall_clock_interval

observed_media_pts_interval
observed_program_time_interval

matched_reference_interval
reference_time_base

clock_mapping_version
estimated_offset
例如:
capture wall clock:
2026-08-26T09:30:20Z

observed programme time:
12:30:20

matched reference programme time:
12:30:15

estimated media offset:
+5.1 s
estimated_offset 只有在时间基准与映射版本都明确时才有意义。
固定偏移
对于稳定的直播延迟,有界偏移搜索通常已经足够。
候选偏移可以通过以下方式得到:
- 滑动窗口比较;
- 广义互相关;
- 音频地标偏移投票;
- 视频序列匹配。
广义互相关是经典的时间延迟估计方法。[7]
丢帧、插入与漂移
当观测中出现丢帧、短缺口、广告拼接或临时损坏时,一个固定偏移可能不再足够。
系统还需要评估:
- 已对齐时长;
- 缺口位置;
- 缺口比例;
- 局部不连续;
- 覆盖率;
- 参考位置连续性。
对于非线性时间变化,可以使用受约束动态时间规整(DTW)或其他序列对齐方法。[8] 工程上还需要防止重复片段造成不合理对齐;这不是经典方法自动提供的保证,必须通过限制搜索窗口、约束允许的时间形变,并使用平台自己的困难负样本进行验证。若有界偏移搜索已经能解决明确的直播场景,就不应默认启用完整 DTW。
一个匹配窗口不足以确认直播连续性
对每一个采样窗口,系统至少要记录:
capture_wall_clock_interval
actual_covered_media_interval

matched_reference_interval
estimated_offset

video_similarity
audio_similarity

aligned_duration
gap_ratio
media_timeline_epoch
tracker_state_generation
正常的延迟连续性可能表现为:
Capture wall clock 09:30:20Z
Observed programme time 12:30:20
→ Reference programme time 12:30:15
offset +5.1 s

Capture wall clock 09:30:30Z
Observed programme time 12:30:30
→ Reference programme time 12:30:25
offset +5.0 s

Capture wall clock 09:30:40Z
Observed programme time 12:30:40
→ Reference programme time 12:30:35
offset +5.2 s
这里:
- 参考位置单调前进;
- 偏移基本稳定;
- 漂移位于策略允许范围内;
- 覆盖率足够。
冻结循环可能是:
Observed 12:30:20 → Reference 12:10:15
Observed 12:30:30 → Reference 12:10:15
Observed 12:30:40 → Reference 12:10:15
单窗口相似度可能很高,但参考位置完全没有前进。
持续前进的旧回放可能是:
Observed 12:30:20 → Reference 12:10:15
Observed 12:30:30 → Reference 12:10:25
Observed 12:30:40 → Reference 12:10:35
序列本身在前进,但偏移接近二十分钟,已经超出允许的直播延迟范围。
因此生产证据必须检查:
reference-position monotonicity
offset stability
maximum allowed lag
drift
gaps
coverage
直播正确性不只是媒体匹配,还包括沿参考时间线正确前进。
回到 Path B:即使某个采样窗口与参考片段高度相似,参考位置轨迹仍可能揭示它正在播放二十分钟前的旧内容。
媒体时间线与验证器状态是两种不同状态
不能用一个统一的 epoch 字段同时表示媒体不连续和验证器工作进程重启。
需要两个字段。
媒体时间线分段(media_timeline_epoch)
它在媒体时间戳域被改变或重新定义时更新,例如:
- PTS reset;
- HLS 不连续边界;
- DASH Period 边界;
- 编码器时间线重启。
RFC 8216 中的 EXT-X-DISCONTINUITY-SEQUENCE 用于在不同转码版本与变体流之间同步不连续信息。它表示时间戳映射边界,而不是事件归属自动发生变化。[9]
跟踪器状态代次(tracker_state_generation)
它在验证器丢失或主动重置参考位置轨迹历史时更新,例如:
- 工作进程重启;
- 状态存储丢失;
- 状态结构迁移;
- 人工重置;
- 无法恢复之前的状态。
交付路径变化已经会改变 delivery_scope_key,因此不必自动改变 media_timeline_epoch。
参考集合更新改变的是 reference_set_version,而不是媒体时间戳域。
完整的轨迹状态键:
trajectory_key = {
    event_id,
    identity_policy_version,
    delivery_scope_key,

    media_timeline_epoch,
    reference_set_version,
    tracker_state_generation
}
只有在同一个键内,相邻采样窗口才能被解释为一条连续轨迹。
工作进程冷启动后,第一个窗口可能足以支持局部媒体对应,但还不足以确认时间线连续性:
evaluation_status = OK
identity_result   = AMBIGUOUS
evidence_quality  = INSUFFICIENT
reason_code       = TRAJECTORY_WARMUP
稀疏采样会限制可声明的范围
假设验证器请求检查 12:30:00–12:30:30,但实际只获得 12:30:00–12:30:06,那么 12:30:06–12:30:30 仍然是未采样间隔。
证据记录必须保存:
requested_observation_interval
actual_covered_intervals[]
coverage_ratio

captured_at
evidence_age
sampling_mode
必须遵守:
MATCH只适用于实际覆盖的媒体区间。未采样区间不能被自动视为已经验证。
在“每 30 秒采 6 秒”的模式下,一个五秒钟的短暂替换完全可能落在两个采样窗口之间。
因此采样策略必须明确:
- 覆盖率;
- 最长未采样间隔;
- 最大证据时效;
- 预期检测延迟;
- 对短时事故的检测假设。
6. 从原始测量值到校准后的一致性证据
危险的实现方式是把 similarity > 0.8 直接转换成 MATCH。
如果没有校准,这个数字并不能告诉系统:
- 误匹配率;
- 漏匹配率;
- 内容类型的影响;
- 查询时长的影响;
- 候选数量的影响;
- 参考质量的影响;
- 时间覆盖率的影响;
- 算法版本的影响。
校准与运行策略是两个不同步骤
正确流程:
Raw Measurements
+
Trusted Context
        ↓
Calibration Model
        ↓
Calibrated Identity Score
        ↓
Operating Policy
        ↓
Local Identity Result
校准器的输入可以包括:
video similarity
audio similarity

alignment stability
offset trajectory

aligned duration
gap ratio
coverage ratio

content class
reference quality
algorithm version
输出是 calibrated_identity_score。
除非系统另外完成了概率校准,否则不应把它称为概率。
运行策略再综合:
calibrated identity score
base rate
risk tier
cost of false match
cost of false non-match
minimum evidence quality
形成局部一致性结果。
DET 曲线描述阈值变化时漏检与虚警之间的权衡;NIST Speaker Recognition Evaluation 还使用包含错误成本与目标先验概率的检测成本。因此工作点属于决策策略,而不是原始匹配器输出或校准器本身。[10][11]
正向变换测试集
正样本集应包含内容一致性契约允许的变换:
same trusted source
× production codecs
× production bitrates
× production resolutions
× GOP variants
× TS / fMP4 / CMAF
× expected frame-rate conversions
× permitted overlays
× realistic packet / frame loss
× real delivery offsets
× authorised regional / audio variants
困难负样本
随机选择完全无关的视频并不够。
真正危险的是那些可能欺骗生产匹配器的样本:
adjacent programme
same studio
same presenter
repeated intro
commercial block
sports replay
previous-day broadcast
wrong regional feed
weather / static camera
black or slate frames
same venue, different event
unauthorised splice
训练、调参与测试集应按节目、事件和时间区间划分,而不是随机打散相邻帧。否则时间泄漏会让结果显著偏高。
1:1 校验与 1:N 识别必须分别校准
在 1:1 校验中,系统只把观测媒体流与预期 E42 比较。
在 1:N 识别中,系统会执行大量比较。
因此,单次比较的虚警率不等于整个服务的错误事件判定率。
1:N 模式的风险还取决于:
- 候选数量;
- 候选收缩策略;
- 基础发生率;
- top-1 / top-2 margin;
- 查询时长;
- 时间一致性。
为直接 1:1 校验选择的阈值,不能直接复制到全库识别。
版本上线
新的指纹版本或归一化版本会改变分数分布。
上线过程应当经历:
shadow generation
→ dual comparison
→ distribution analysis
→ recalibration
→ controlled activation
不能因为新提取器仍然输出一个数字,就继续使用旧阈值。
评估结果必须拆成多个字段
一个枚举值不应同时承载比对结果、可用性和证据质量。
evaluation_status =
    OK
    NO_SAMPLE
    NO_REFERENCE
    VERSION_INCOMPATIBLE
    ERROR

identity_result =
    MATCH
    MISMATCH
    AMBIGUOUS
    NOT_EVALUATED

evidence_quality =
    SUFFICIENT
    INSUFFICIENT

reason_code =
    DECODER_ERROR
    DECRYPTION_ERROR
    LOW_INFORMATION
    INSUFFICIENT_COVERAGE
    UNSTABLE_ALIGNMENT
    MODALITY_DISAGREEMENT
    MULTIPLE_CANDIDATES
    REFERENCE_EXPIRED
    EXPECTATION_UNAVAILABLE
    EXPECTED_REFERENCE_MATCH
    EXPECTED_REFERENCE_MISMATCH
    TRAJECTORY_WARMUP
    ...
几个例子:
| 场景 | 评估状态 | 一致性结果 | 证据质量 | 原因码 |
|---|---|---|---|---|
| 解码器没有生成帧 | ERROR | NOT_EVALUATED | INSUFFICIENT | DECODER_ERROR |
| 缺少参考序列 | NO_REFERENCE | NOT_EVALUATED | INSUFFICIENT | EXPECTATION_UNAVAILABLE |
| 采样窗口主要由黑帧组成 | OK | AMBIGUOUS | INSUFFICIENT | LOW_INFORMATION |
| 视频与音频信号都稳定,但结论互相冲突 | OK | AMBIGUOUS | SUFFICIENT | MODALITY_DISAGREEMENT |
| 预期 E42 被充分否定 | OK | MISMATCH | SUFFICIENT | EXPECTED_REFERENCE_MISMATCH |
| 预期 E42 与参考位置轨迹都得到支持 | OK | MATCH | SUFFICIENT | EXPECTED_REFERENCE_MATCH |
SUFFICIENT 只表示:
证据足以解释这个结果。
它不表示:
结果一定是正向的。
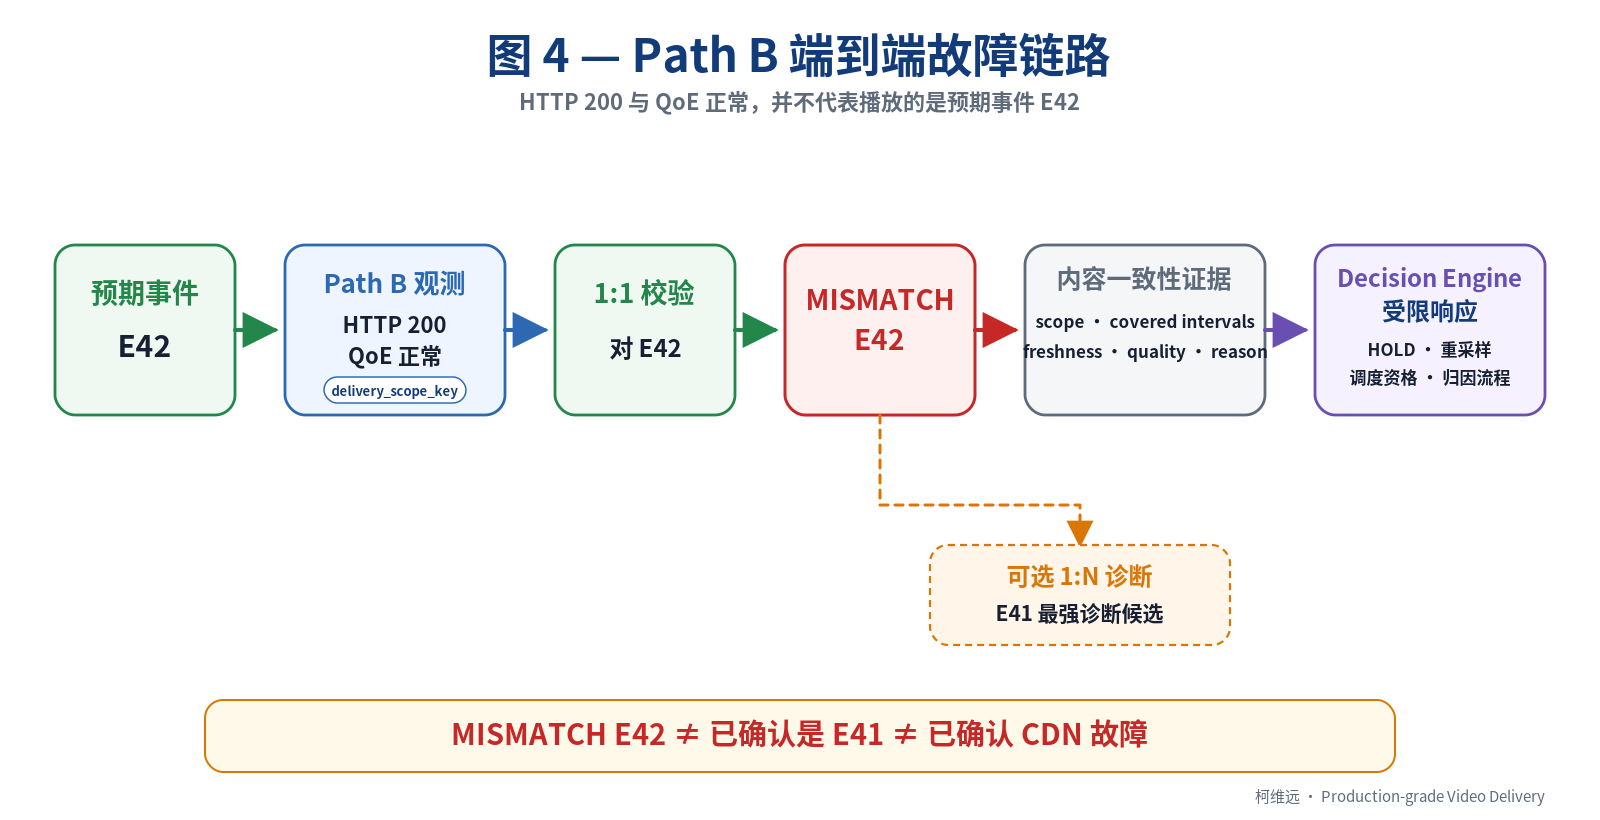
完整的 Path B 事故链路
下面是一个说明性示例。所有数值只用于展示数据流,不是通用阈值。
预期状态
tenant                  = T1
channel                 = sports-1
expected_event          = E42

identity_policy_version = policy-v7
reference_set_version   = refset-v12

media_timeline_epoch    = media-epoch-104
reference_time_base     = event-relative programme time
clock_mapping_version   = clockmap-v5

expected interval       = 12:30:00–12:31:00
allowed live lag        = 0–12 s

expected variant:
    video_reference {
        reference_id      = E42-main-video
        reference_version = v18
    }

    audio_reference {
        reference_id      = E42-zh-main
        reference_version = v9
        track_role        = main-commentary
    }
观测到的交付范围
CDN delivery path        = cdn-b
steering profile         = steering-r2
resolver context         = dns-profile-4

probe geography          = region-2
probe network            = ASN-X
resolved POP             = pop-17
cache cohort             = cohort-17

manifest variant         = 720p-h264
audio track              = zh-main

tracker_state_generation = tracker-gen-31
时间坐标与实际覆盖
capture_wall_clock_interval:
    2026-08-26T09:30:20Z
    –
    2026-08-26T09:30:50Z

observed_program_time_intervals:
    12:30:20–12:30:27
    12:30:31–12:30:38
    12:30:42–12:30:49

observed_media_pts_intervals:
    stored in evidence record
    with clock_mapping_version = clockmap-v5

matched_reference_interval:
    no stable interval for expected E42

estimated_offset:
    not established
针对 E42 的主流程 1:1 校验
evaluation_status       = OK

raw video similarity    = 0.24
raw audio similarity    = 0.19

stable E42 alignment    = not found
reference trajectory    = inconsistent
coverage                = sufficient for current policy

calibrated_identity_score(E42)
                        = 0.03
根据本文锁定的分数方向,较高值表示更支持预期参考序列。因此 0.03 落在当前运行策略的 MISMATCH 区间。
identity_result         = MISMATCH
evidence_quality        = SUFFICIENT
reason_code             = EXPECTED_REFERENCE_MISMATCH
这个结果只意味着:
在该交付观测范围和实际覆盖区间内,观测媒体流与预期
E42不符。
它不意味着:
- 媒体一定就是
E41; - 根因一定位于 CDN B;
- 整个 CDN B 都发生故障;
- 平台应该立即切走全部流量。
可选的 1:N 诊断性识别
diagnostic_candidate E41:
    video similarity    = 0.91
    audio similarity    = 0.94
    stable trajectory   = yes
    candidate offset    = consistent

diagnostic_candidate E40:
    similarity          = low

top-1 / top-2 margin    = sufficient
for diagnostic hypothesis
正确表述是:
主流程 1:1 校验没有确认预期 E42。可选的诊断性 1:N 识别把 E41 排为最可能的候选。
不能写成:
指纹已经确认 CDN B 返回的就是 E41。
决策模块收到什么?
transport dimension     = healthy
playback dimension      = healthy

evaluation_status       = OK
identity_result         = MISMATCH
evidence_quality        = SUFFICIENT
evidence_freshness      = VALID

scope                   = exact observed delivery scope
允许的受约束处置:
HOLD new steering into affected scope

increase sampling
within global budget

retain evidence

compare another independent vantage

start root-cause attribution workflow
不允许自动执行“关闭 CDN B 的全部流量”。
7. 采样与容量边界
系统不可能在不计算成本的情况下,持续解码所有频道、所有转码版本和所有交付观测范围的每一帧。
但成本优化也不能制造“系统在连续验证全部内容”的错觉。
先做低成本候选范围收缩
合理顺序是:
schedule / expected state
manifest metadata
codec and duration checks
exact object hash, where applicable
        ↓
candidate narrowing
        ↓
video / audio fingerprinting
        ↓
expensive diagnostics on demand
如果比较的确实是同一个字节对象,精确哈希仍然非常有价值。只有在字节一致性按设计不会保留时,才需要感知指纹。
需要计算什么?
sample_volume =
    channels
    × scoped_delivery_paths
    × windows_per_time
scoped_delivery_paths 必须已经包含被单独验证的转码版本、音轨和区域变体,否则工作量会被低估。
总成本近似为:
total_cost ≈
    sample_volume
    × (
        fetch
        + decrypt
        + decode
        + normalize
        + feature extraction
        + alignment
        + matching
        + evidence retention
      )
还要单独计算:
- 参考指纹生成;
- 注册库与索引;
- 副本与复制开销;
- 可观测性;
- 事故证据文件。
解码成本与特征提取成本是相加关系,不是相乘关系。
一个说明性的容量示例
假设:
channels             = 100
delivery scopes      = 4 per channel
sampling             = 1 window / 30 s

window duration      = 6 s
average bitrate      = 2 Mbps
frame rate           = 25 fps
GOP                   = 2 s
计算过程可以合并为一个容量估算:
sample throughput:
    100 × 4 / 30 ≈ 13.3 windows/s

bytes per 6-second window:
    2 Mbps × 6 s = 12 Mbit ≈ 1.5 MB

average fetch bandwidth:
    13.3 × 1.5 MB ≈ 20 MB/s ≈ 160 Mbps

local benchmark per window:
    decode + normalize   = 0.25 CPU-s
    feature extraction   = 0.03 CPU-s
    alignment + matching = 0.01 CPU-s

required compute:
    13.3 × 0.29 ≈ 3.86 CPU-core-seconds/s
    3.86 / 0.60 ≈ 6.5 CPU cores at 60% target utilization
这还没有计算排队、运行时开销、副本以及事故期间的突发负载。
这些数字不是算法基准,也不是容量建议。硬件解码、编码组合、HDR、B 帧、GOP 结构和解码器复用都可能显著改变结果。
每 30 秒只输出一个帧,也不等于解码成本会按被跳过的帧数同比下降。解码器可能仍要处理部分 GOP,或者维护帧间状态。
采样策略决定检测能力边界
每种模式都必须定义:
window duration
sampling period
coverage ratio
longest unsampled gap
maximum evidence age
expected detection latency
示例模式:
| 模式 | 行为 |
|---|---|
NORMAL | 稀疏周期采样 |
FAILOVER | 对旧路径与新路径临时提高采样频率 |
SUSPECT | 更频繁的多模态采样窗口 |
INCIDENT | 有预算上限的连续证据采集 |
始终要记住:请求检查的区间不等于已经验证的区间。验证器只能对实际覆盖的采样窗口做结论。
突发采样可能压垮验证器本身
大规模 Multi-CDN 事故可能同时让数千个频道进入突发采样模式。
如果没有保护约束,会形成反馈回路:
delivery incident
→ more sampling
→ decoder overload
→ validator loses samples
→ more uncertainty
因此需要:
global decode concurrency
max burst channels
per-tenant budget
critical-channel priority
admission control
deterministic degraded mode
资源不足时,系统应该可预测地:
- 保住关键事件的覆盖率;
- 降低低风险频道的采样频率;
- 如实输出
NO_SAMPLE或“覆盖不足”; - 绝不能把失去验证能力转换成
MATCH。
8. 如何监控验证器?为什么它不能直接控制 Multi-CDN?
验证器本身也是生产系统,也会失败。
可观测性最好分成三类。
在线服务健康度
这些指标可直接在线采集:
fetch_error_ratio
decrypt_error_ratio
decoder_error_ratio

fingerprint_generation_latency
fingerprint_match_latency

queue_depth
CPU / GPU saturation
budget_rejection_ratio
index_lookup_error_ratio
在线证据覆盖率
这些指标回答:有多少交付流量真正获得了可用的一致性证据?
NO_SAMPLE ratio
NO_REFERENCE ratio
VERSION_INCOMPATIBLE ratio

AMBIGUOUS ratio
insufficient_evidence ratio

actual coverage ratio
aligned duration
gap ratio

reference age
evidence age
offset distribution
drift distribution
sampling mode
离线或延迟质量评估
真正的误差指标包括:
误匹配率
漏匹配率
精确率
召回率
校准漂移
按内容类型分层的表现
无法从普通、没有真实标注的生产流量中直接得到。
它们需要:
- 已完成人工裁决的事故;
- 审计样本;
- 影子运行;
- 带标注的变换测试集;
- 受控故障注入。
所有证据记录必须保存:
fingerprint version
normalization version
identity-policy version
reference IDs and versions
reference-set version

probe build
extractor build
calibrator version
operating-policy version
否则上线后分数分布的变化将无法解释。
验证能力丢失不等于内容正确
必须保持一个不变量:失去验证能力不等于内容正确。
| 情况 | evaluation_status | identity_result | evidence_quality | reason_code |
|---|---|---|---|---|
| 没有可用样本 | NO_SAMPLE | NOT_EVALUATED | INSUFFICIENT | — |
| 没有可信参考序列 | NO_REFERENCE | NOT_EVALUATED | INSUFFICIENT | EXPECTATION_UNAVAILABLE |
| 解码失败 | ERROR | NOT_EVALUATED | INSUFFICIENT | DECODER_ERROR |
| 音视频信号稳定但互相冲突 | OK | AMBIGUOUS | SUFFICIENT | MODALITY_DISAGREEMENT |
AMBIGUOUS 不一定表示证据太少。有时证据已经足够,只是它揭示了真实歧义。
交付健康度不是可以相互抵消的总分
危险模型是把交付健康度写成“传输 + QoE + 内容一致性”的总分;它暗示优秀 QoE 可以抵消错误内容。
更合理的模型是保留彼此不可补偿的维度:
delivery_health = {
    transport,
    playback,
    content_identity
}
调度资格必须显式要求 MATCH
evidence_quality = SUFFICIENT 既可能伴随 MATCH,也可能伴随 MISMATCH。
因此不能只检查证据是否“足够”。
identity_acceptable =
    evaluation_status == OK
    AND identity_result == MATCH
    AND evidence_quality == SUFFICIENT
    AND evidence_freshness == VALID
只有这样才能继续:
eligible_for_steering =
    transport_ok
    AND playback_ok
    AND identity_acceptable
充分确认的 MISMATCH 是:
evaluation_status = OK
identity_result    = MISMATCH
evidence_quality   = SUFFICIENT

identity_acceptable = false
这里的 SUFFICIENT 表示证据足以支持负面结论,不表示这条路径可以继续被调度。
降级模式必须是独立策略分支
上一篇文章中的决策模块,在某些情况下可以允许验证器暂时不可用时的受限运行。
但这不能隐式发生。
degraded_steering_allowed =
    identity_result == NOT_EVALUATED
    AND degraded_mode_policy == ALLOW
    AND risk_tier permits degraded operation
    AND transport_ok
    AND playback_ok
    AND additional_guardrails_hold
这个分支必须具有:
- 有限影响范围;
- 最长持续时间;
- 更高采样优先级;
- 审计记录;
- 与已验证调度明确区分的状态。
缺少内容一致性证据不等于 MATCH。
指纹子系统不能直接控制 Multi-CDN
危险链路是:仅凭一个低相似度窗口,就全局停用某个 CDN。
低相似度可能来自:
- 解码失败;
- 对齐错误;
- 低信息量画面;
- 临时覆盖层;
- 另一条音轨;
- 过期参考序列;
- 策略不匹配;
- 提取器上线回归;
- 覆盖不足。
正确边界是:
Fingerprint Subsystem
        ↓
scoped, time-bound, calibrated evidence
        ↓
Article 7 Decision Engine
        ↓
policy + guardrails
        ↓
Action Gateway
        ↓
bounded production action
当特定观测范围内的 mismatch 被充分确认后,决策模块可以:
- 暂停继续向受影响范围导流;
- 在全局资源预算内提高采样频率;
- 从另一个独立观测点复核;
- 保存证据;
- 启动根因诊断;
- 准备受控回退。
但即使另一条路径之前是 MATCH,也不能无条件认为它永远安全:
- 证据可能已经过期;
- 多条路径可能共享同一个源站或封装器;
- 参考序列本身可能错误;
- 大规模切流可能触发级联故障。
指纹引擎输出证据。它不输出全局运行指令。
结语
生产级指纹系统不是一个“判断两个视频是否相似”的单一算法,而是一套把可信预期、时序证据、校准结果和运行约束连接起来的生产子系统。
| 生产问题 | 必要机制 |
|---|---|
| 预期内容本身是否可信 | 权威预期、可信参考序列、注册审批、版本与时间绑定 |
| 转码和延迟后是否仍然对应 | 视频/音频指纹、时间对齐、参考位置轨迹 |
| 相似度能否转化为局部结果 | 校准模型、工作点、明确的评估状态与结果语义 |
| 验证系统能否长期稳定运行 | 实际覆盖区间、容量预算、准入控制、可观测性与处置护栏 |
SHA-256 解决的是字节是否一致;指纹子系统形成的是范围明确、时间受限且经过校准的内容一致性证据;只有上层决策模块,才能把这些证据与传输、播放和其他信号结合起来,形成平台判定并触发受约束动作。
指纹子系统生成的是范围明确、时间受限且经过校准的内容一致性证据;最终判定、根因归属和生产动作仍由验证与控制平面负责。
但“与参考序列一致”仍不等于“参考本身可信”。内容来源、真实性以及合成修改如何进入信任模型,将是下一篇文章要解决的问题:
Deepfake Detector 为什么不能成为视频系统的唯一信任边界?
参考资料
[1] National Institute of Standards and Technology (NIST). FIPS PUB 180-4: Secure Hash Standard (SHS). 2015. DOI: 10.6028/NIST.FIPS.180-4.
[2] ISO/IEC. ISO/IEC 15938-3:2002/Amd 4:2010 — Information technology — Multimedia content description interface — Part 3: Visual — Amendment 4: Video signature tools. 2010.
[3] S. Paschalakis, M. Bober. MPEG-7 Video Signature Tools Overview. MPEG document N11824, 2011. MPEG 官方 Video Signature / Visual 概览.
[4] S. Paschalakis, K. Iwamoto, P. Brasnett, N. Sprljan, R. Oami, T. Nomura, A. Yamada, M. Bober. The MPEG-7 Video Signature Tools for Content Identification. IEEE Transactions on Circuits and Systems for Video Technology, Vol. 22, No. 7, pp. 1050–1063, 2012. DOI: 10.1109/TCSVT.2012.2189791.
[5] FFmpeg Project. FFmpeg Filters Documentation — signature filter. Living documentation, accessed 2026-08-29.
[6] Avery Li-Chun Wang. An Industrial Strength Audio Search Algorithm. Proceedings of the 4th International Conference on Music Information Retrieval (ISMIR 2003), pp. 7–13, 2003. 归档副本.
[7] Charles H. Knapp, G. Clifford Carter. The Generalized Correlation Method for Estimation of Time Delay. IEEE Transactions on Acoustics, Speech, and Signal Processing, Vol. 24, No. 4, pp. 320–327, 1976. DOI: 10.1109/TASSP.1976.1162830.
[8] Hiroaki Sakoe, Seibi Chiba. Dynamic Programming Algorithm Optimization for Spoken Word Recognition. IEEE Transactions on Acoustics, Speech, and Signal Processing, Vol. 26, No. 1, pp. 43–49, 1978. DOI: 10.1109/TASSP.1978.1163055.
[9] R. Pantos, W. May. RFC 8216 — HTTP Live Streaming. IETF, 2017. See Section 4.3.3.3, EXT-X-DISCONTINUITY-SEQUENCE.
[10] Alvin F. Martin, George R. Doddington, Terri Kamm, Mark Ordowski, Mark A. Przybocki. The DET Curve in Assessment of Detection Task Performance. Proceedings of Eurospeech 1997, pp. 1895–1898, 1997. DOI: 10.21437/Eurospeech.1997-504.
[11] National Institute of Standards and Technology (NIST). The NIST Year 2008 Speaker Recognition Evaluation Plan. 2008. NIST Speaker Recognition — SRE08 Evaluation Plan / Results.
作者: 柯维远(Vitaly Kostrov)
系列: 生产级视频分发实践
方向: 视频架构 · CDN / Multi-CDN · 内容完整性 · 可信交付

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)