把视频处理交给 Agent:AI MediaKit Skill 深度评测
一、引言:为什么要把视频处理交给 Agent
视频后处理里有大量“知道该做什么、但不想自己动手”的环节:老素材分辨率不够要增强,搬运或二创素材带着硬字幕要擦除,一小时的长视频要剪出能用的片段。这些活拆开看都不难,但串起来就是一下午的重复劳动——开剪辑软件、导素材、调参数、等导出、再导下一个。
大模型 Agent 擅长理解自然语言指令,但让它直接“处理视频”一直隔着一层:模型本身不碰音视频,得有手有脚的工具。MCP 和 Agent Skill 解决的就是这层连接问题。火山引擎视频云最近把自家的智能媒体处理能力打包成了 AI MediaKit Skill——一套可以被 Trae、Cursor、Claude Code 这类 Agent 直接调用的技能包,号称覆盖 80 项音视频与图像处理能力。
我关心的问题很实际:它对 Agent 是不是真的“开箱即用”?增强、擦除、剪辑这三件核心的事,效果到底到什么水平?长任务跑起来是什么体验?按量计费会不会一不小心超预算?这篇文章就围绕这三个方向,把安装配置、单项实测、组合流水线完整跑一遍,给出带数据的结论。
二、产品概览与核心能力
AI MediaKit Skill 的载体是火山引擎开源的命令行工具 mediakit-cli:技能包装进 Agent 后,Agent 通过自然语言理解需求,再调用 CLI 完成实际处理。不过我们也可以通过豆包工作这类agent工具来直接调用我们的AI MediaKit Skill。整个能力集按对象拆成 5 个技能包:
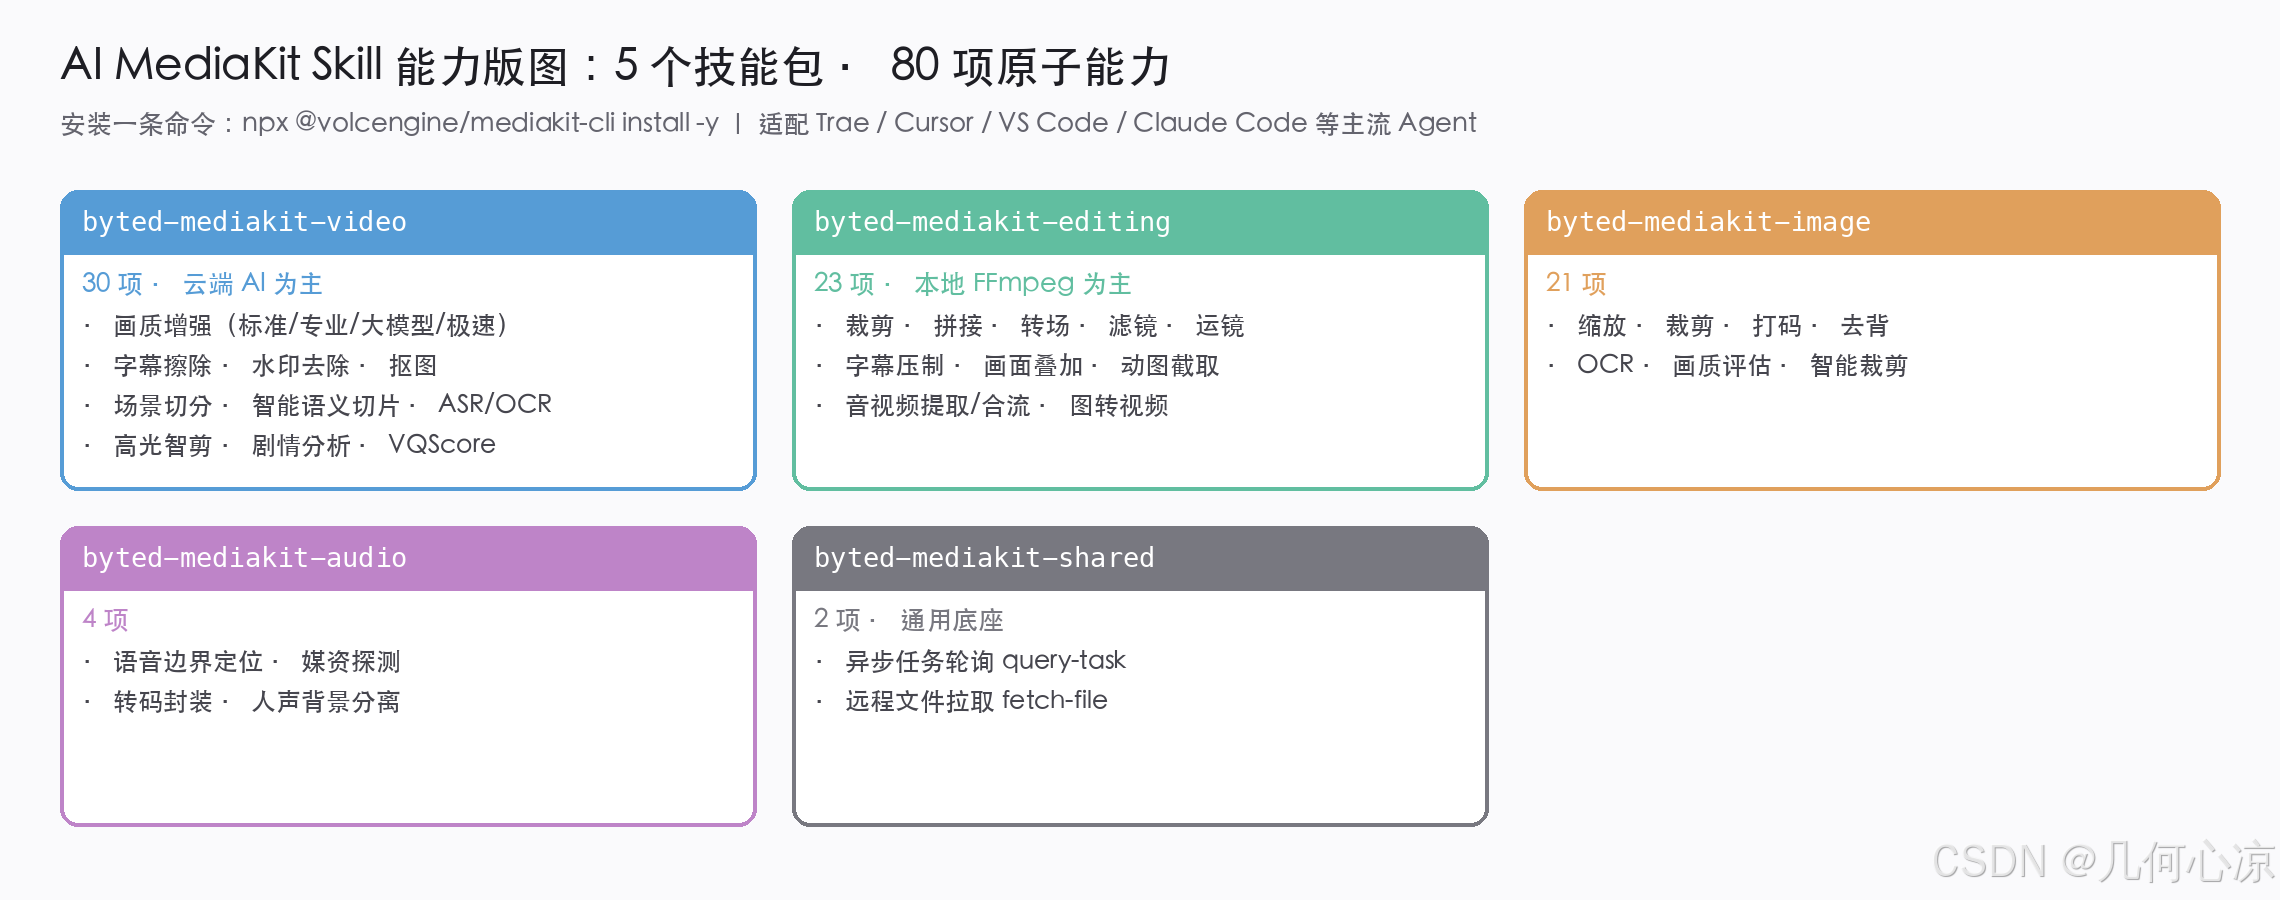
图1 AI MediaKit Skill 能力版图:5 个技能包、80 项原子能力
几个值得注意的结构性设计:
第一,本地与云端双模。 裁剪、拼接、转场这类确定性操作走本地 FFmpeg(秒级完成、不产生费用);画质增强、字幕擦除、语义切片这类 AI 能力走云端任务。Agent 会按能力性质自动选路,也可以用 --local / --cloud 强制指定。
第二,异步任务模型统一。 云端 AI 能力全部是“提交任务 → 返回 task_id → shared query-task 轮询 → 拿到结果地址”的闭环。长任务不会阻塞会话,Agent 可以在等待期间先汇报阶段性状态,这一点对“把活交给 Agent 然后去忙别的”的场景很关键。
第三,能力原子化。 每个命令只做一件事(切分只给时间轴、擦除只给净片),复杂需求靠 Agent 自己编排串联。这决定了它的上限取决于 Agent 的规划能力,下限则是每个原子能力的单项质量——所以本文重点测单项。
接入方式上,除 Skill 外同一套能力也开放 API 与控制台。需要说明:本文实测范围是 Skill+豆包工作,通过 API 直连的集成方式不在本文验证范围内,文中不会把未验证的接口形态写成既成结论。
三、上手体验:安装、配置到首次调用
3.1 安装与环境检查
这次我们使用豆包工作调用AI MediaKit Skill来完成本次产品体验,首先我们先下载下豆包工作,下载链接:豆包工作 - 工作新习惯,你说豆包干。
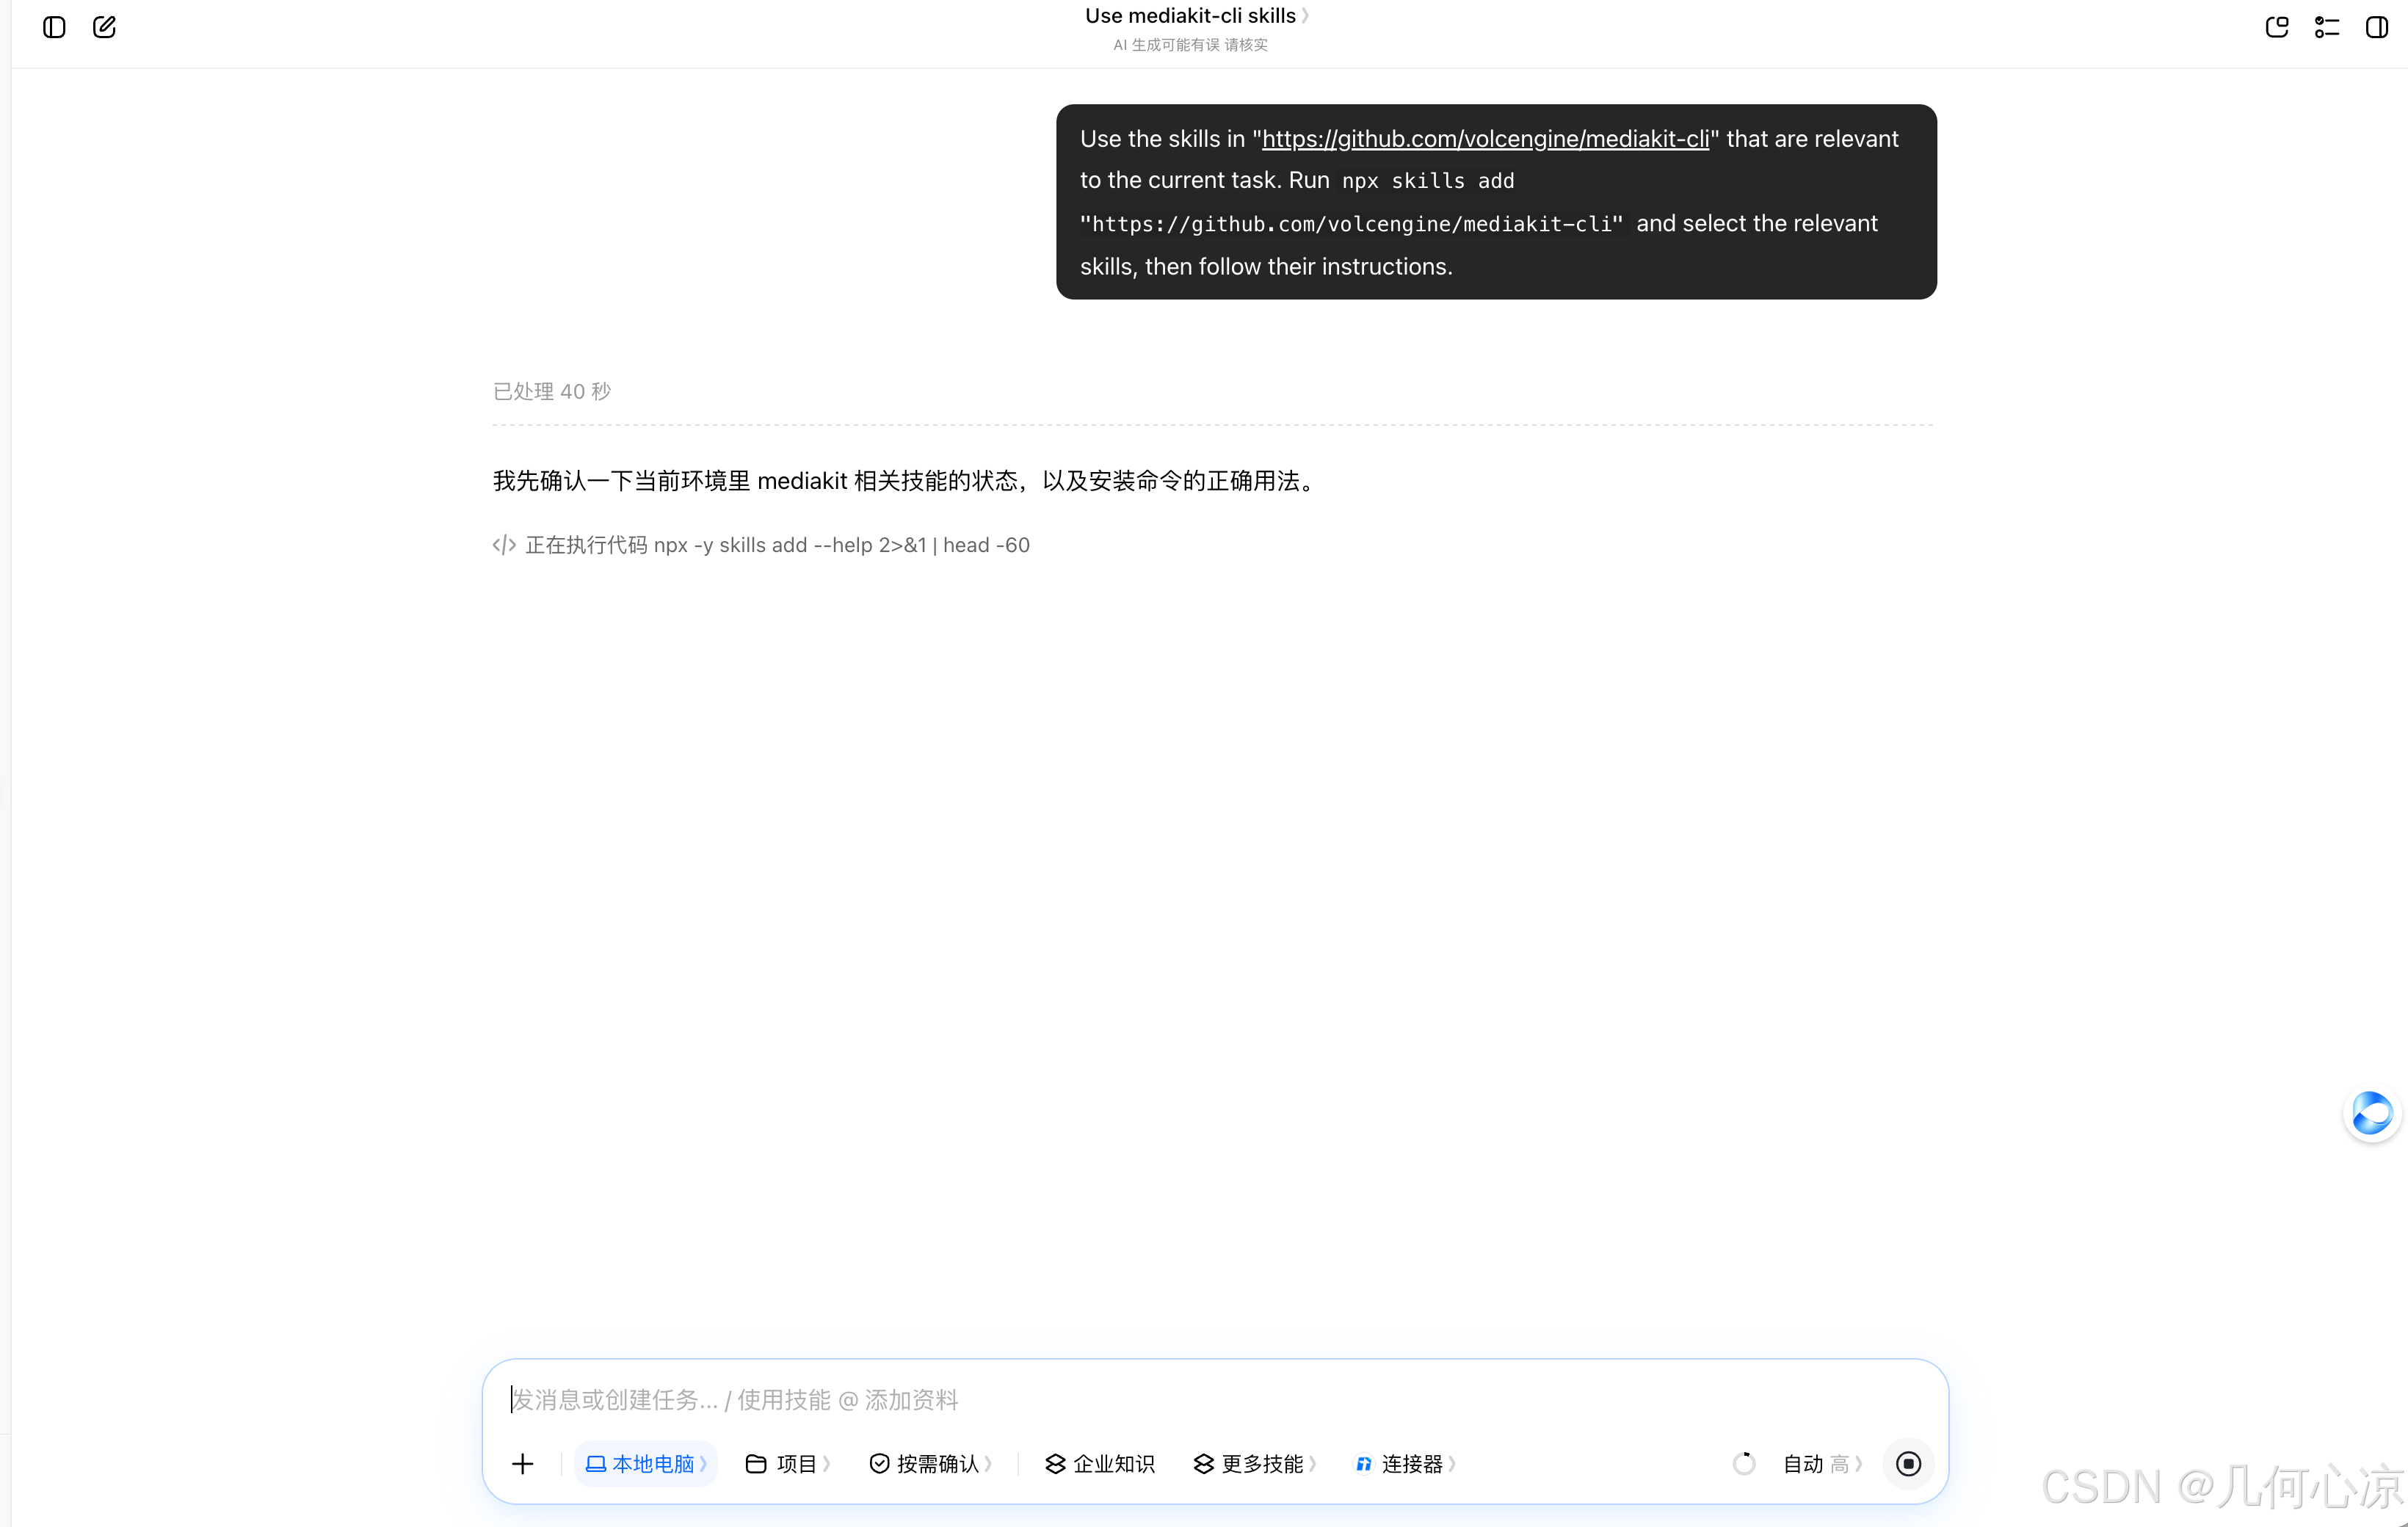
下载完成并登录以后,我们直接新建一个会话,输入以下prompt让它帮我们安装AI MediaKit Skill:
Use the skills in "https://github.com/volcengine/mediakit-cli" that are relevant to the current task. Run `npx skills add "https://github.com/volcengine/mediakit-cli"` and select the relevant skills, then follow their instructions.
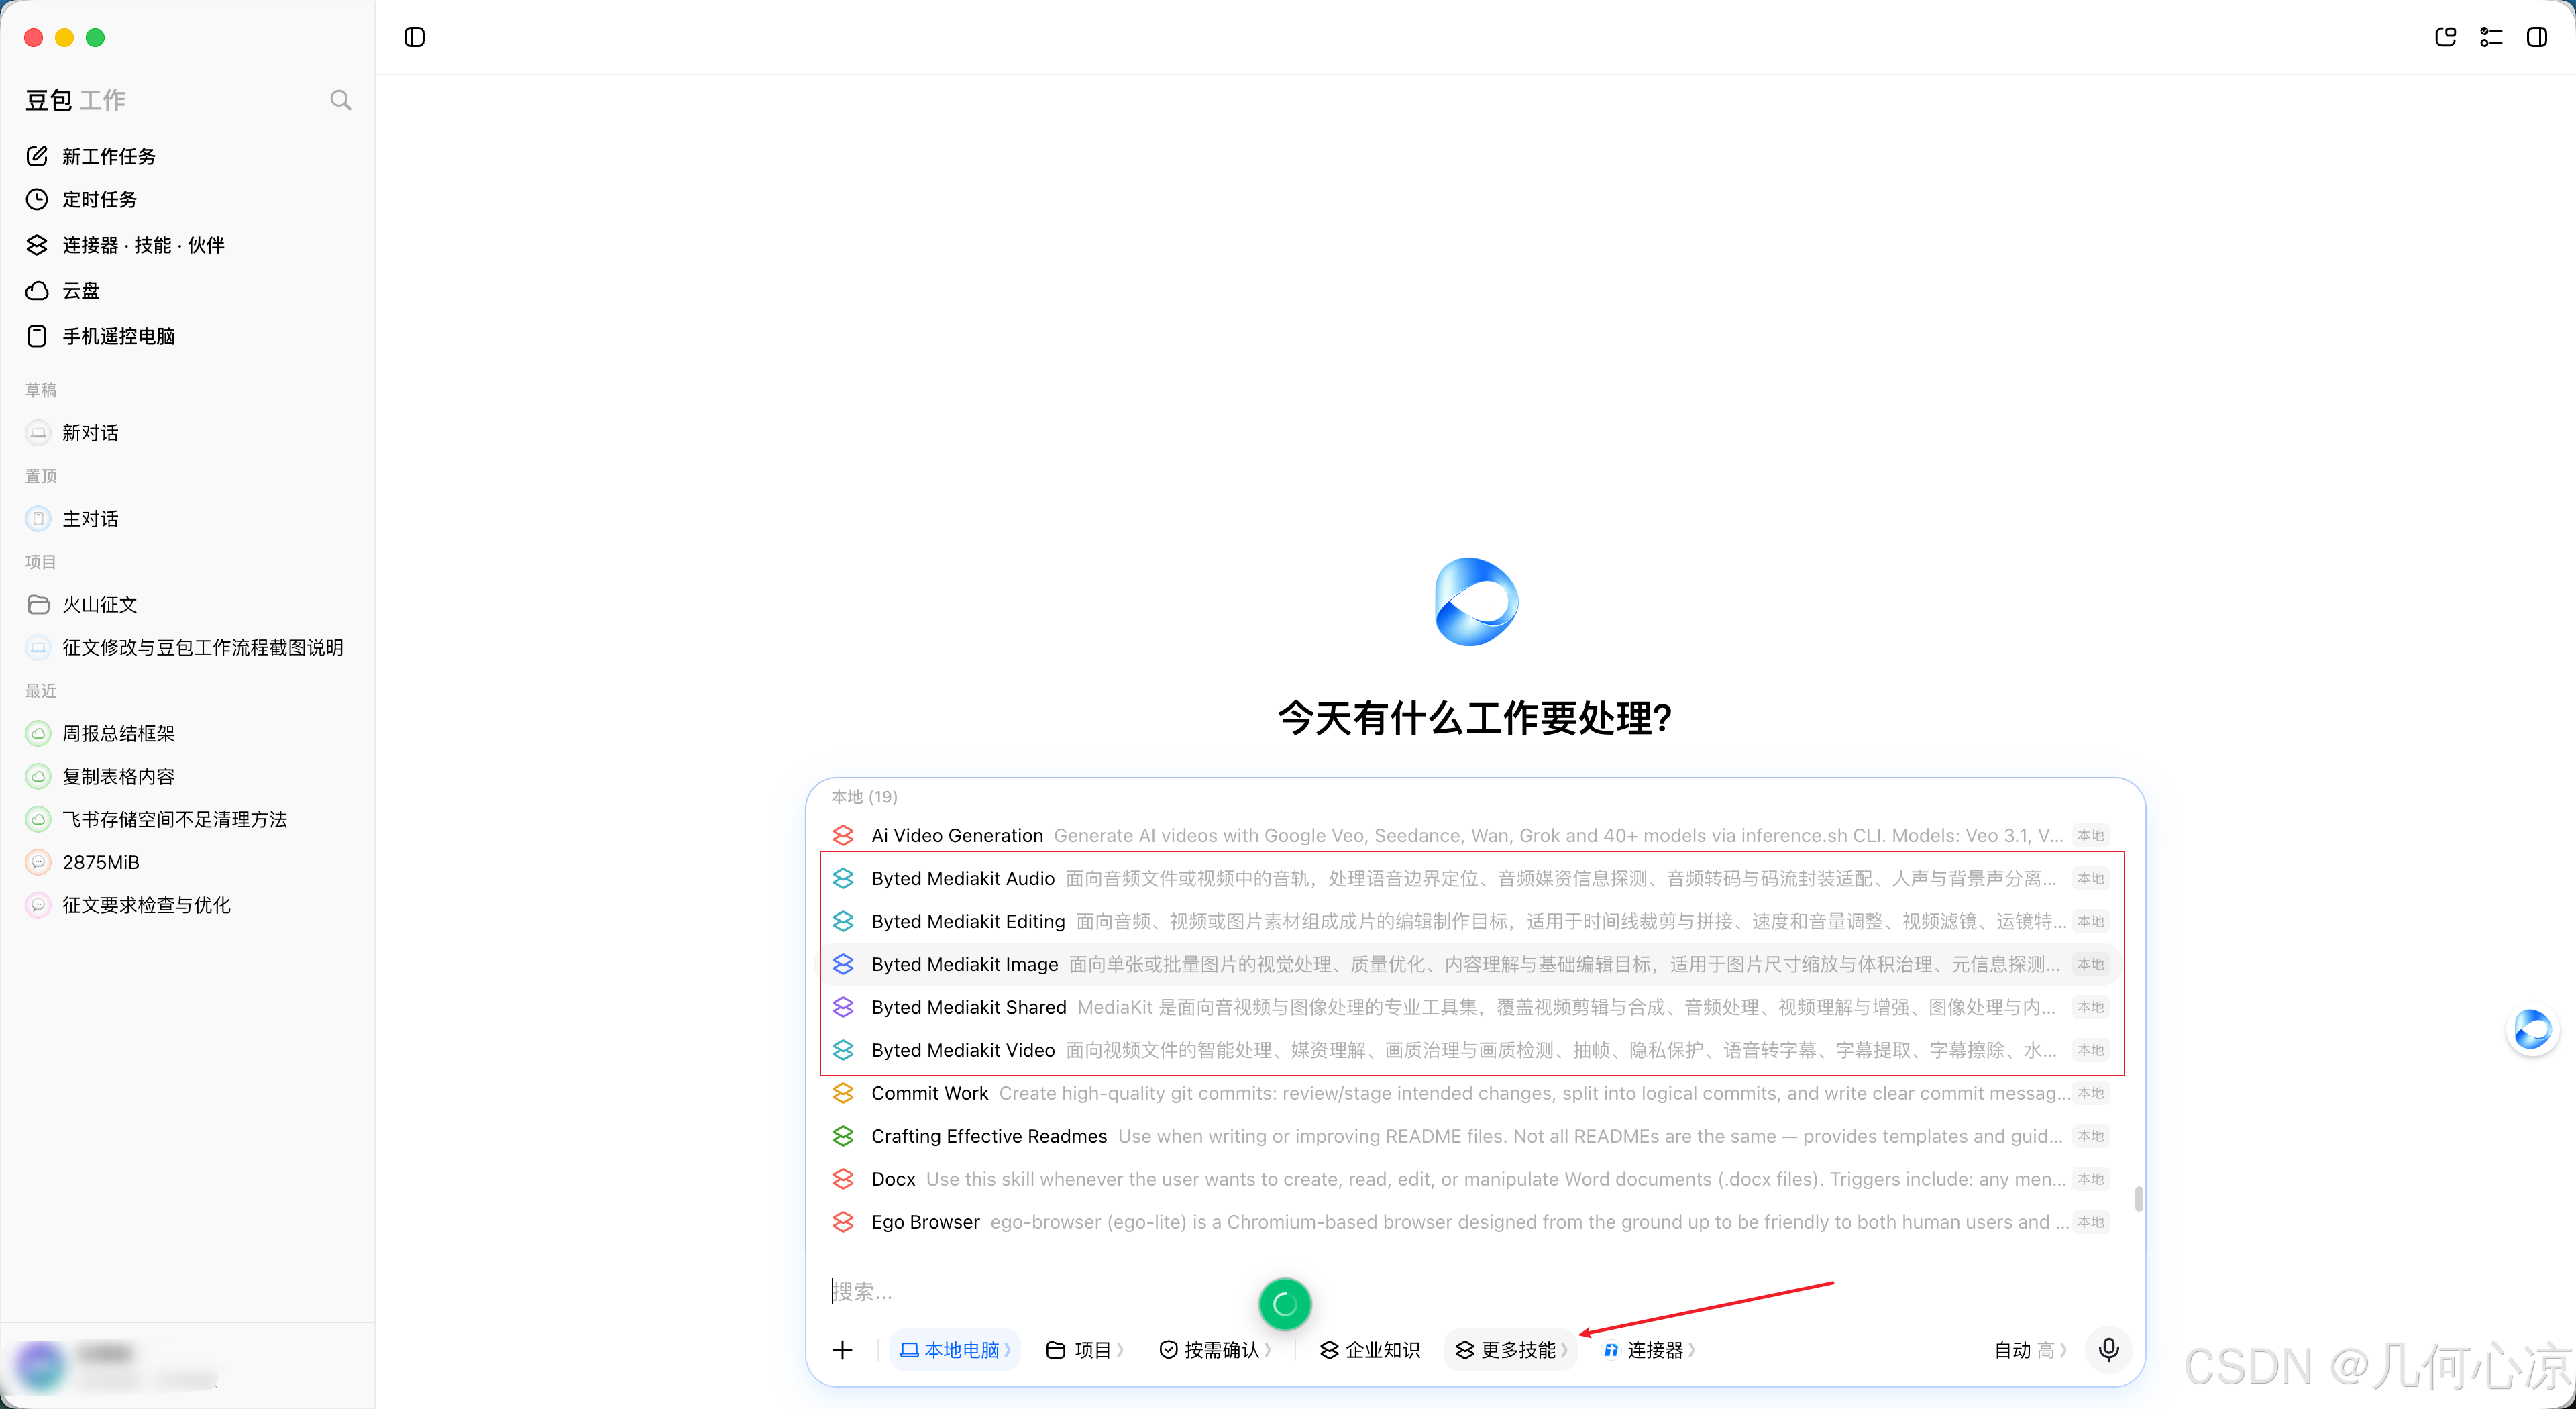
安装完成以后,可以看到更多技能栏里已经可以看到我们AI MediaKit Skill的几个技能。
接下来我们就需要配置下我们的api key,然后就可以在豆包工作中正常使用了。
API Key 在 AI MediaKit 控制台的“API Key 管理”页面创建获取(账号登录-火山引擎),创建后复制备用。
mediakit-cli init --api-key <你的API Key> --credential-store config --yes
3.2 首次调用:从一个演示视频开始
官方文档给了一个 480p 的演示视频(一段 AIGC 风格的猫咪短片,496×864、15s),正好用来做第一次云端调用——标准版画质增强到 1080p:
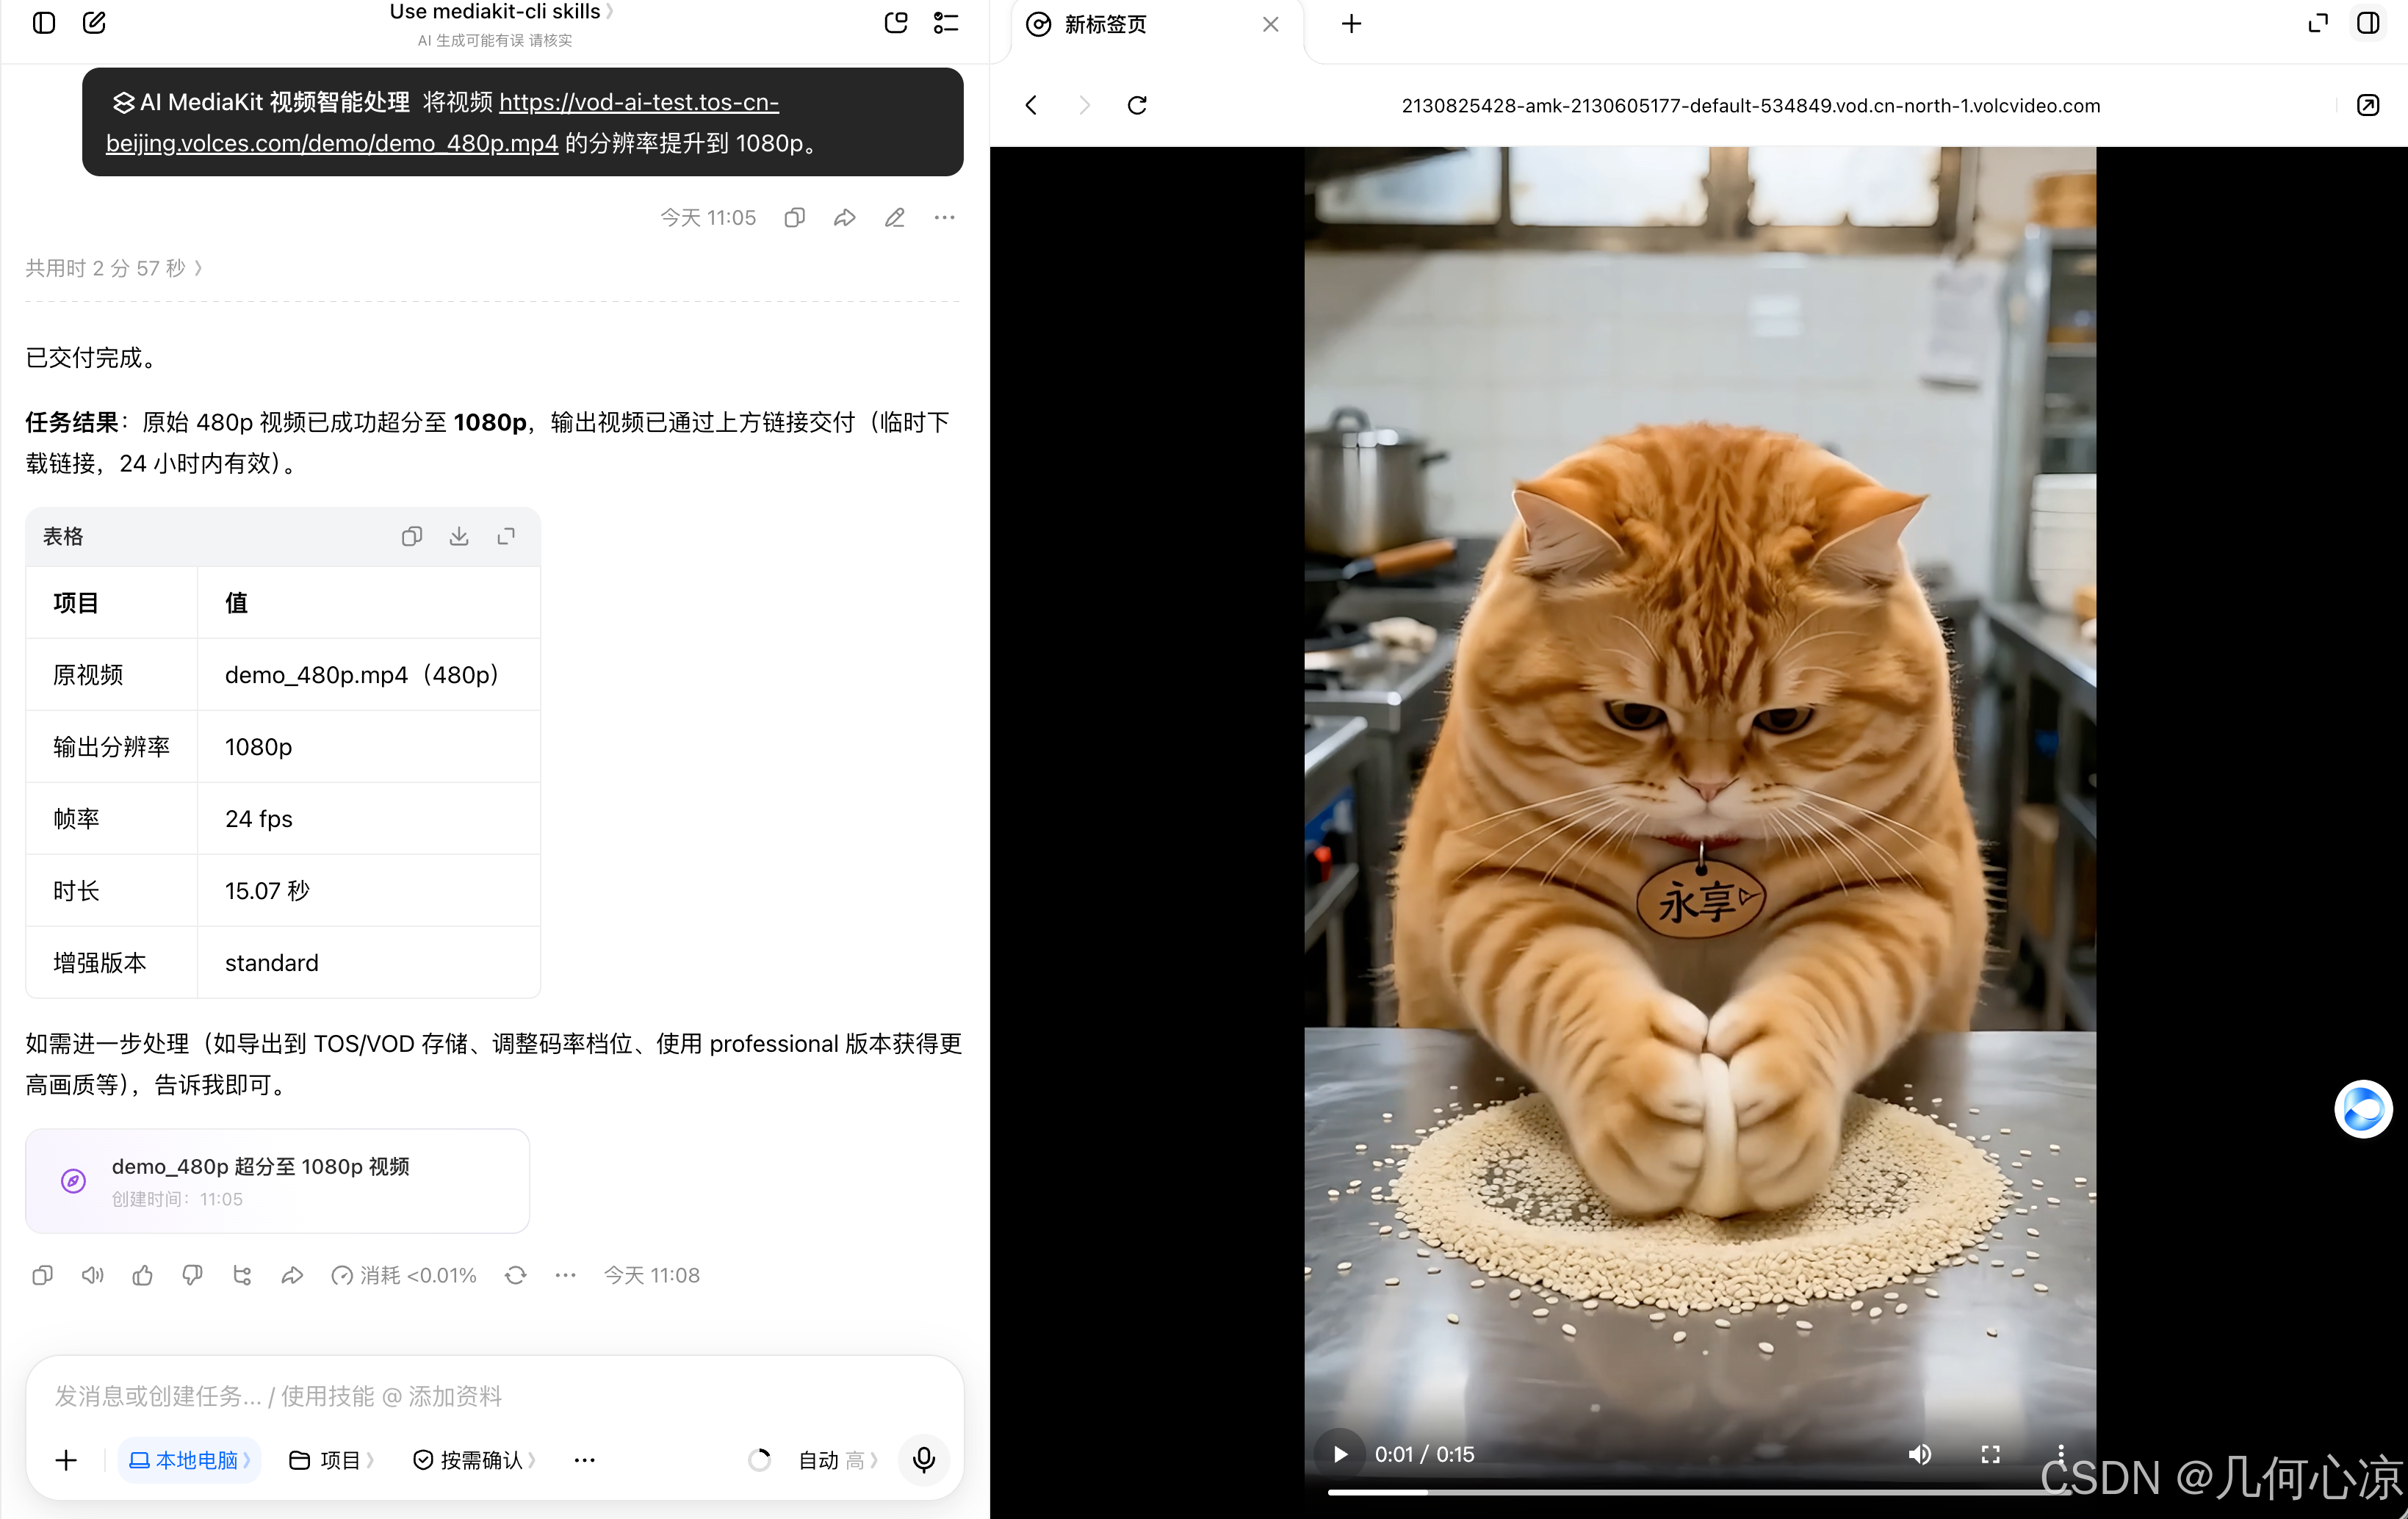
本地文件路径直接传给 --video-url 即可,CLI 会自动完成上传(实测多数命令都支持本地路径,例外情况见第六章)。任务提交后立刻返回 task_id,全程异步。这段 15s 的视频从提交到拿到成片约 5 分钟——云端 AI 任务是分钟级等待,不是秒级,对它的心理预期应该更接近“渲染农场”而不是“滤镜”。
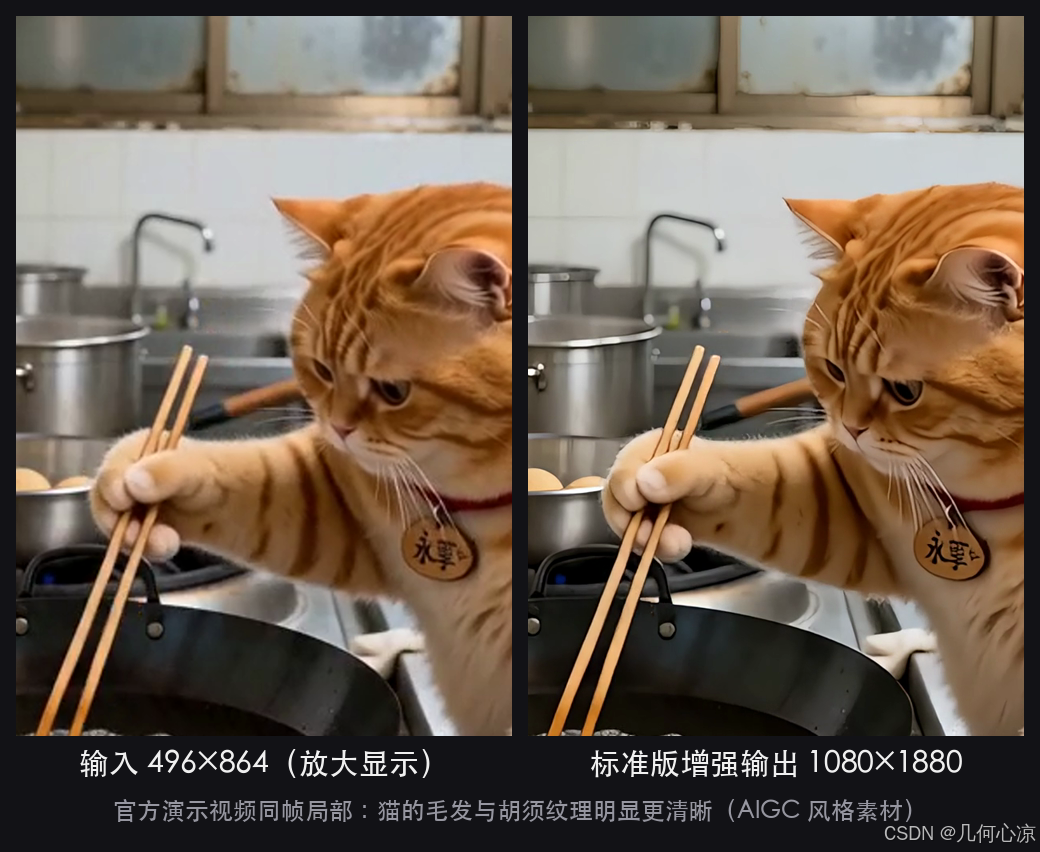 图5 官方演示视频增强前后同帧对比
效果第一眼是成立的:猫的毛发、胡须和筷子边缘明显更锐利,画面整体干净度提升,没有出现明显的人工痕迹。到这一步,从安装到产出第一个结果,总耗时约 5分钟,上手成本较低。
四、画质增强:低质素材的增强效果与适用范围
演示视频毕竟是他家挑好的素材。为了测出真实水平,我搭了一组受控对照实验:取 CC-BY 开源电影《Sintel》预告片(1080p)做基准,人工降质成 480p 并叠加噪点和高压缩(模拟老素材/多次转码的真实状态),再分别用普通 Lanczos 放大、AI 增强标准版、AI 增强大模型版处理回 1080p,最后同帧对比 + 用平台自带的 VQScore 画质检测跑客观分。
素材覆盖三类典型难点:人像肤质与毛发纹理、高速运动、低对比度雪景。
4.1 人像与细节纹理
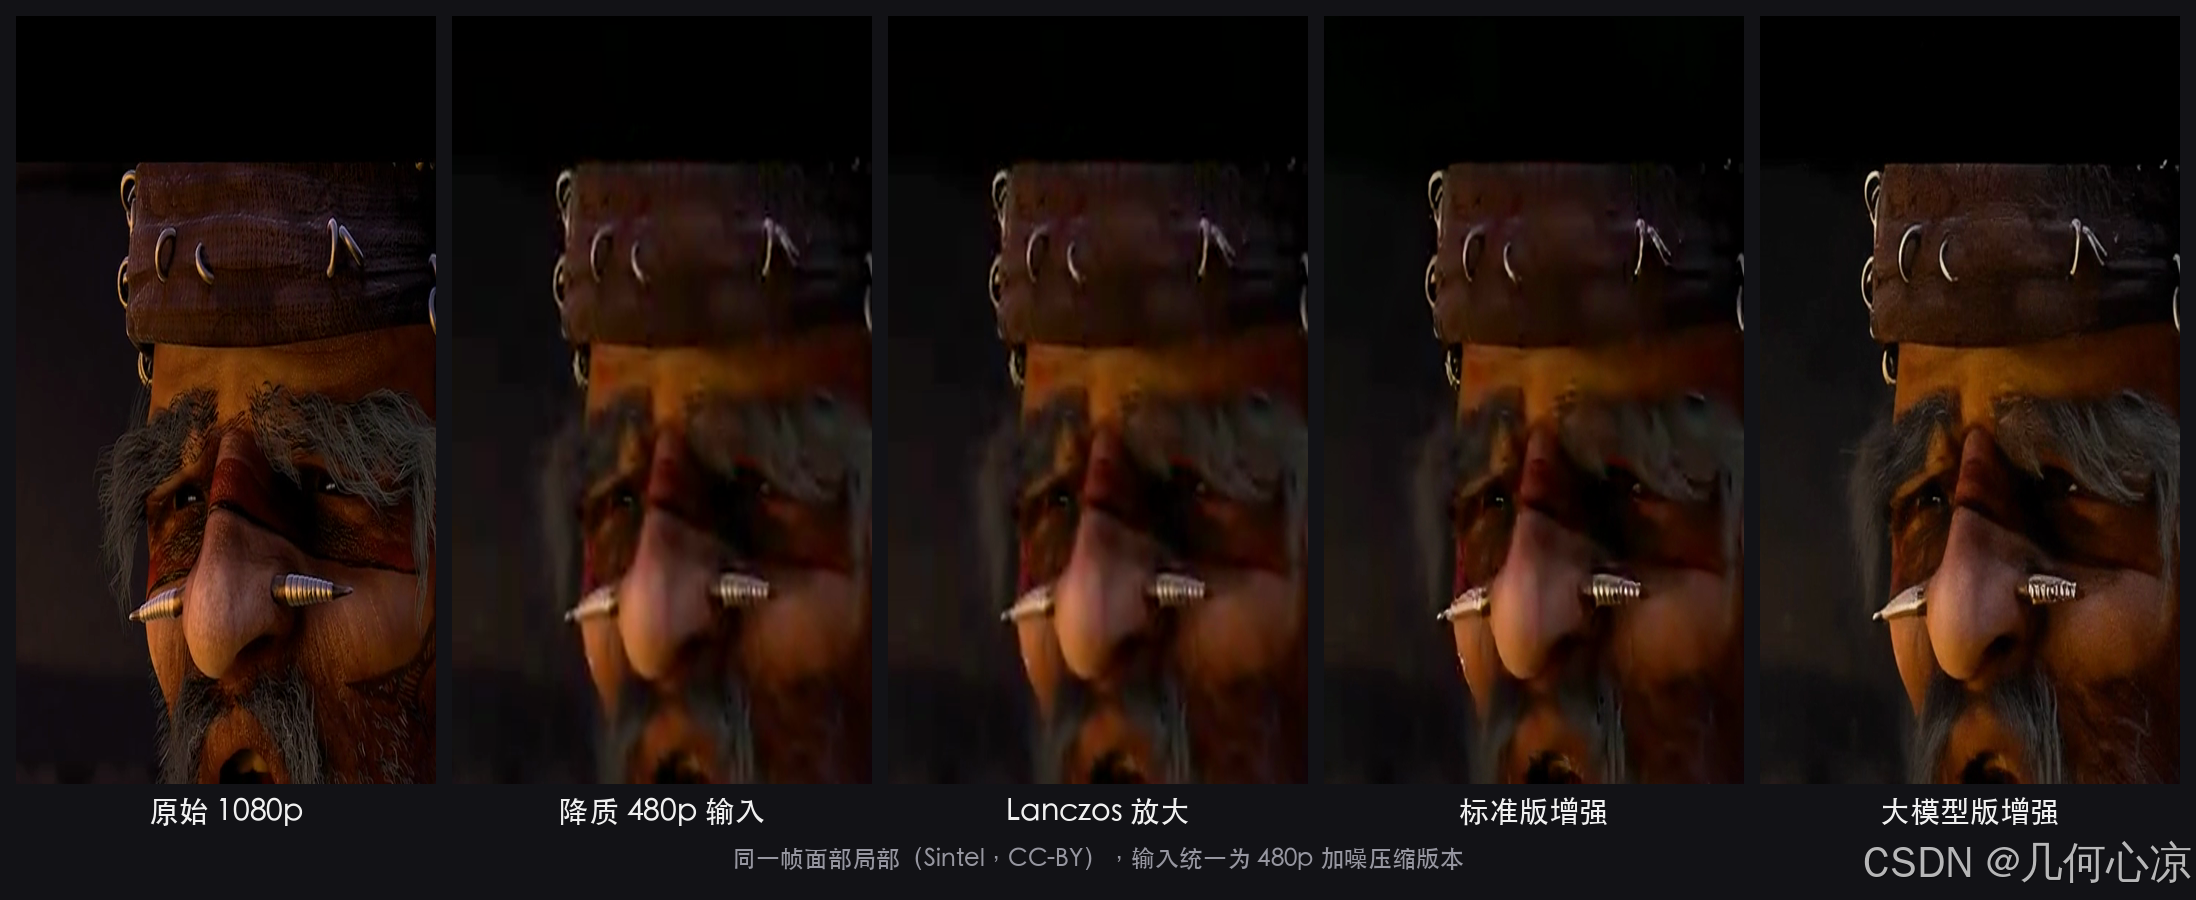
图6 人像场景五方对比:原始 / 降质输入 / 普通放大 / 标准版 / 大模型版
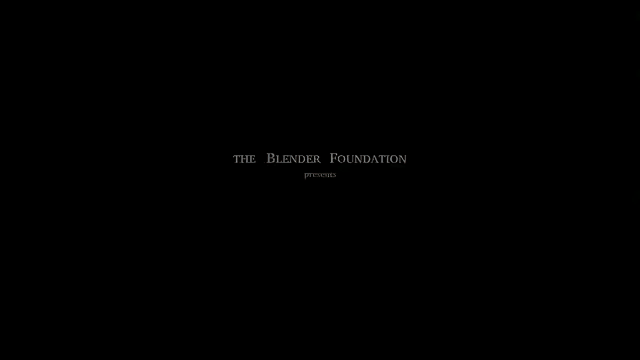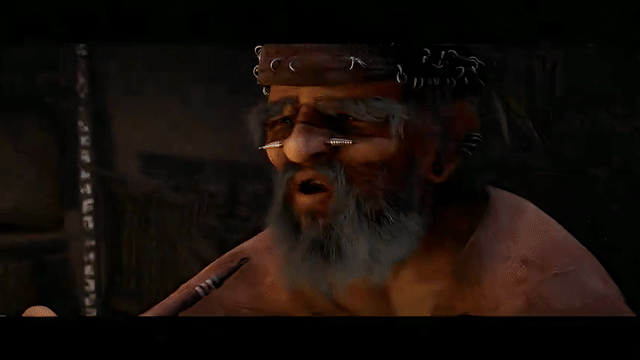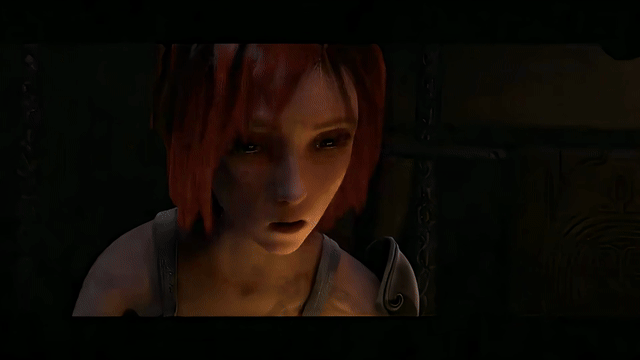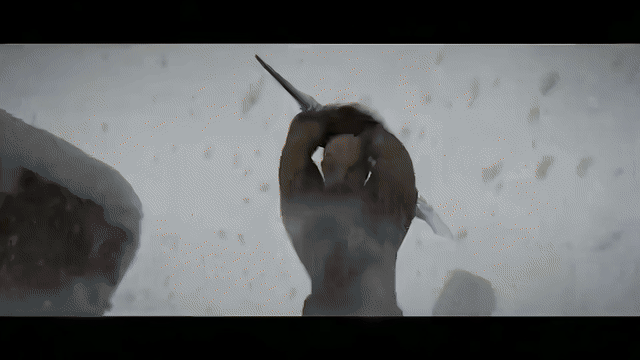
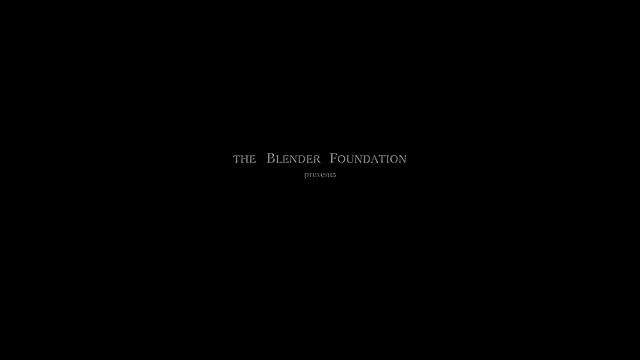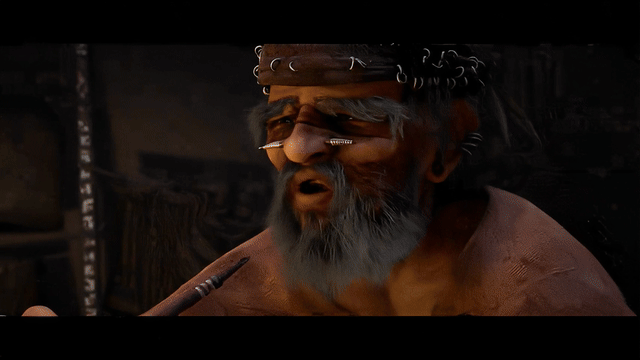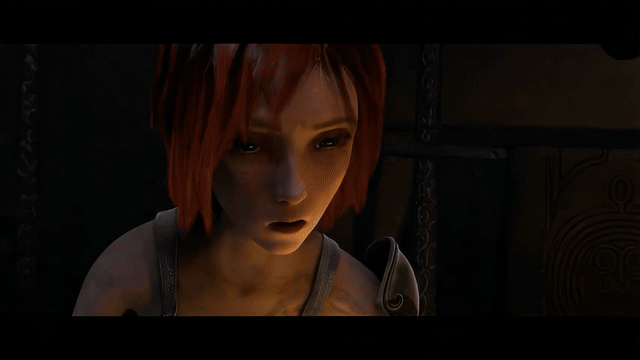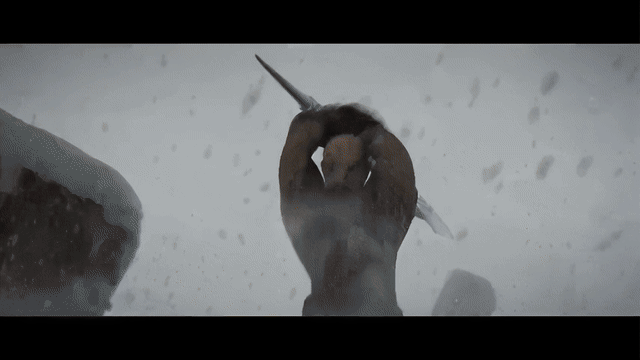
差异是肉眼可辨的:降质后胡须和皮肤纹理糊成一片;Lanczos 放大只是“平滑地糊”,没有找回任何信息;标准版把胡须逐根拉了回来;大模型版的毛发细节最丰富,但凑近看个别区域有轻微“重绘感”——这是生成式路线的固有特征,追求内容保真的场景(比如证据类素材)要留意。
4.2 运动场景
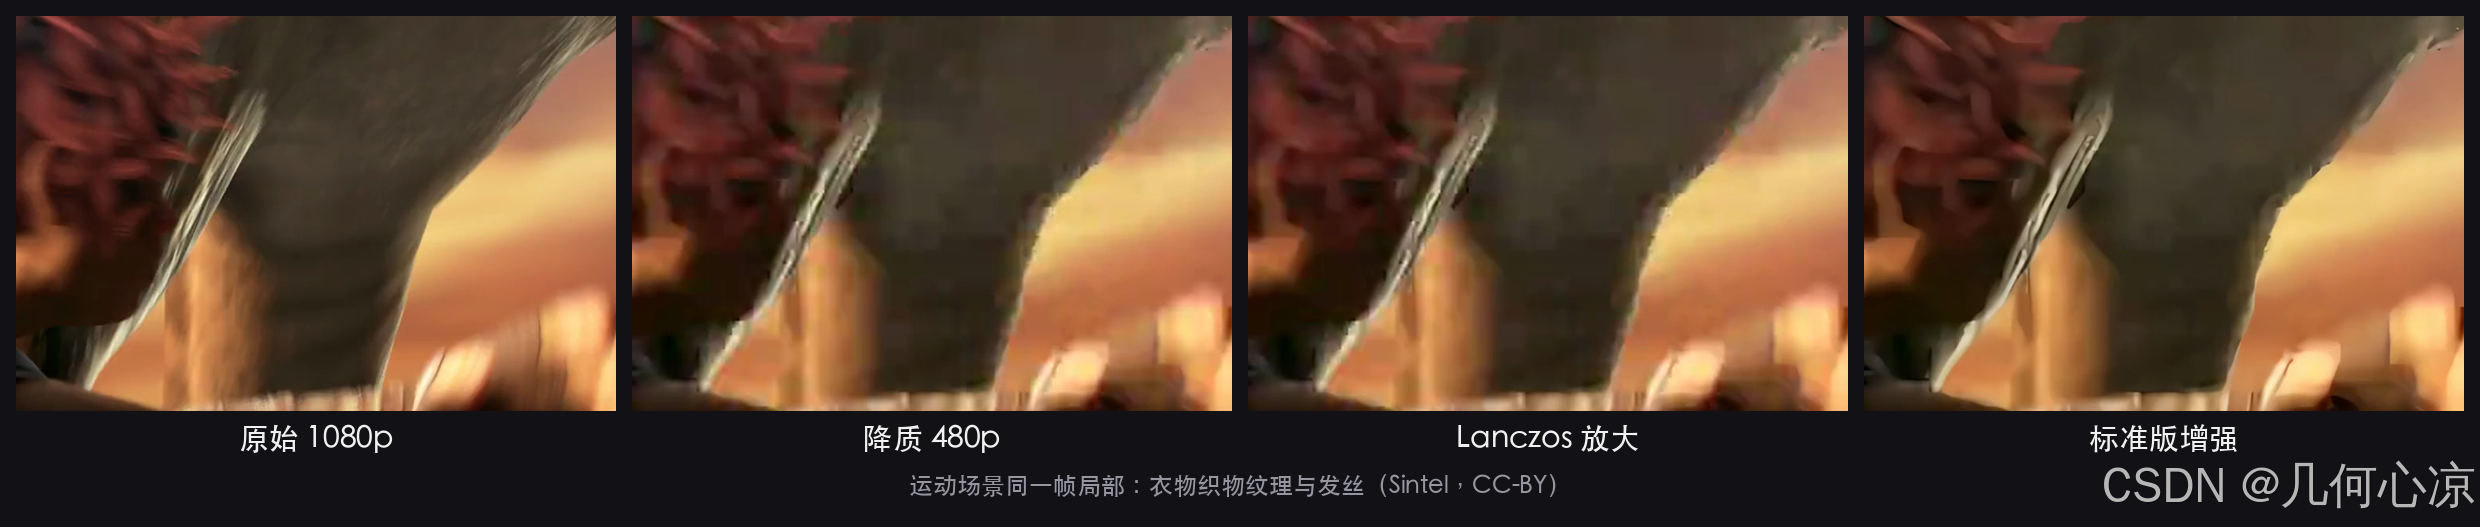
图7 运动场景对比:衣物纹理与发丝
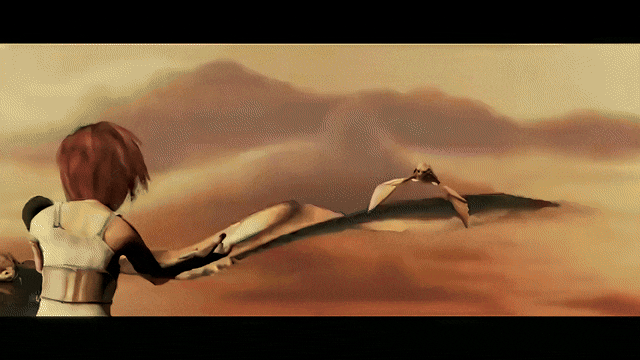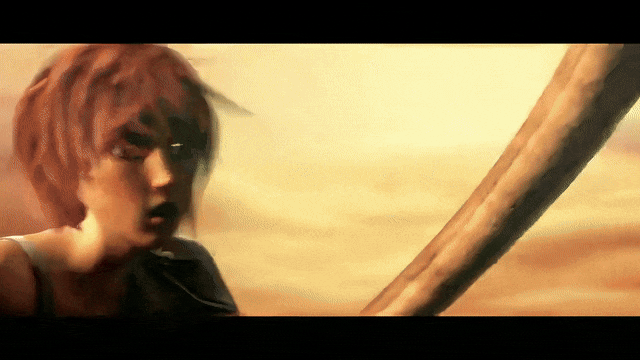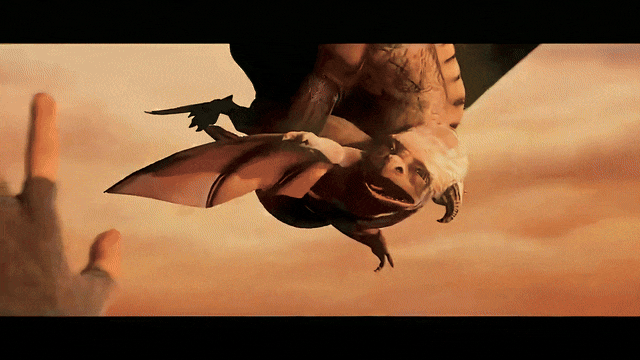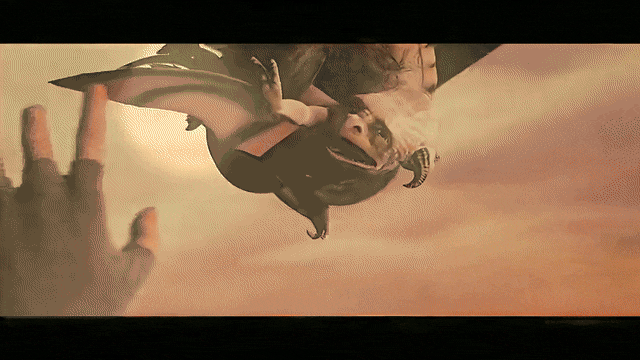
运动场景是超分容易翻车的地方(容易出现帧间不一致和闪烁)。实测标准版在织物纹理和发丝上恢复稳定,我逐帧翻看输出没有发现明显闪烁或鬼影,说明时序一致性处理是合格的。
低对比度的暴风雪远景我也测了:这类画面本身信息量极低,增强后山体轮廓略有收紧但提升有限——本来就没有细节的场景,增强无从恢复,选素材时不必对这类画面抱期待。
4.3 客观分对照
主观感受之外,用 assess-video-quality(VQScore,0–100 分)给同一段人像素材的五个版本打分:
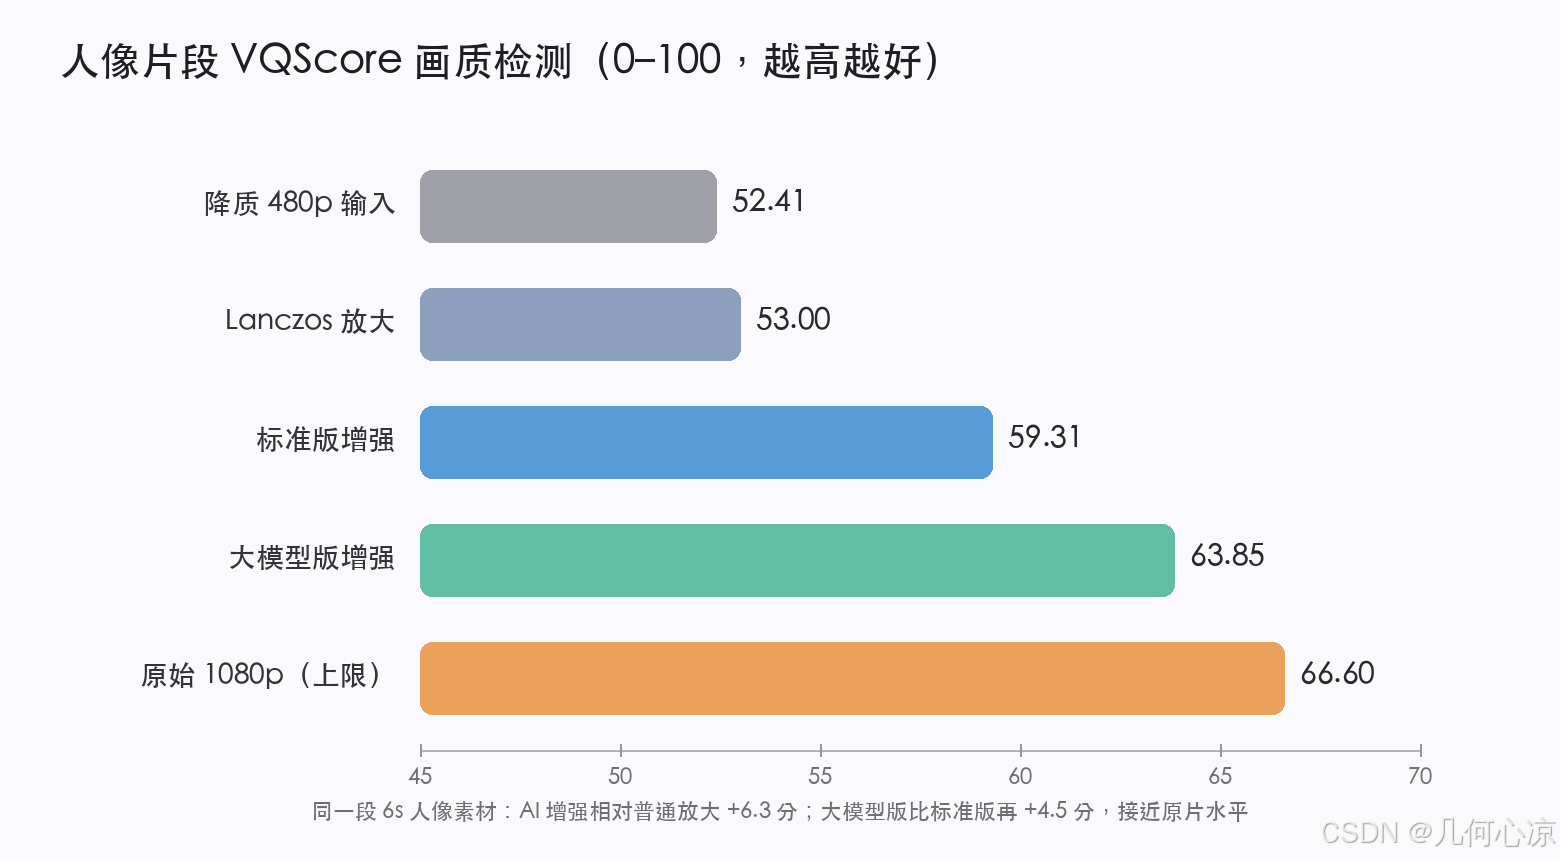
图8 人像片段五版本 VQScore 对比
| 版本 | VQScore | 相对降质输入 |
| 降质 480p 输入 | 52.41 | — |
| Lanczos 普通放大 | 53.00 | +0.59 |
| AI 增强·标准版 | 59.31 | +6.90 |
| AI 增强·大模型版 | 63.85 | +11.44 |
| 原始 1080p(理论上限) | 66.60 | +14.19 |
表1 VQScore 客观分对照(6s 人像素材,同一测评链路)
数据把结论说得很直白:普通放大几乎不得分(+0.59),AI 增强是质变(+6.9~+11.4),大模型版能恢复到接近原片 96% 的水平。同时它也诚实地标定了边界——增强是“恢复”不是“超越”,没有哪个版本超过原片分数。
耗时与成本维度:6s 的 480p→1080p 标准版增强约 3 分半钟完成(含上传与排队);按公示价标准版 1080p≤30fps 为 1.5 元/输出分钟、大模型版 5 元/分钟、极速版 0.4 元/分钟。常规修复用标准版性价比最高;大模型版适合精品内容;批量跑量建议先评估极速版。
五、字幕擦除:识别准确性与画面一致性
字幕擦除看两件事:擦得干不干净,以及不该动的地方动不动。我用了两组素材:官方短剧演示片(人像 + 复杂场景,39s),以及一段自造的压力测试片——先用 AI MediaKit Skill自己的字幕压制能力往《Sintel》片段上烧了三组字幕,刻意覆盖三个难点:运动物体(龙翼)反复穿过字幕区、火焰岩石复杂纹理背景、擦除中途发生镜头切换。
5.1 常规人像场景与意外发现
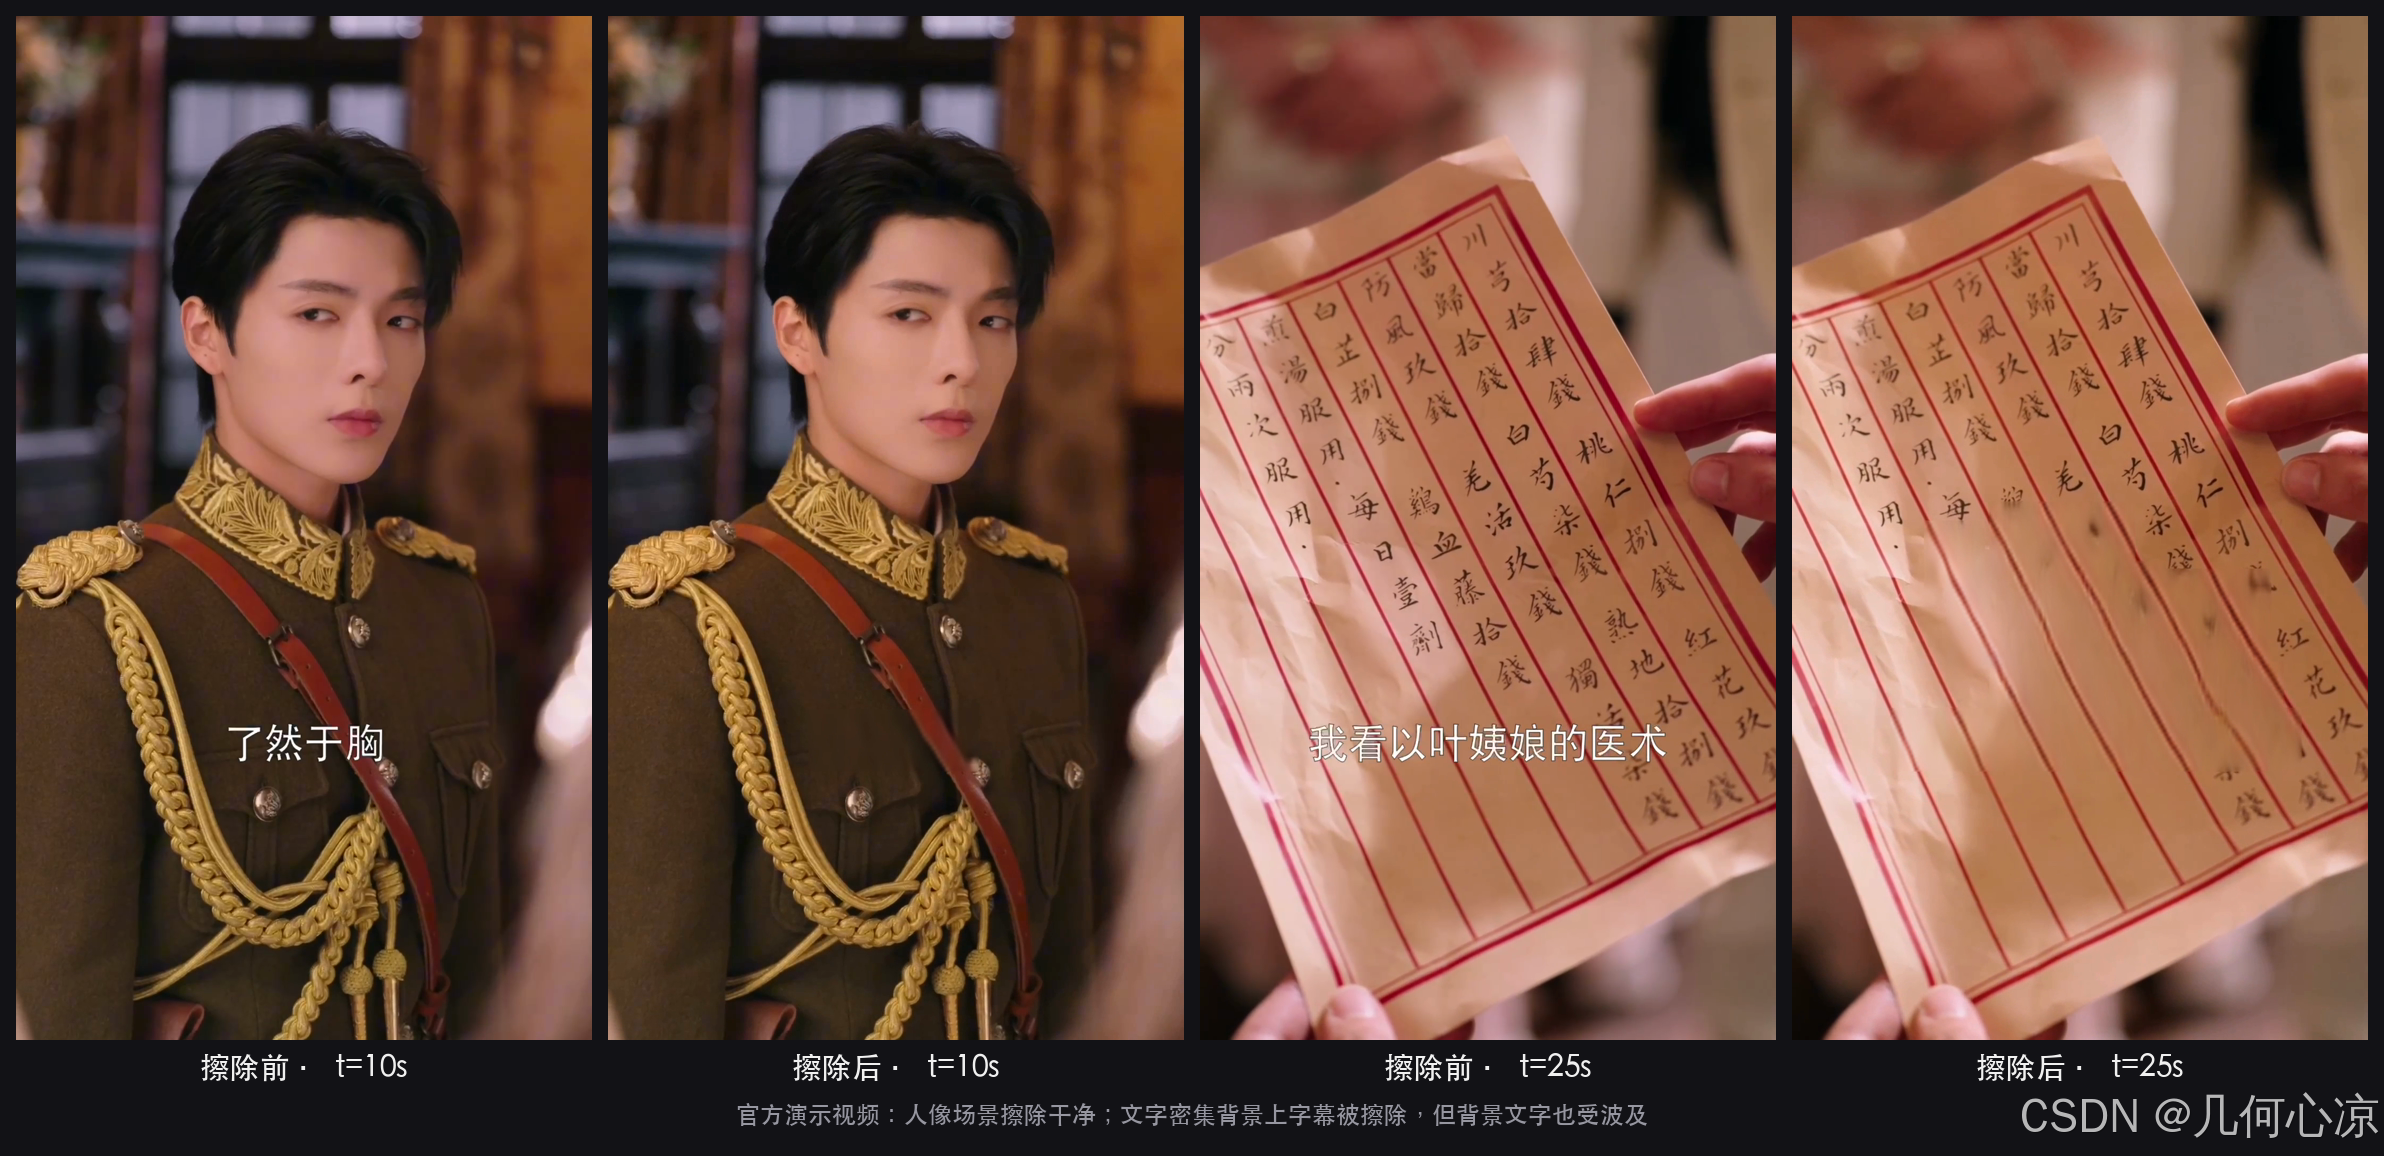
图9 官方演示片擦除前后:人像场景完美;文字密集背景出现误伤
人像场景(左)挑不出毛病:底部硬字幕“了然于胸”彻底消失,军装配色、刺绣纹理、面部细节零损伤。
但右图是个值得记录的真实发现:当字幕叠加在本身就是密集文字的背景(一封写满毛笔字的信)上时,字幕被擦掉了,信纸上原有的手写文字也被连带抹掉了一片。模型显然无法区分“后期加的字幕”和“画面里原生拍摄到的文字”。这不算 bug,更像是这类 inpainting 路线的能力边界——如果你的素材里文字是内容主体(板书、文档、牌匾特写),擦除后务必人工复核。
5.2 压力测试:运动、纹理、镜头切换
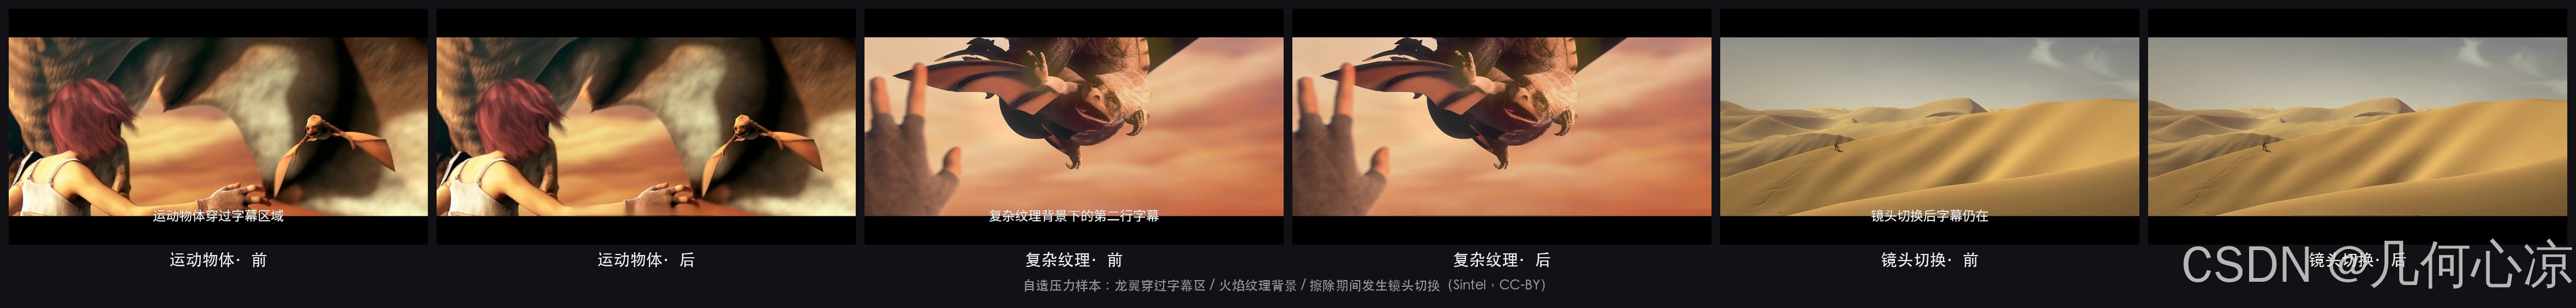
图10 自造压力样本擦除前后对比
三个难点场景全部通过:龙翼穿过字幕区的帧里没有残留也没有把翅膀擦缺;火焰纹理背景补全自然,看不出填充痕迹;镜头切换前后的字幕都被稳定跟踪。整段 12s 1080p 视频处理耗时约 4 分钟,39s 官方演示片约 3 分钟,擦除类任务的速度与片长大致线性。
价格方面,字幕擦除公示价 1 元/分钟(按擦除时长计)。我的判断是:常规短视频/短剧去字幕可以放心交给它,ROI 远高于人工逐帧修;但文字即内容的素材要加一道人工验收。
六、智能剪辑:
智能剪辑是最能体现“Agent 化”价值的方向,也是最容易被宣传话术带偏的方向。测之前先厘清一个关键事实:AI MediaKit Skill里“剪辑”相关的三个能力,交付物完全不同——
- segment-scenes(场景切分):按画面转场切镜头,交付时间轴(可选同时输出片段文件);
- semantic-segment(智能语义切片):按语义/叙事结构选段,交付结构化 JSON 时间轴;
- 高光智剪/影视拆条类:交付可直接播放的成片。
也就是说前两样是“剪辑决策建议”,最后一样才是“代剪”。把它们混为一谈是选型时最容易踩的坑。
6.1 场景切分:速度与粒度
拿一段 40s 的快切预告片测试,切出 15 个镜头段,耗时不到 1 分钟:
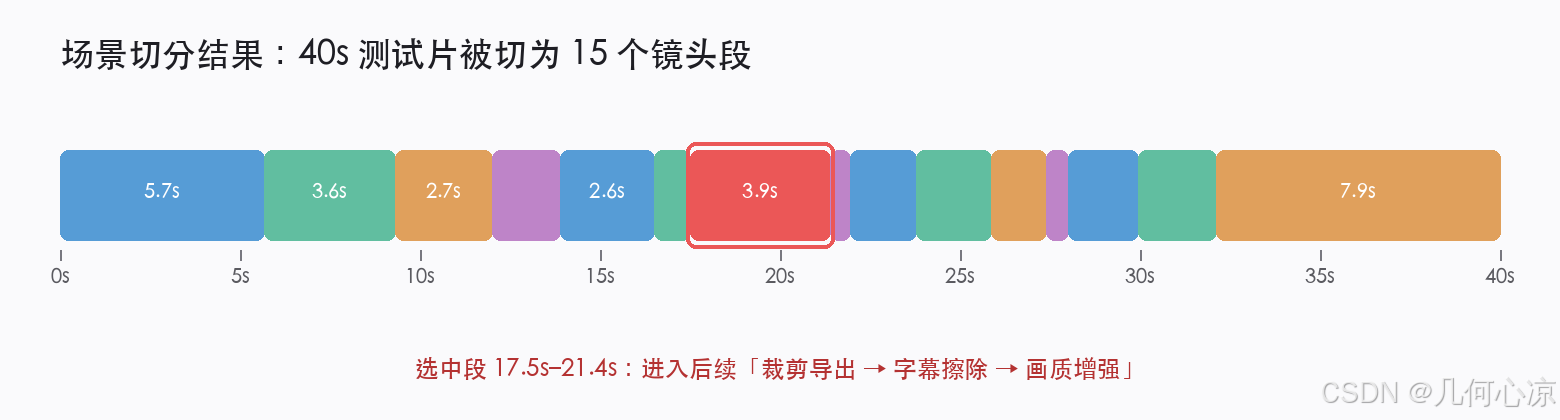
图11 场景切分结果:40s 测试片被切为 15 段
粒度上能抓到大多数镜头边界,包括两个不足 1 秒的闪切帧(21.4–21.9s、27.4–28.0s)——做影视二创拆条时这种精度够用。
对照组同样说明问题:把一段 2 分钟的录屏网课(画面几乎静止的板书 + 摄像头小窗)喂进去,结果是1 段——因为整段没有任何镜头切换。这不是缺陷,而是提醒你:画面静止的讲解类内容不该走场景切分,该走语音和语义。
6.2 语音转字幕:理解类能力的底座
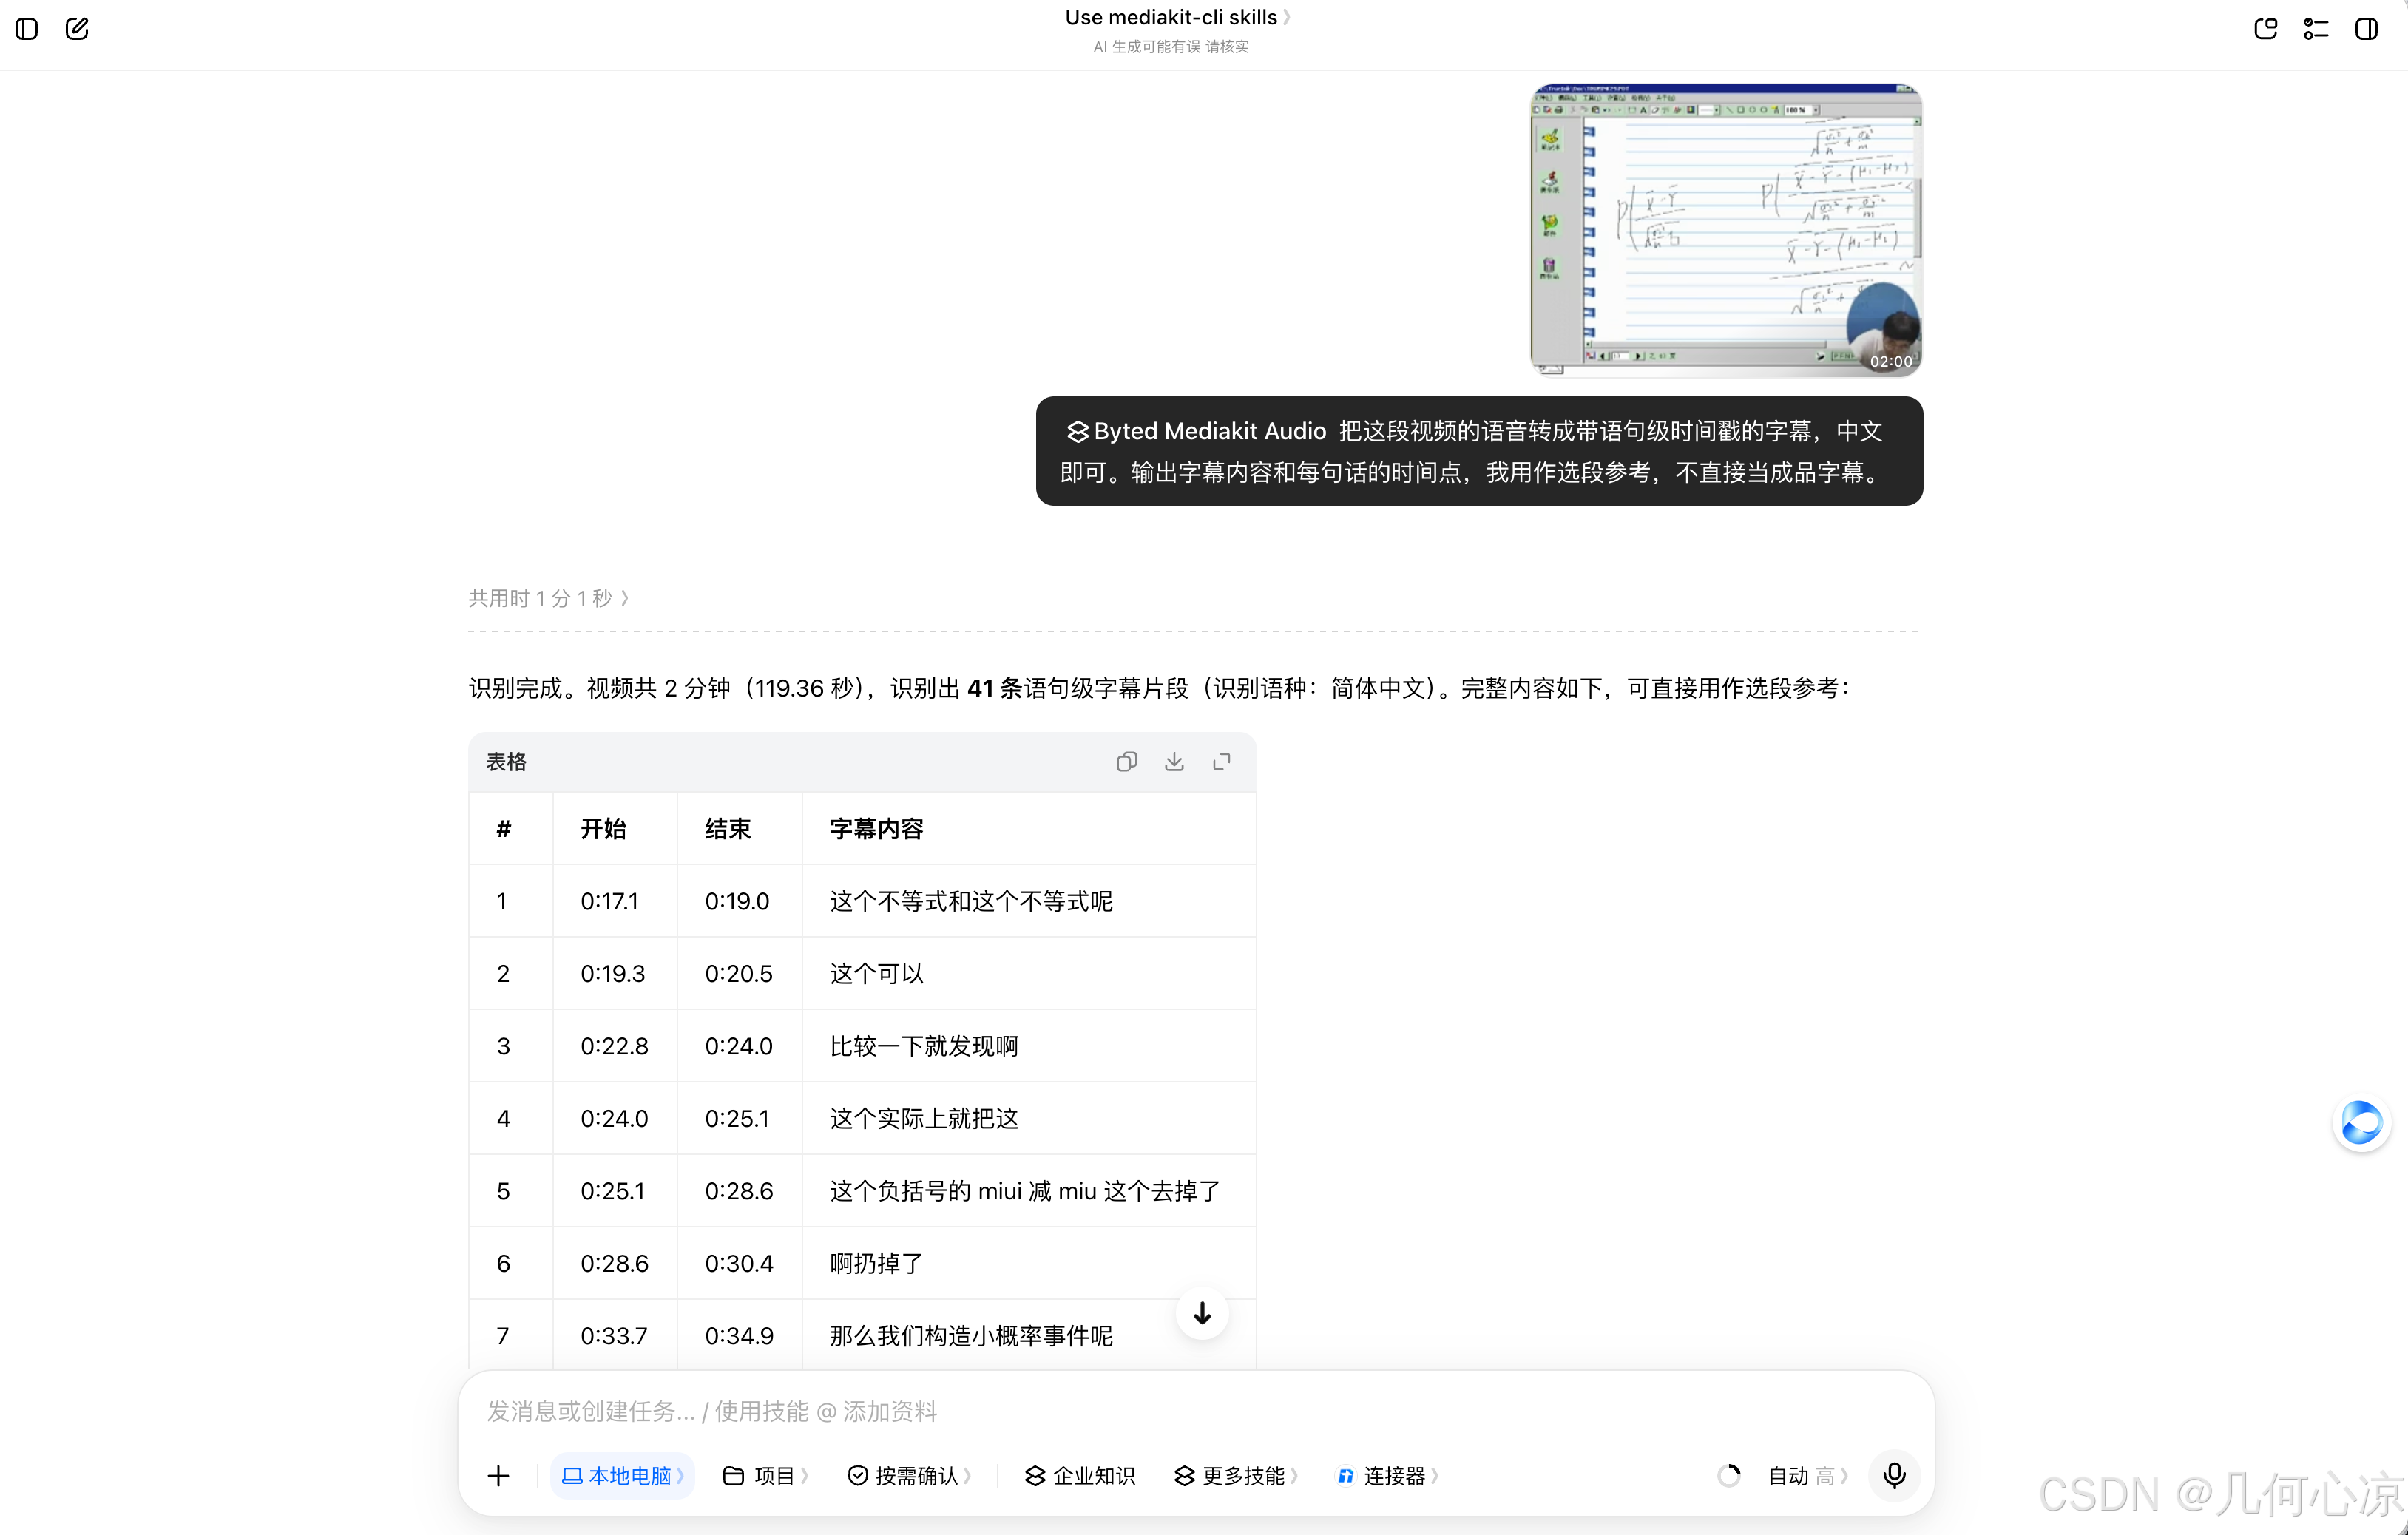
图12 语音转字幕输出摘录(2 分钟高数网课,41 条字幕)
中文授课语音的识别连贯可用,语句级时间戳完整,概念词(“原假设”“小概率事件”)都对了;局限也很典型——希腊字母 μ₁/μ₂ 被音译成了“miui”“mu一”。数理化这类符号密集型内容,ASR 结果适合做选段参考,不适合直接当字幕成品。
6.3 语义切片:使用边界与交付形态
智能语义切片依托多模态能力,结合画面与语音实现语义级切分,交付形态与前两项不同,这里单独说明其使用边界。
实测发现,该能力对输入源有一定要求,使用火山体系内(TOS/VOD/点播)的视频 URL 效果最稳定。走 API 集成的团队,建议将“先上传再调用”写入流程。参数层面,可通过 min_duration 与 max_duration 控制目标时长,切点会自动贴合语义停顿,避免产生无效碎片。
最终交付的是 3 个片段的毫秒级时间轴 JSON,与第 6 章开头的判断一致——它只给选段建议,具体剪片动作交由裁剪能力(或 Agent 自己)完成。这一分工也符合 AI MediaKit Skill的整体设计:语义切片专注内容理解,Agent 按流程调度执行。
七、组合任务:从理解需求到交付成片
单项能力之外,我按一个真实工作流把五个能力串了一遍:“把一段带旧字幕、画质欠佳的素材,整理成可继续编辑的干净短片”。输入是人工合成的 40s 素材(540p、加噪、带硬字幕),流水线完全按 Agent 的执行逻辑串联:
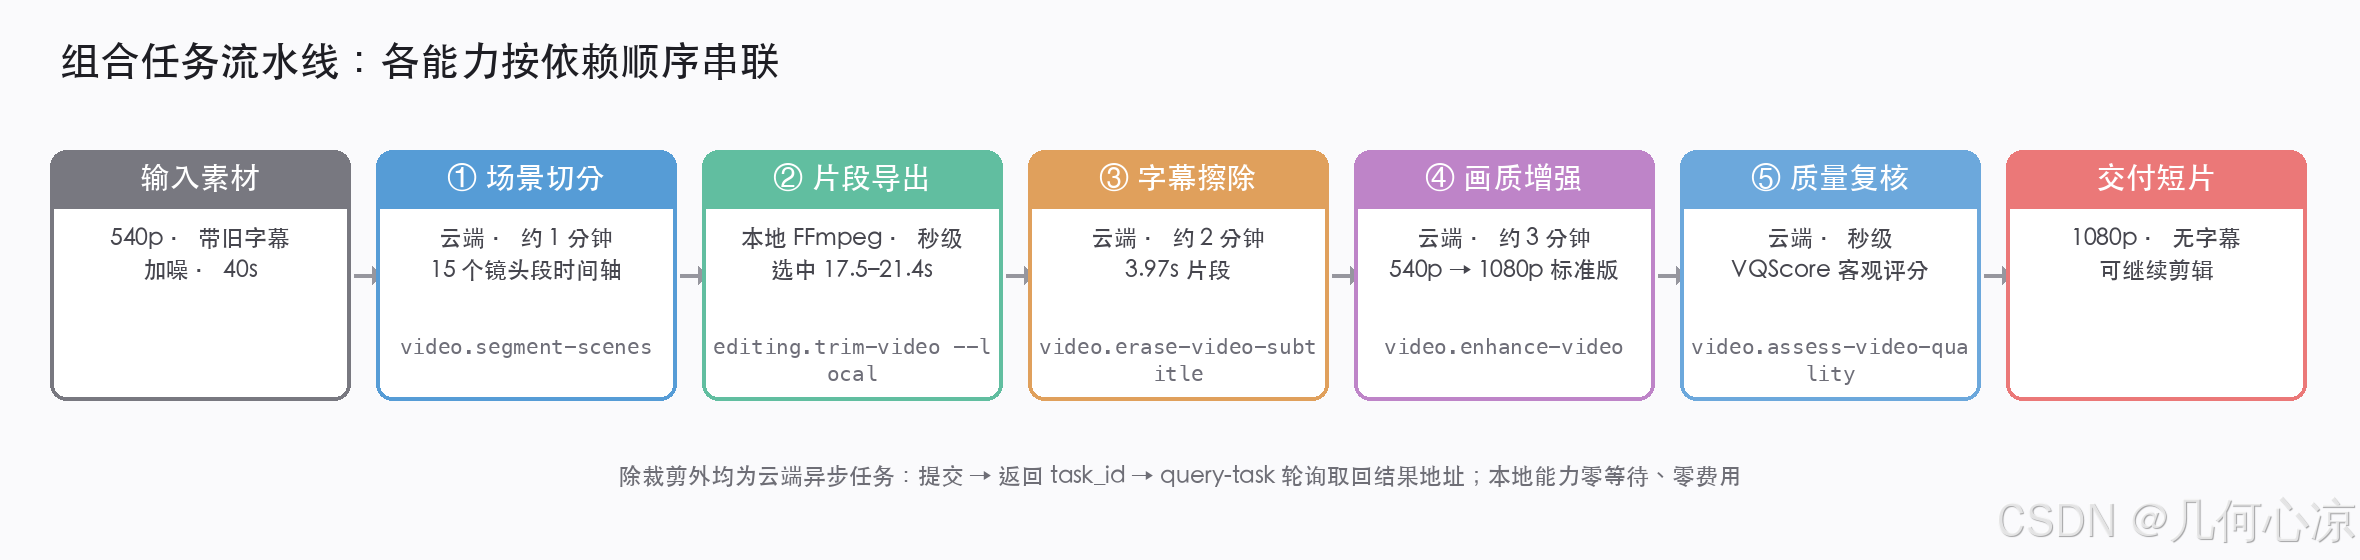
组合任务流水线
图13 组合任务流水线:五步串联,除裁剪外均为云端异步任务
关键节点记录:
| 步骤 | 能力 | 耗时 | 说明 |
| ① 场景切分 | video segment-scenes | <1 分钟 | 15 段时间轴,据此选中 17.5–21.4s |
| ② 片段导出 | editing trim-video --local | 秒级 | 本地 FFmpeg 执行,零费用零等待 |
| ③ 字幕擦除 | video erase-video-subtitle | 约 1 分钟 | 3.97s 片段 |
| ④ 画质增强 | video enhance-video | 约 2 分半 | 540p→1080p 标准版 |
| ⑤ 质量复核 | video assess-video-quality | 秒级 | VQScore 客观评分 |
表2 组合任务各步骤耗时
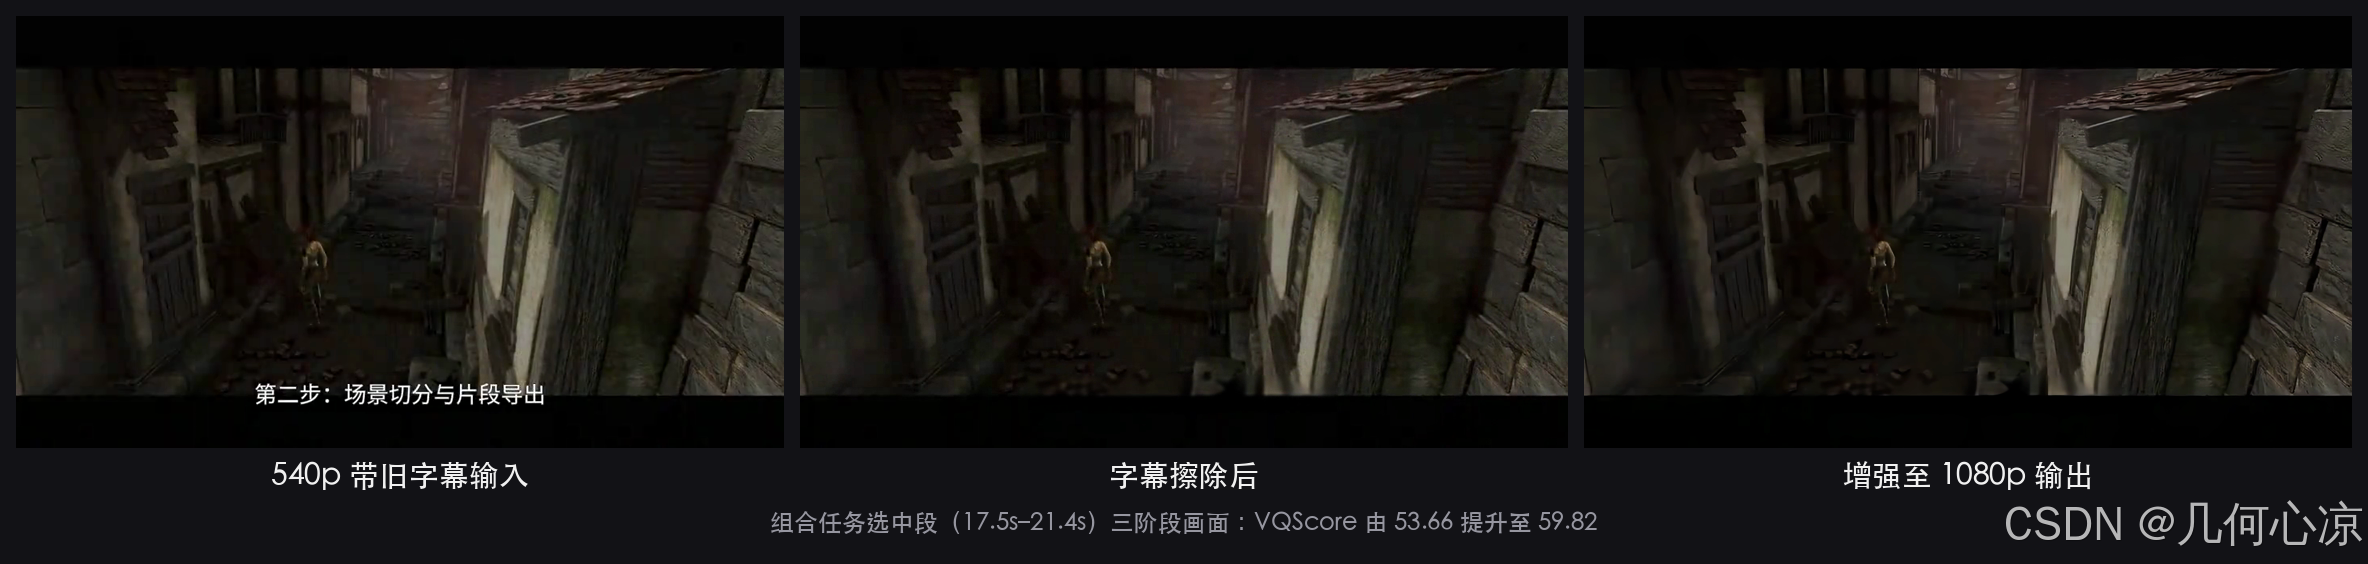
图14 选中段三阶段画面:带字幕 540p → 擦除后 → 增强 1080p
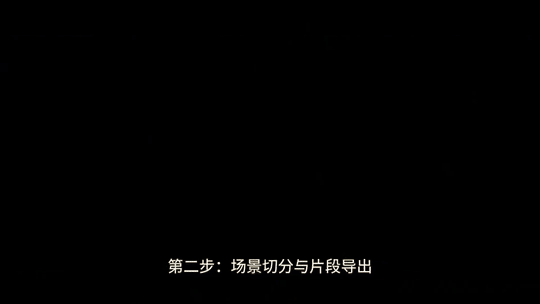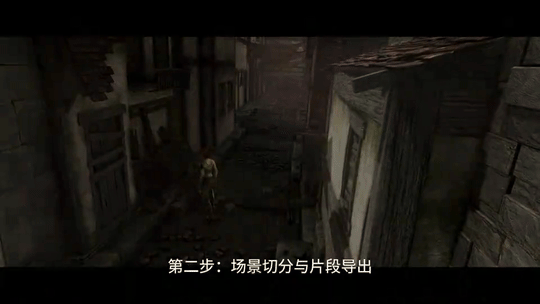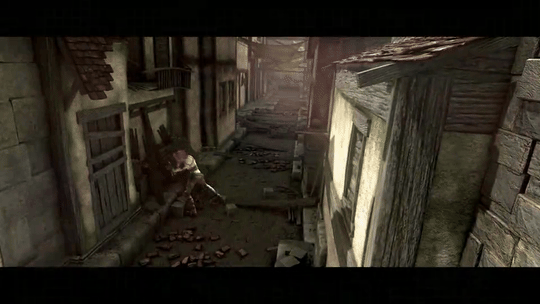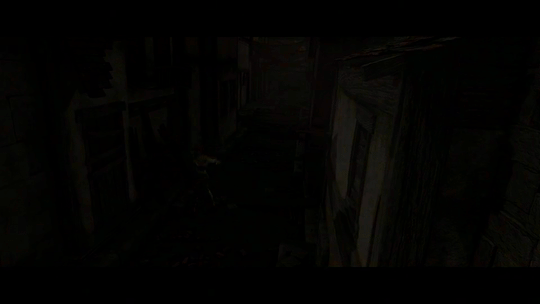
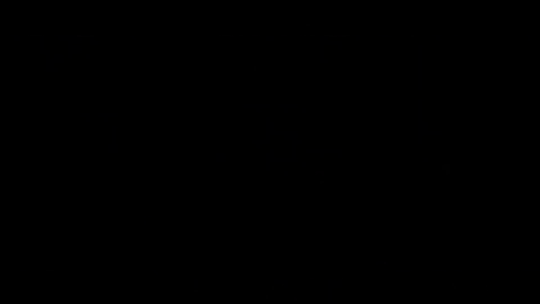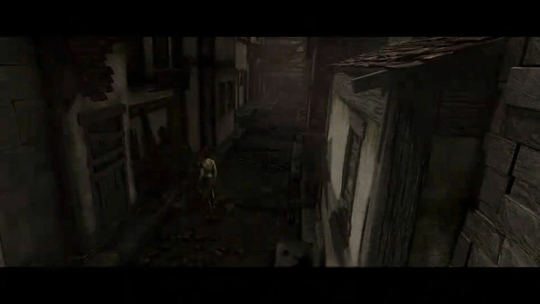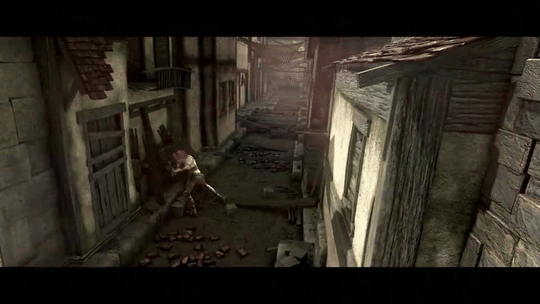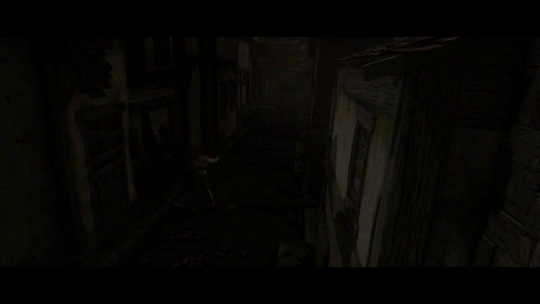
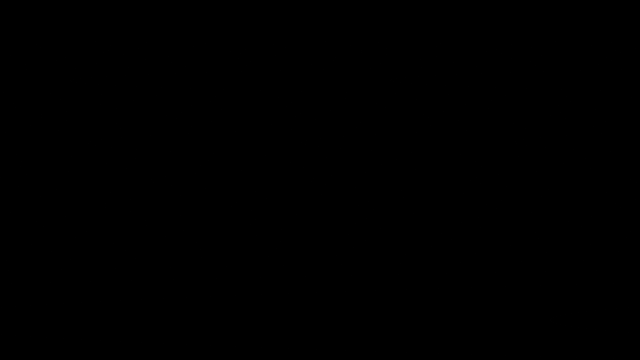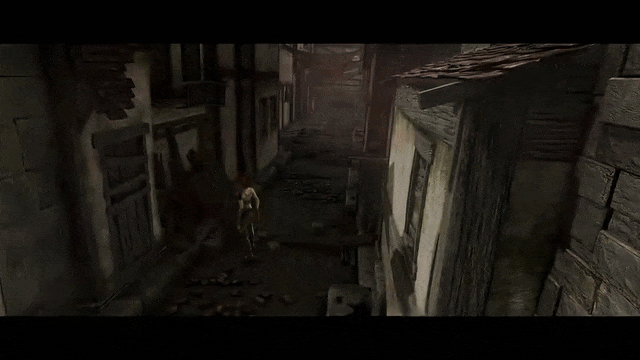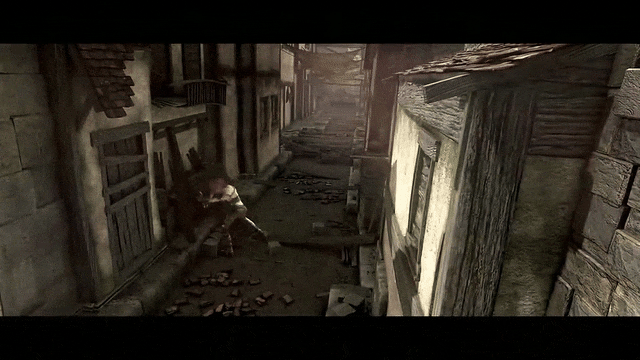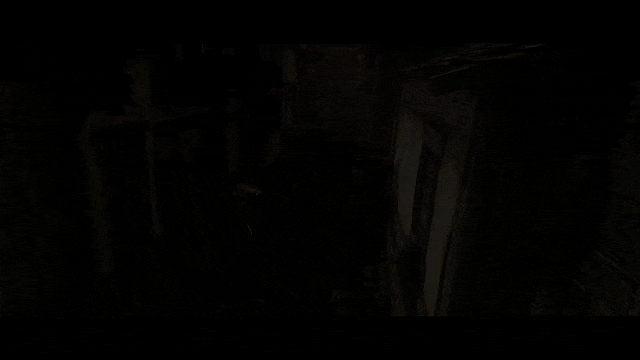
最终交付片段的 VQScore 从输入端的 53.66 提升到 59.82。整条链路跑下来有三个体会:
- 串行依赖是天然的。每步产物是下一步的输入,Agent 的规划能力在这里真实可用——但这也意味着某一步失败(比如第六章那种拉取失败)会让整条链停摆,编排时最好带上失败重试与人工确认节点。
- 本地/云端混合调度很省钱。裁剪这种确定性操作走本地 FFmpeg 秒级完成且不计费,只有真正需要 AI 的步骤才上云。Agent 默认就会这么选路,不用人教。
- 结束前有客观质检兜底。用 VQScore 给成品打分再交付,比“看起来还行”可靠得多,这一步几乎没有成本,建议固化为流程动作。
全程总耗时约 6 分钟(含云端等待与中间产物下载),按公示价折算处理成本约 0.3 元。
八、总结与建议
8.1 总体评价
把一开始我对它的疑问逐个回收:
对 Agent 的友好度:合格偏优秀。 一条命令安装、五个技能包即插即用、自然语言直接驱动;统一的异步任务模型让长任务可以“提交后挂起、阶段性汇报、完成后续接”,这是为 Agent 场景认真设计过的形态,不是简单包装 API。
三项核心能力的实测水位:
| 能力 | 实测结论 | 一句话建议 |
| 画质增强 | VQScore +6.9(标准)/ +11.4(大模型),恢复而非超越 | 老素材修复、低清提档直接用;标准版性价比最高 |
| 字幕擦除 | 常规场景近乎完美;文字即内容的画面会误伤 | 短剧/搬运去字可全托管,板书文档类需人工验收 |
| 智能剪辑 | 切分/选段交付时间轴,成片类能力另算;语义切片有输入源限制 | 当“剪辑决策助手”用,别当“代剪”用 |
本次实测总花费约 4 元(含故意跑失败的任务;毫秒级计费,以实际账单为准),试错成本非常低。
8.2 适配场景建议
- 短视频/MCN 团队:去字幕、增强、拆条是高频刚需,Agent 化后可以把“SOP 话术”直接变成可执行流水线,推荐;
- 影视二创/老片修复:增强与擦除质量过关,建议“AI 初处理 + 人工精修”两段式;
- 教育/知识类内容:录屏类素材推荐走ASR+语义选段路线,更适配内容结构;
- 强合规/内容保真场景:推荐使用标准版处理,并保留原片。
AI MediaKit Skill 让我印象最深的不是某个单项能力多惊艳,而是它把视频处理变成了一种可以“说清楚就做完”的事。当 Agent 既听得懂“把这段素材的字幕去了再拉高清”,又真的握着能完成它的工具时,视频后处理这条流水线上的人肉环节,就确实可以开始退场了。

火山引擎视频云技术社区,是面向 AI 音视频开发者的技术交流平台。这里汇聚源自抖音、豆包等亿级 DAU 产品的 RTC、直播、点播、AI 媒体处理、音视频互动技术,提供接入指南、最佳实践、性能调优、场景案例、Demo 代码、开源项目、白皮书和 API 文档。社区汇聚官方工程师与一线开发者,为 AI 视频通话、数字人、AI 视频处理等应用的开发与落地提供技术支持。
更多推荐
 56
 0
- 0


 已为社区贡献1条内容

所有评论(0)